reasoning_effort 是什麼:同一顆模型的五種思考預算
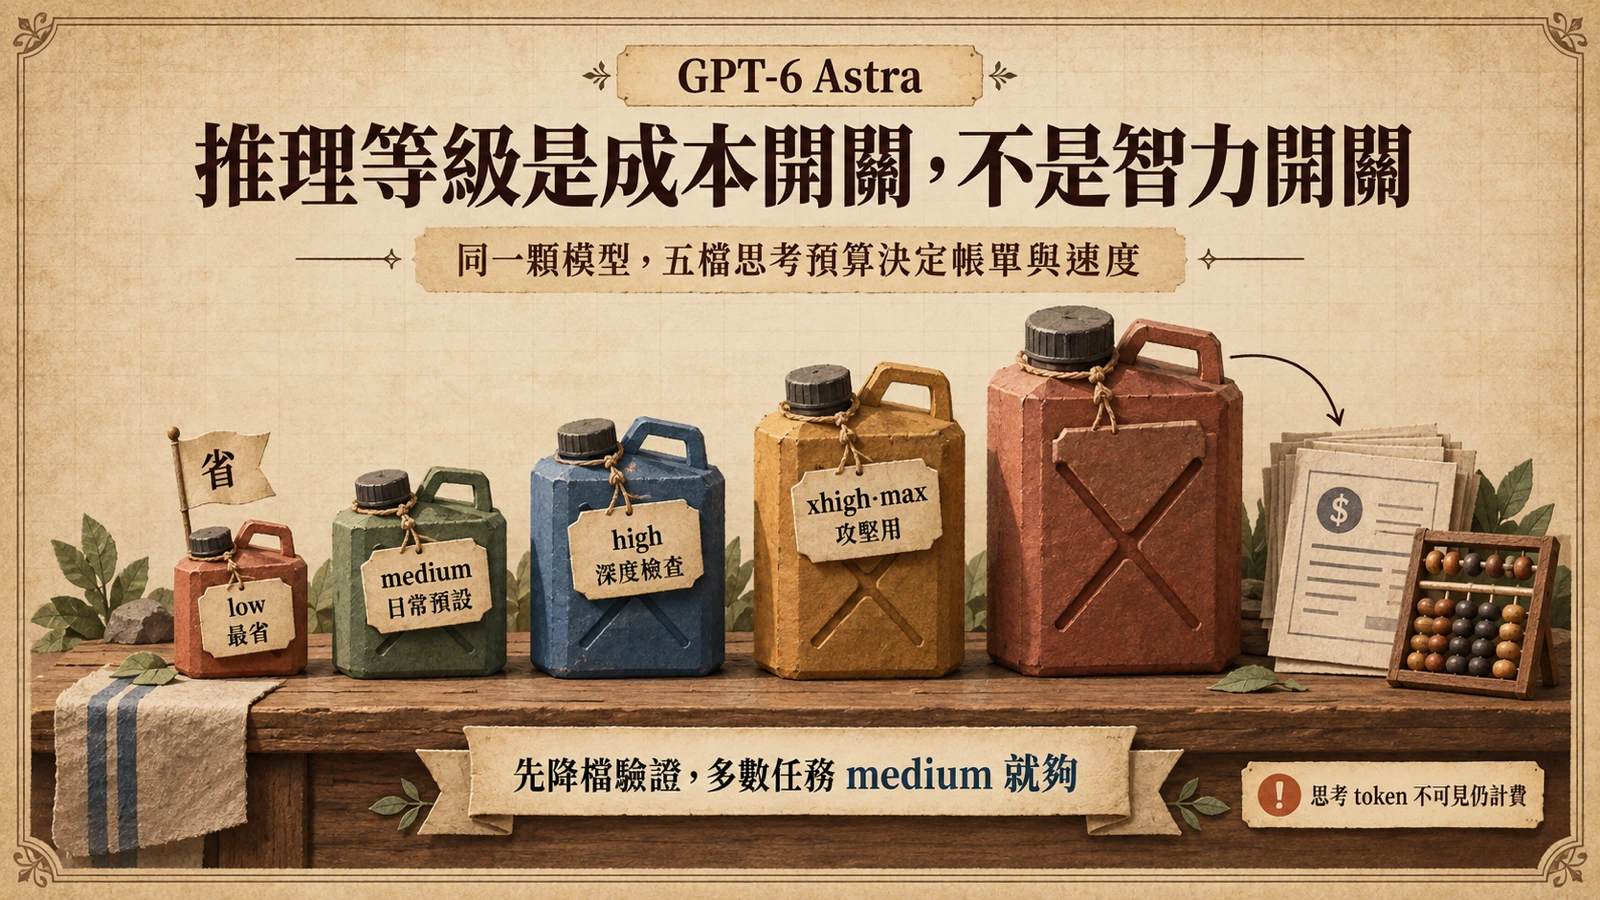
拿到 GPT-6 Astra 的第一件事,往往不是寫 prompt,而是決定要讓它「想多久」。微軟 Azure 的官方文件給出最直白的定義:這個參數控制模型在回答之前先思考多少。換句話說,reasoning effort 不是在挑不同的模型,而是在同一顆 gpt-6-astra 上分配不同的思考預算——預算給得多,模型在提出答案前會展開更長的內部推理;預算給得少,它就想快一點、答短一點。
在 OpenAI 的模型索引上,GPT-6 Astra 被放在「最強模型、為最困難的端到端工作而生」的位置,但這不代表每次呼叫都要用最高強度。它的推理等級落在 low、medium、high、xhigh、max 五檔;值得特別注意的是,官方遷移指引明確表示:過去使用 none 或 minimal 的流程,應改從 low 開始對照結果——Astra 已不再提供「完全不思考」的選項。
從 low 到 max:五個檔位各自的位置
五個檔位可以理解成同一條思考時間軸上的五個刻度。
low 是最輕的一檔:回答快、思考 token 少,適合本來就容易驗證的工作,例如摘要、格式轉換、分類、改寫。medium 是多數工作的平衡點:OpenAI 前一代的 GPT-5.6 Luna 便把 medium 設為預設值,代理式工作與編碼從這裡出發通常不吃虧。high 會在回答前做更多自我檢查,適合多步驟推理、需要反覆驗算的任務。
xhigh 與 max 是上層的攻堅檔位。Azure 文件特別註明 xhigh 僅限 GPT-6、GPT-5.6 等較新的模型使用,舊模型不支援。這兩檔留給真正難啃的端到端工作——長鏈工具呼叫、複雜除錯、跨文件研究——它們換來的深度,代價是更長的等待與更厚的帳單。
為什麼等級直接決定帳單:思考 token 的計費機制
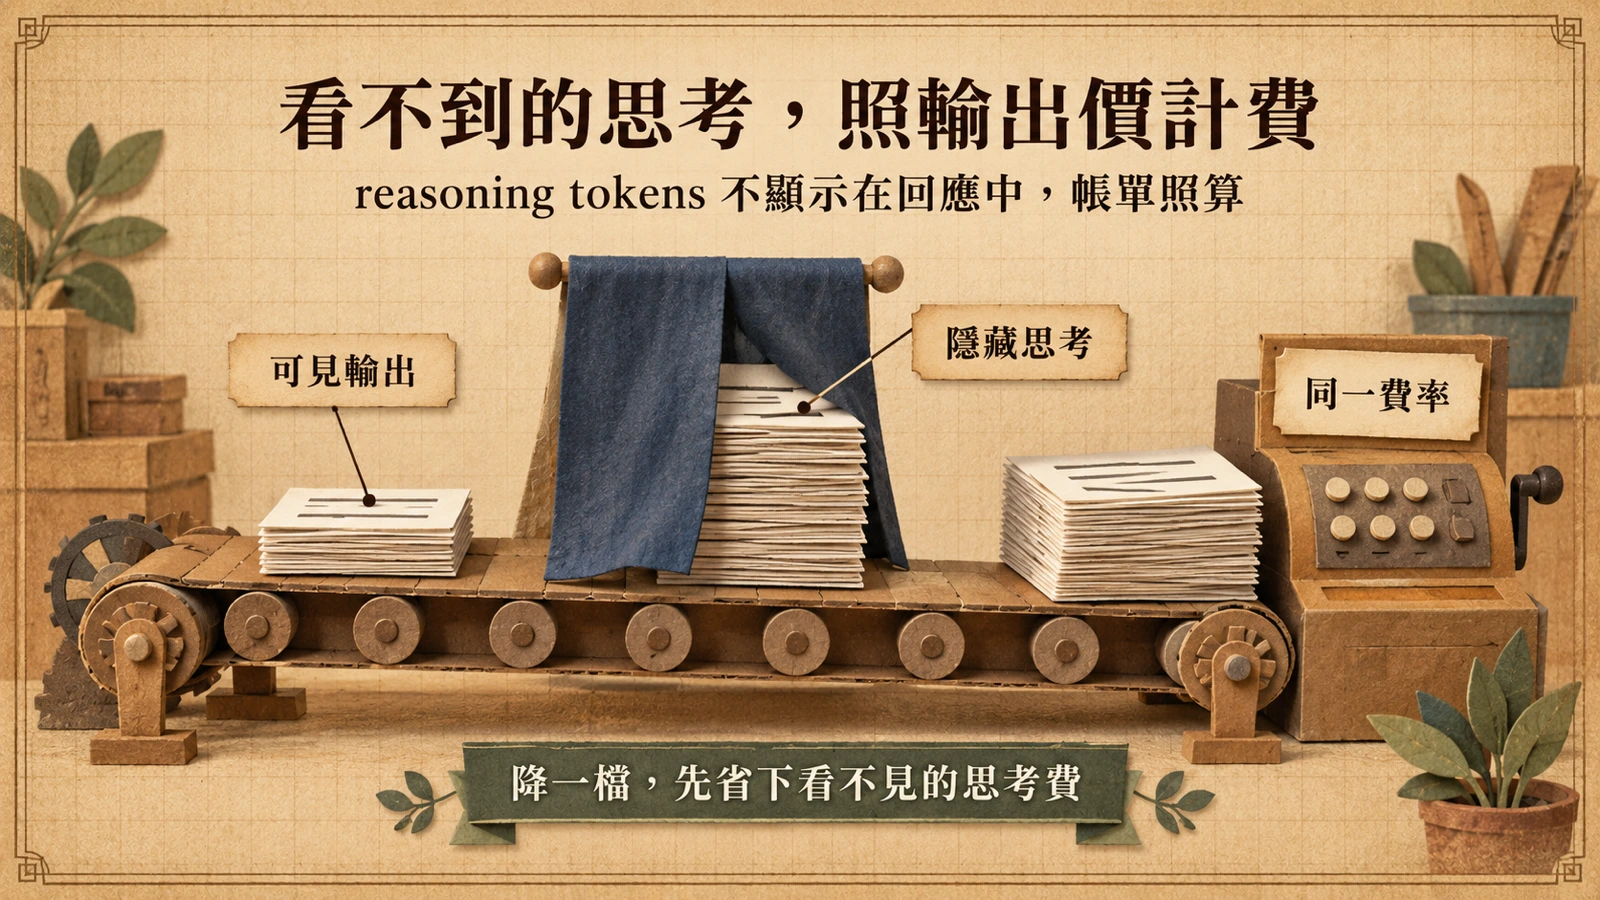
推理等級為什麼直接反映在費用上?關鍵在 reasoning tokens 的計費方式。模型在給出最終答案前生成的內部思考,不會顯示在 API 回應內容裡,但官方推理指南說明這些 token 一樣要管理、一樣要計費。檔位開得越高,這段看不見的思考就越長,而它落在帳單上時,走的是輸出側的單價。
GPT-6 Astra 的官方價目表以每百萬 token 計價:輸入 10 美元、輸出 50 美元、快取後的輸入降到 1 美元,表上另列批次與優先處理的專屬價格。把兩件事放在一起看就明白:推理等級每往上調一檔,新增的思考 token 幾乎全部按輸出單價計費。一份簡短的可見回答,背後可能是一段更長的隱藏思考——降檔省下來的,往往不是你看到的那段輸出,而是這疊看不見的推理。
選級決策:依任務型態對號入座
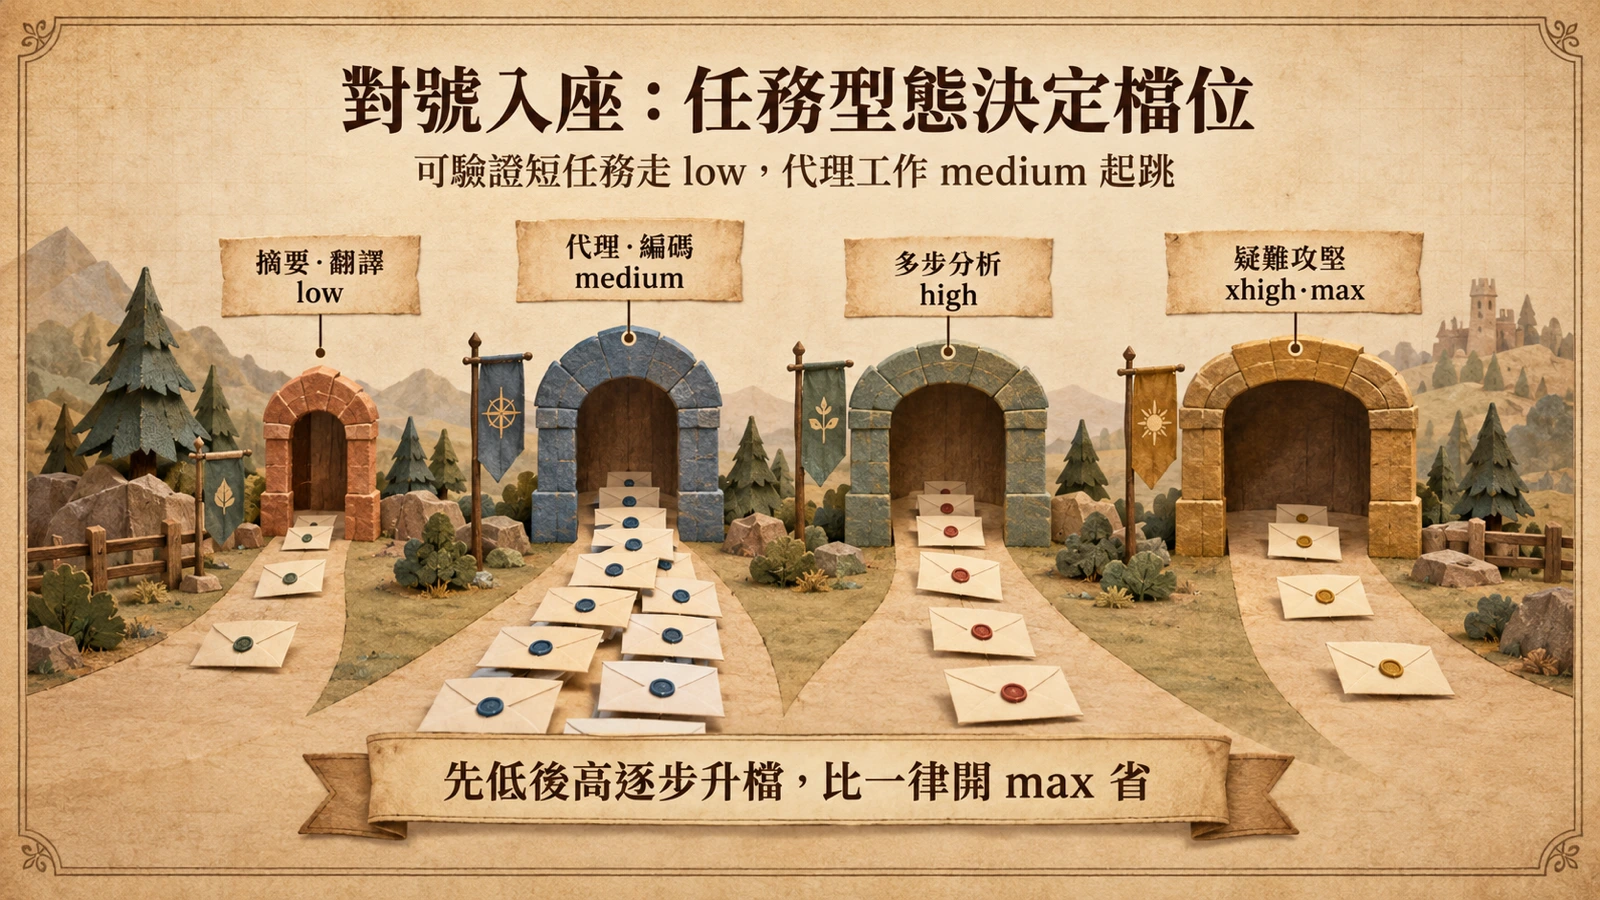
實務上選級不必每次憑感覺,可以按三個問題路由:任務好不好驗證、答錯的代價多高、需要來回幾輪。
好驗證、單輪就能判斷對錯的工作(翻譯、抽取、摘要、格式化)放 low:輸出短、思考短,錯了重跑的成本也低。代理與編碼工作以 medium 為基準:工具呼叫需要一定的規劃深度,但多數步驟本身並不艱深。需要多步推理、跨段落一致性或自我覆核的分析工作,high 的自我檢查能換來可見的品質。真正的疑難——大型重構的取捨、難以重現的 bug、跨大量文件的研究——才值得動用 xhigh 或 max。
| 任務型態 | 建議起點 | 為什麼 |
|---|---|---|
| 摘要、翻譯、抽取、格式轉換 | low | 單輪就能驗證對錯,重跑一次遠比多想一圈便宜 |
| 代理工作流、工具呼叫、編碼迭代 | medium | 需要規劃深度,但多數步驟不艱深;也是前代的預設值 |
| 多步分析、跨段落一致性、自我覆核 | high | 錯誤代價高,值得讓模型先自我檢查再作答 |
| 大型重構取捨、難以重現的除錯、跨文件研究 | xhigh/max | 端到端難題,用更長思考換一次成功率 |
另一個實用的節奏是「先低後高」:先用 low 產出草稿或定位問題,品質不足再升檔重試。與其每個請求一律開最高檔,不如把高檔位留給已證明低檔解不掉的少數難題——這正是思考預算概念的本意。
與前代的差異:none 消失、xhigh 成為新常態
把時間軸往回拉,GPT-5.6 世代的 Luna 支援值從 none 一路排到 max(none、low、medium、high、xhigh、max),涵蓋「完全不思考」到「全力思考」的完整光譜。Astra 把最下面的 none(以及部分模型的 minimal)收掉,遷移指引直接建議這類流程改用 low 對照。這個變化的含義是:思考不再是可完全關閉的開關,成本管理的重心從「要不要想」移到「想多少才夠」。
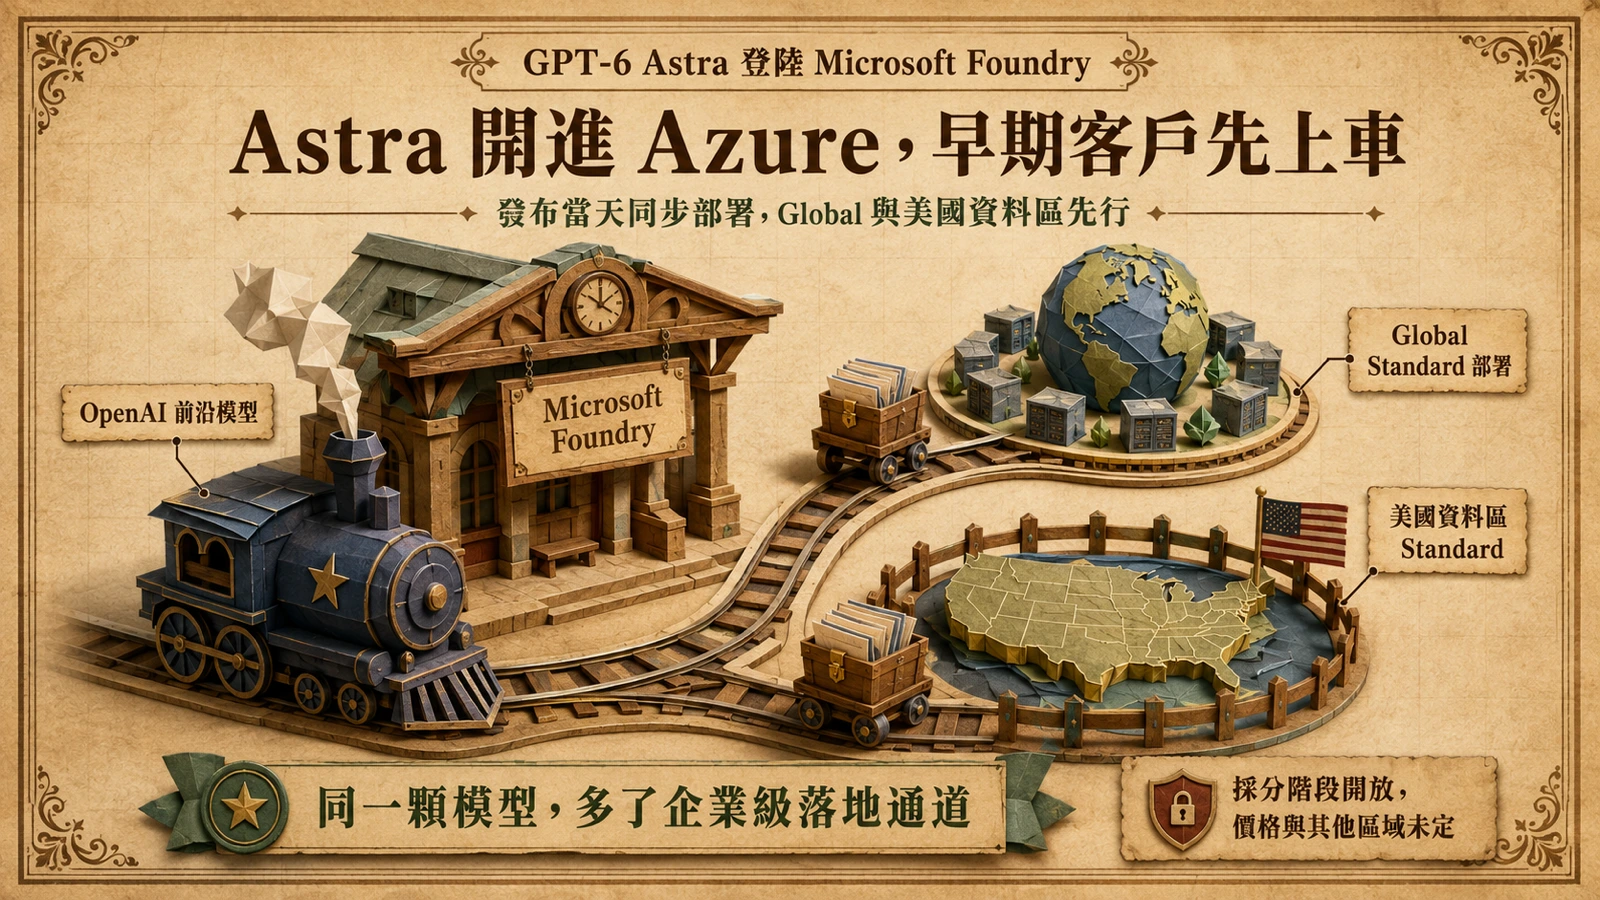
往上端看,xhigh 與 max 成為新世代模型的標配上限,Azure 端使用同名參數、語意一致,差別只在部署與計費掛在哪個平台。Astra 於 2026 年 9 月 3 日發布當天便開進 Azure 的 Microsoft Foundry,目前可經 OpenAI API 與 Azure 等通道取用,分階段開放的細節我們先前已整理過。
壓低成本的三個槓桿:等級之外還有什麼
調對檔位是第一步,還有三個槓桿可以再壓成本。
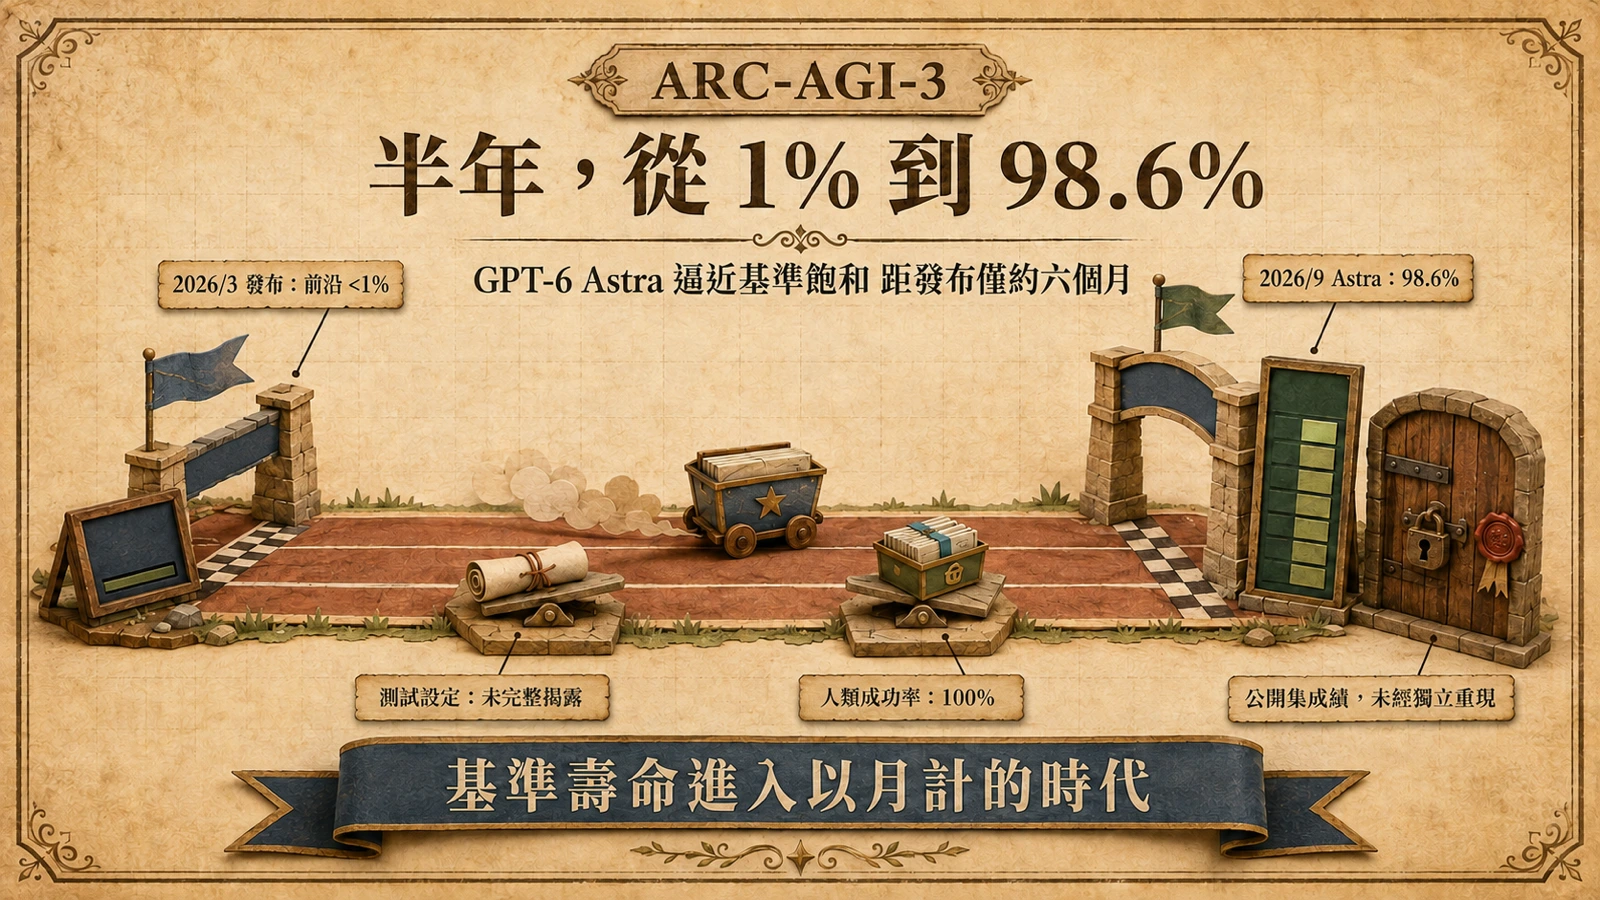
第一是快取輸入。輸入單價 10 美元、快取命中後 1 美元,相差十倍;多輪代理工作把系統提示、工具定義與固定前綴放在相同位置,讓每一輪都命中快取,長 session 的成本結構會完全不同。第二是按延遲需求分流:延遲不敏感的大量背景工作改走價目表上的批次欄位,需要保證吞吐的關鍵路徑才用優先處理。第三是脈絡工程:長程任務用保留推理與脈絡壓縮的組合,讓模型記得住、也放得下——這兩個設定的威力,在 ARC-AGI-3 上的官方前後對照可以差到近三倍,值得長程工作流借鏡。
三個槓桿之上還需要量測。reasoning tokens 既然不可見,就把每個任務的總輸出量(含思考)當代理指標:同一批任務分別用兩個檔位各跑一輪,比較完成率與總 token,幾輪之後就會得到屬於自己工作流的「檔位成本表」。這張表比任何第三方評測都可靠,因為它量的是你的任務、你的提示詞結構。
限制與後續追蹤
這套選級原則也有邊界。官方目前沒有發布「各檔位對應品質提升幅度」的完整對照,第三方每任務成本的實測數字也因任務組成而差異極大,引用他人結論前,先問任務型態是否相近。reasoning tokens 在回應內容中不可見,精確的成本歸因只能靠 usage 統計與前後對照,無法逐條審計。另外,ChatGPT 介面上的思考選項與 API 的檔位值不必然同名——網路教學裡流傳的「Ultra」等俗稱並不是 API 值,串接時一律以官方文件列舉的值為準。
後續值得追蹤三件事:OpenAI 是否釋出官方的每檔位建議與成本對照、Azure 各資料區的開放節奏,以及獨立評測的每任務成本數據何時涵蓋全部五檔。在那之前,最穩的做法仍是拿自己的任務集,從 medium 開始往兩側試。