模型 / MODELS新聞 / NEWS
DeepSeek V4.1-Flash 發布:讀用 8B、寫用 16B 的非對稱新架構
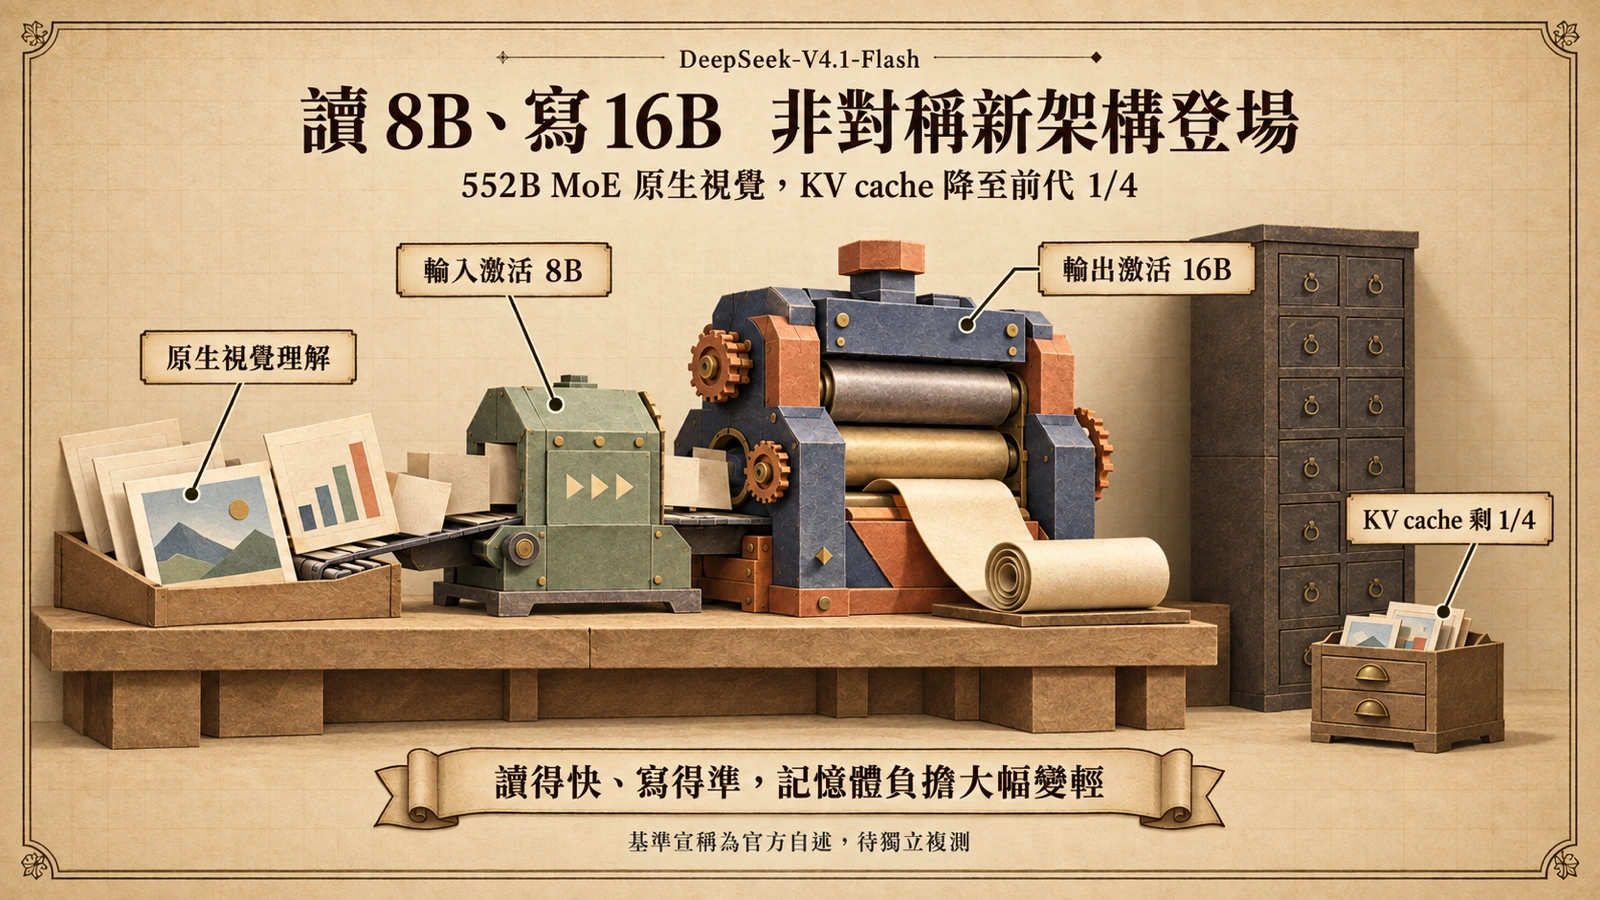
DeepSeek 發布 V4.1-Flash:552B MoE 採 Causal Encoder-Decoder 新架構並具原生視覺理解,輸入激活 8B、輸出激活 16B,KV cache 降至前代 HBM 的 1/4。
MoE(混合專家)架構:參數規模與推理成本之間的取捨實作。
共 4 則文章,依發布時間排序
DeepSeek 發布 V4.1-Flash:552B MoE 採 Causal Encoder-Decoder 新架構並具原生視覺理解,輸入激活 8B、輸出激活 16B,KV cache 降至前代 HBM 的 1/4。
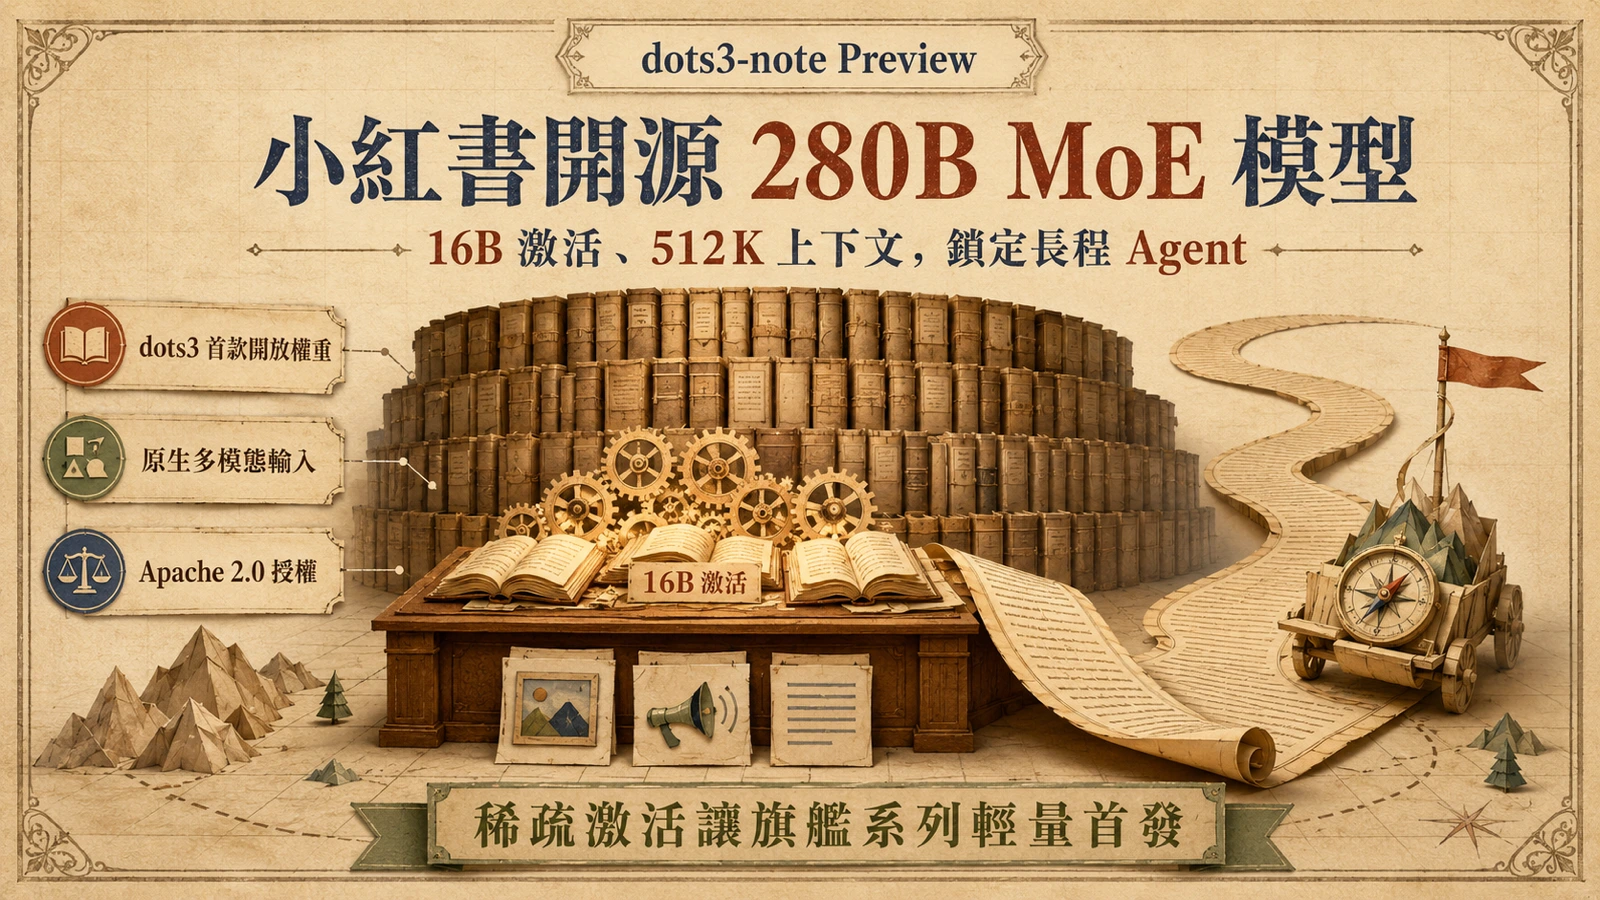
小紅書 Dots Studio 釋出 dots3 家族首款開放權重模型 dots3-note Preview:280B 總參數 MoE、16B 激活、512K 上下文,採 Apache 2.0 授權,主打長程 Agent 與多模態推理。
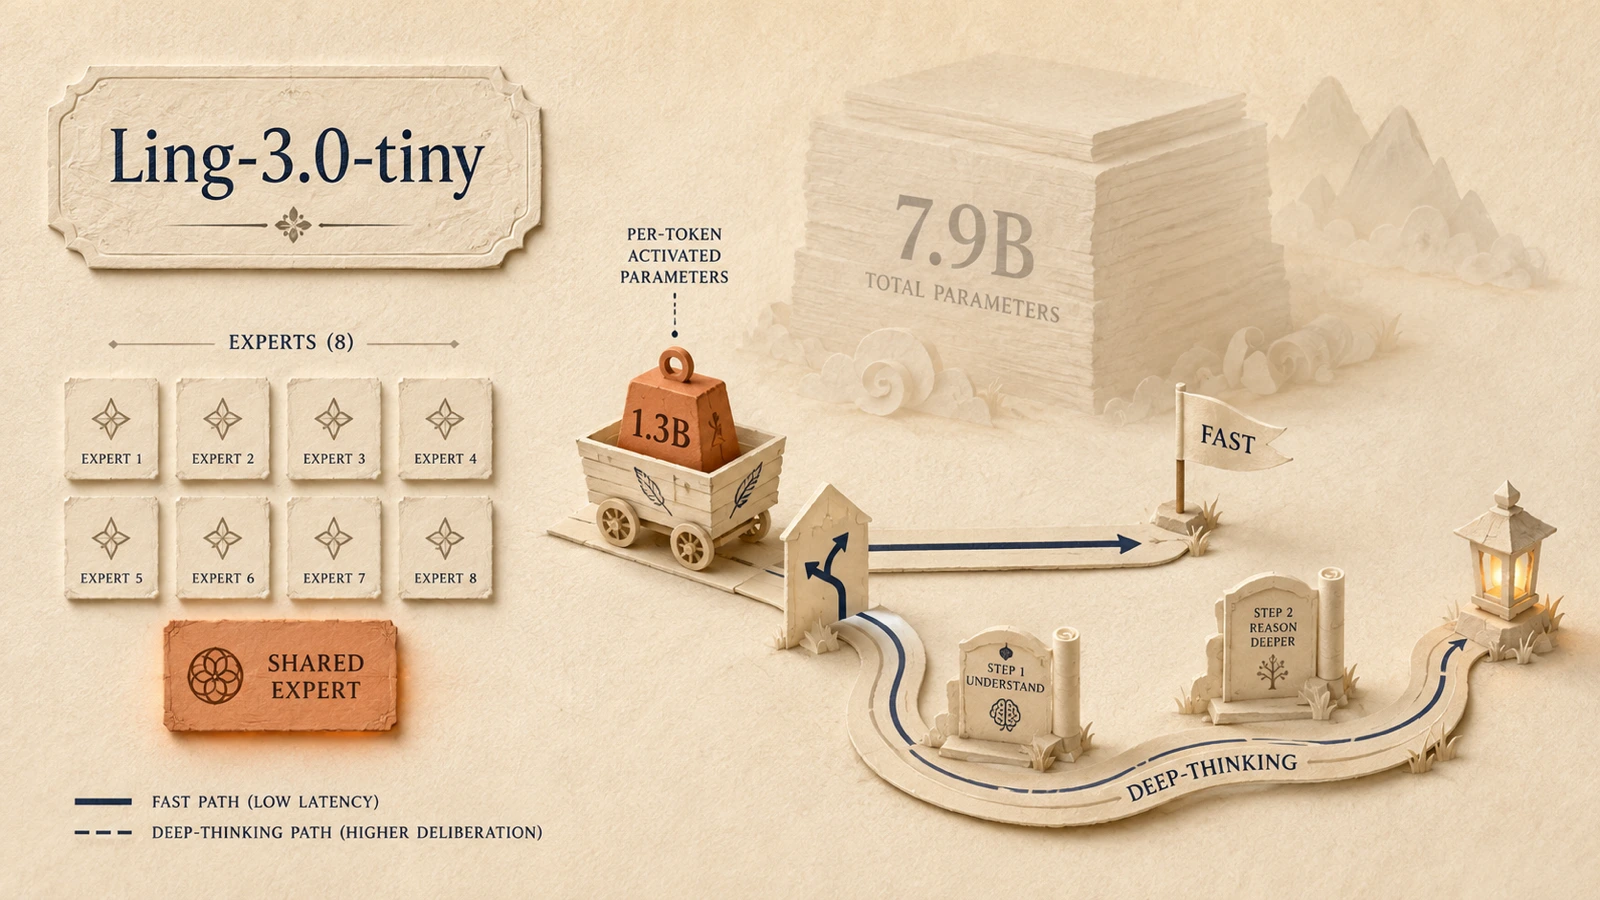
螞蟻集團 InclusionAI 開源 Ling-3.0-tiny,總參 7.9B、每 token 僅激活 1.3B 的原生混合推理 MoE,同步提供 BF16、FP8、INT4 三種權重,INT4 版本利於消費級硬體部署。
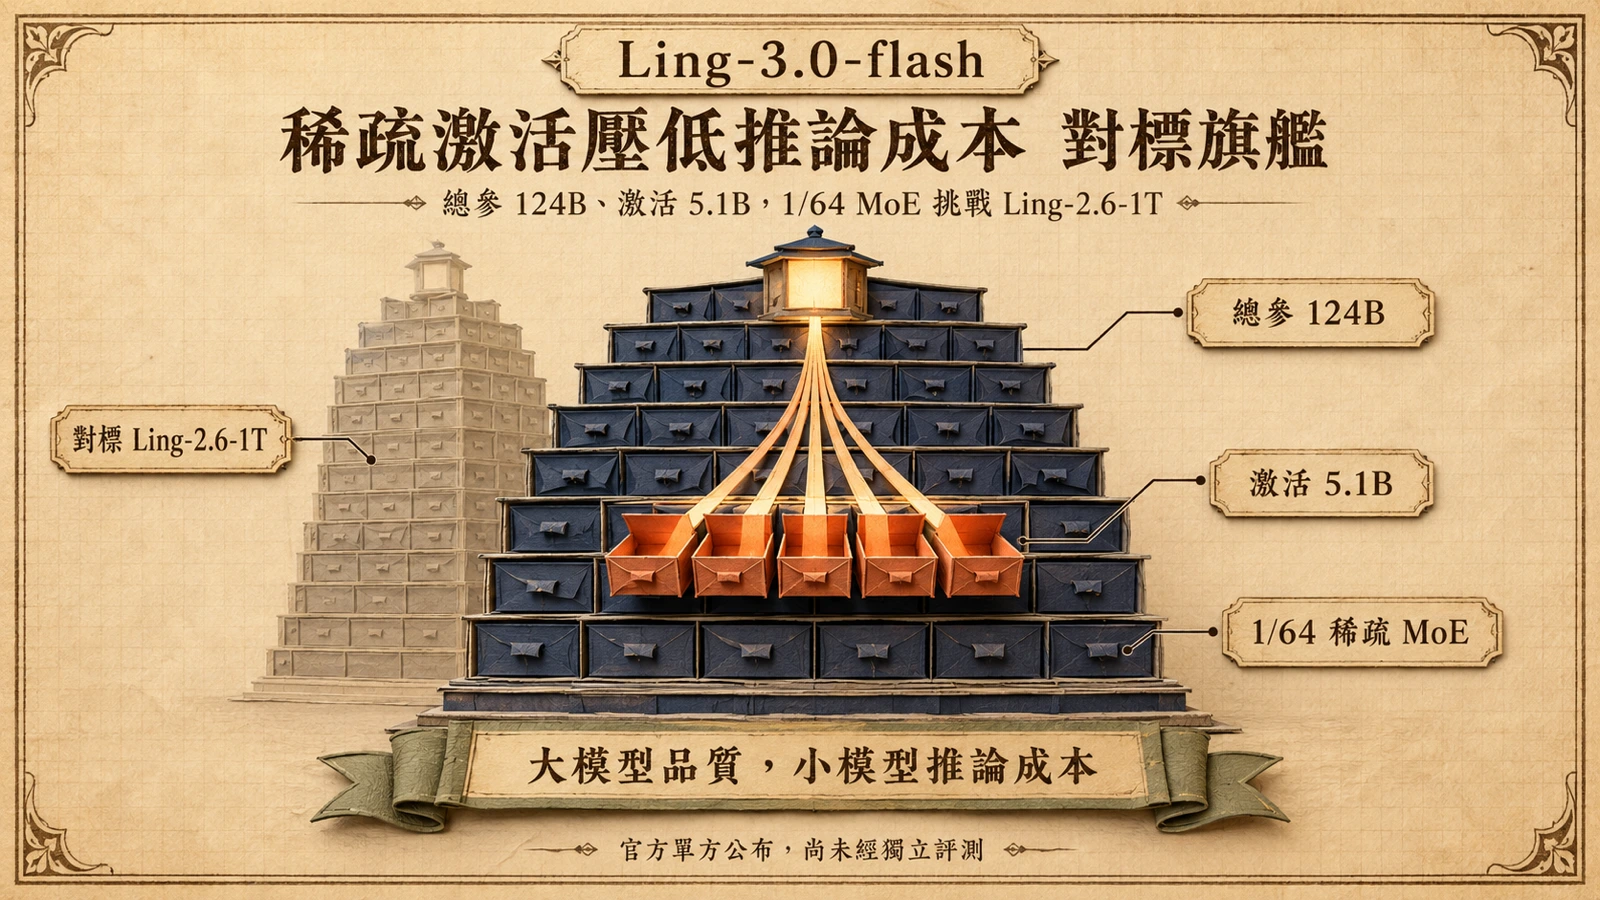
Ant Group 旗下 InclusionAI 發布 Ling-3.0-flash 原生混合推理模型,總參 124B、激活 5.1B,採稀疏 MoE 與混合線性注意力,官方宣稱對標上一代 1T 旗艦並將開源。