一份橫跨七大危害領域的濫用總整理
9 月 10 日,Anthropic 發布《Detecting and countering misuse of AI: September 2026》。報告官方頁面載明,文件整理的是 2025 年 12 月至 2026 年 8 月間該公司偵測並阻斷的活動,橫跨網路行動、影響力行動、監控、生物濫用與武器製作等七大危害領域。這個系列並非頭一遭——Anthropic 在 2025 年 3 月與 8 月都發布過同類報告——但這次把八個月累積的案例整理成有系統的威脅情報文件,也被廣泛視為系列中範圍最廣、細節最完整的一次:誰在濫用 Claude、用了什麼手法、Anthropic 的威脅情報團隊如何發現並阻斷。
在這批被阻斷的案例中,疑似與俄羅斯有關的網路間諜行動是外媒報導矚目的焦點之一,但整份報告中篇幅最大、也在產業間引起最大震動的,其實是模型蒸餾相關的章節——Anthropic 首次以威脅情報的規格,系統性描述自家模型的能力如何被他人萃取。
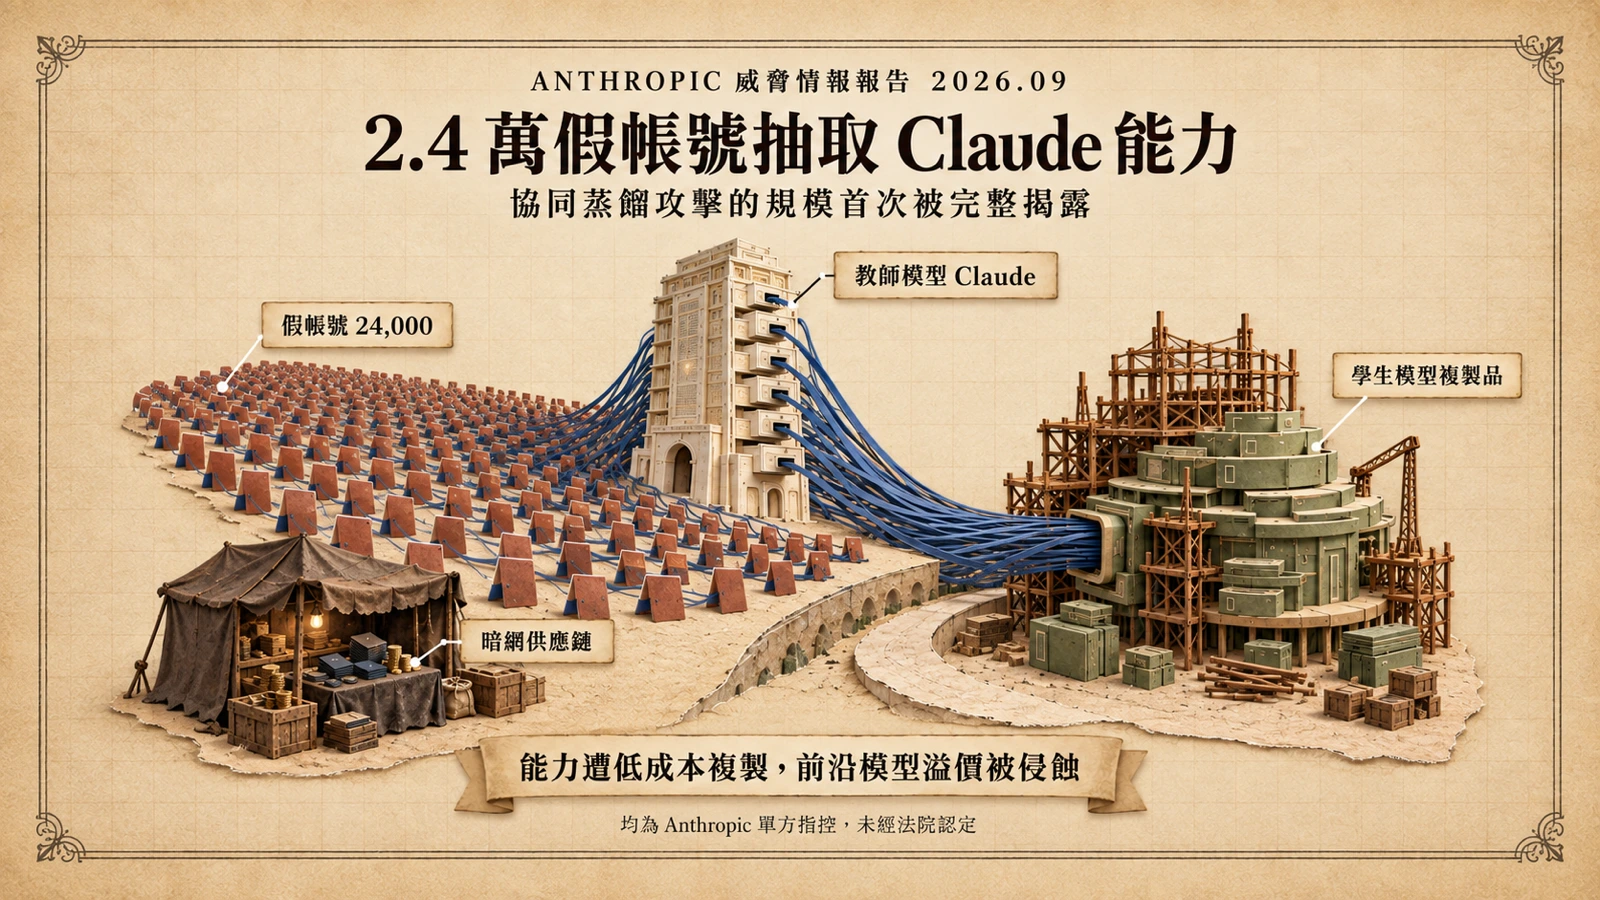
蒸餾攻擊的規模:2.4 萬個假帳號
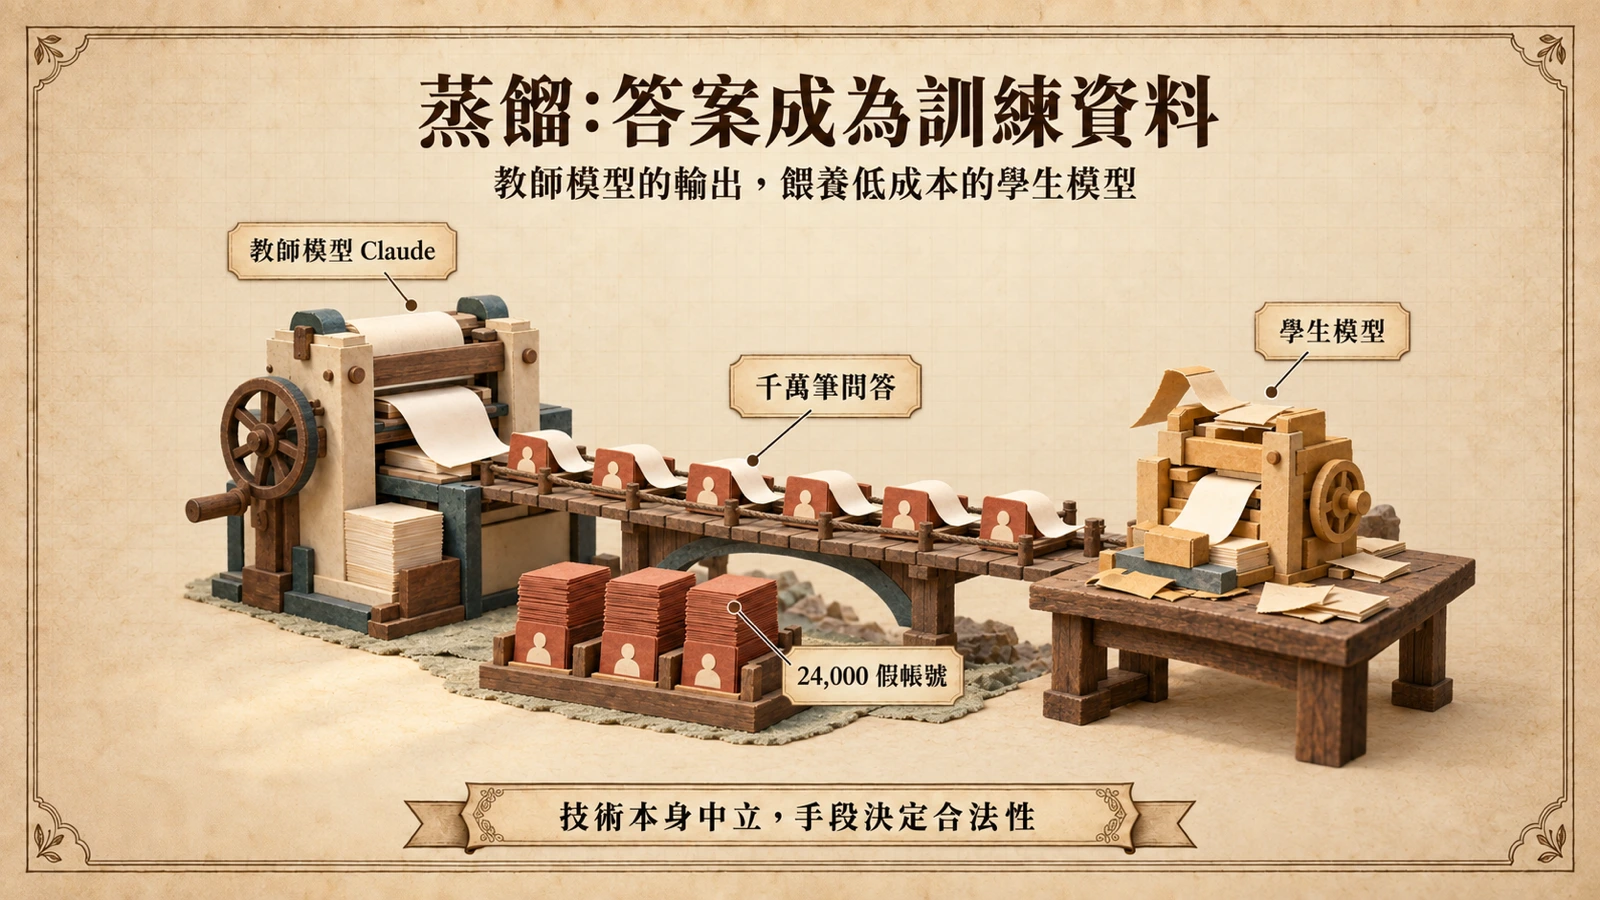
模型蒸餾(distillation)本身是正統的機器學習技術:讓強大的「教師模型」產生大量高品質問答,再用這些資料訓練規模更小、成本更低的「學生模型」。爭議從來不在技術,而在取得資料的手段——Anthropic 的使用條款禁止以 Claude 的輸出訓練競爭模型,當有人繞過付費與條款、大規模萃取輸出時,該公司將其定性為「蒸餾攻擊」。
在官方部落格中,Anthropic 表示已識別出利用約 24,000 個詐欺帳號發動的協同蒸餾攻擊,目的正是萃取 Claude 的能力。外媒先前引述 Anthropic 威脅情報團隊的說明,描繪了這條供應鏈的樣貌:暗網上存在買賣遭竊信用卡與被入侵 AI 帳號的完整生態,操作者註冊大量假帳號,單一帳號在短時間內提出遠超一般人使用強度的問題,答案蒐集完再供訓練使用;平台端則陷入不斷封鎖、對手不斷重開帳號的消耗戰。行為模式的對比是偵測的關鍵:一般使用者一天提問數十次已屬高頻,蒸餾操作的特徵是單一帳號提出數千個高度結構化的問題、並同時操作大量帳號。對防禦方而言,可用的訊號也因此在帳號行為層:提問量、提問結構與付費方式的異常,比內容本身更容易暴露自動化萃取。
最不尋常的指控:用戶以為在跟 Kimi 對話,回應卻來自 Claude
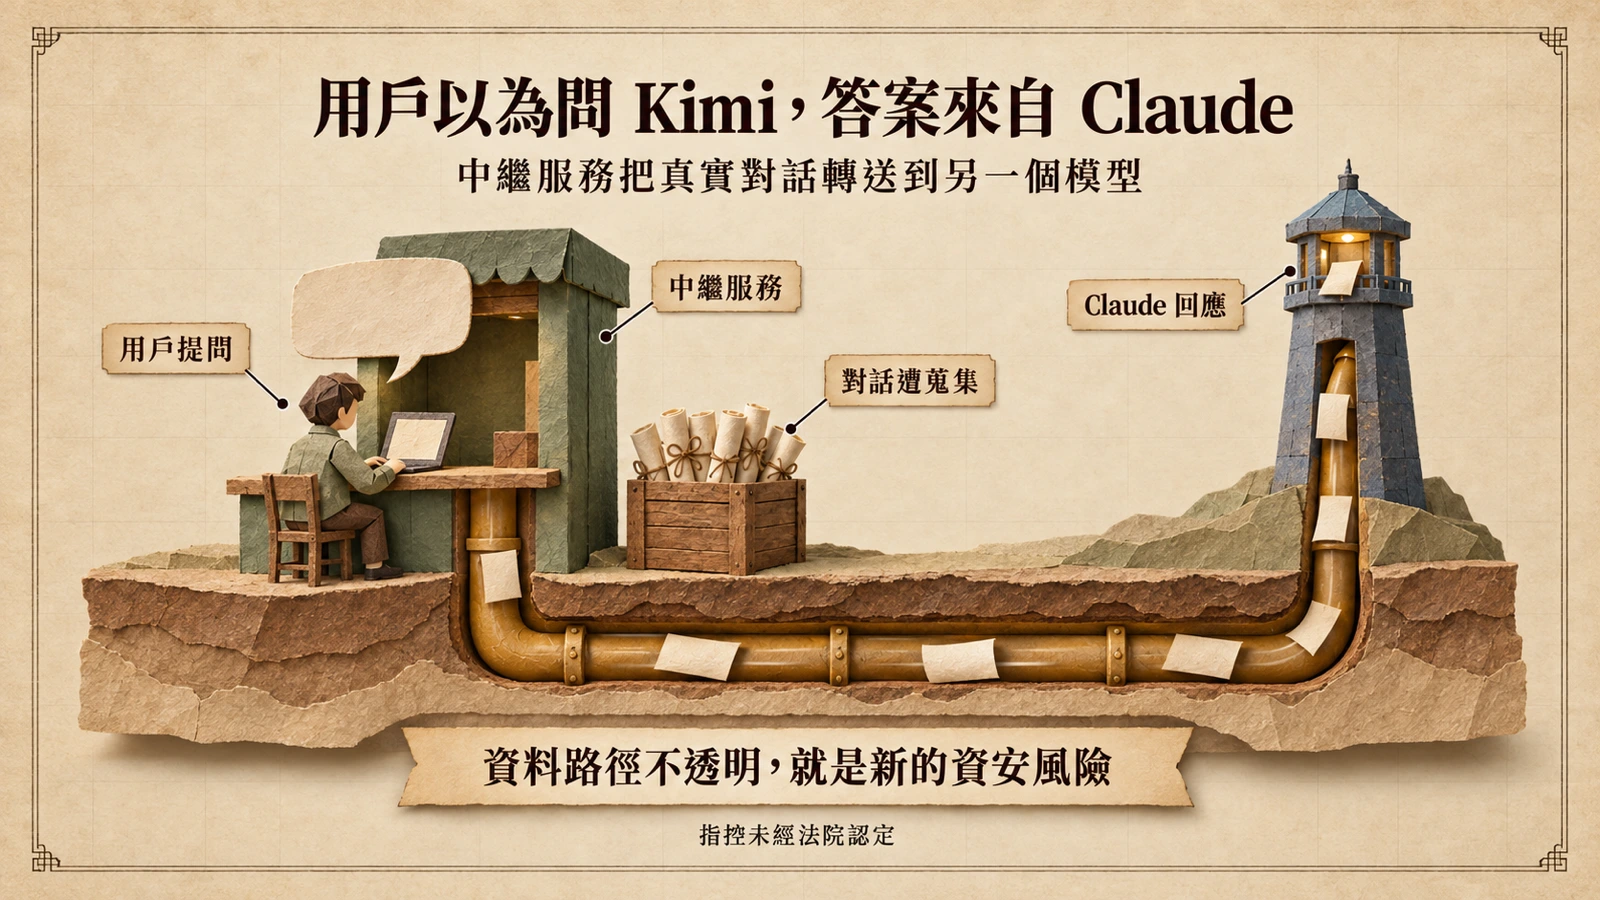
蒸餾攻擊之外,報告揭露的另一種手法更不尋常:不是攻擊者自己向 Claude 提問,而是把真實用戶的請求轉發過去。《Business Insider》報導,Anthropic 指中國 AI 實驗室今年夏天把至少 3,500 萬次請求路由到 Claude,被點名的公司包括阿里巴巴、月之暗面(Moonshot AI)、智譜(Zhipu)、DeepSeek 與小米。OfficeChai 的整理進一步指出,月之暗面與 DeepSeek 被指控把自家用戶的請求直接送進 Claude,再把 Claude 的回應當成自家模型的輸出返回——用戶以為在跟 Kimi 或 DeepSeek 對話,實際上問答的另一半是 Claude,而這些真實對話據稱被蒐集用於訓練。
若指控屬實,這種「中繼轉發」的影響遠超模型訓練本身:用戶的對話內容在不知情下流向第三方服務,外媒報導並指其中包含軍事與政府機構的敏感對話。對一般用戶而言,「我以為我在用的模型」與「實際回答我的模型」可能是兩回事;對企業而言,資料流動路徑的不可見性,已經是具體的資安與法遵風險。必須強調:上述均為 Anthropic 的單方指控,未經法院認定,遭點名公司多數否認或未回應置評。
從二月到九月:點名與指控的升級軌跡
這份報告不是孤立事件,而是半年多以來一連串指控的總整理。今年 2 月,Anthropic 首度公開表示三家中國公司以 Claude 非法獲取能力;4 月,川普政府在備忘錄中把損害美國研究成果的模型蒸餾定性為「不可接受」,並表示將研究追究外國行為者的措施。進入 6 月,Anthropic 致函美國參議員 Scott 與 Warren,指控阿里巴巴為訓練通義千問(Qwen)系列對 Claude 發動大規模蒸餾攻擊,路透社隨後報導 Anthropic 主張阿里巴巴非法萃取 Claude 的能力;7 月,Anthropic 又指控月之暗面當月推出的 Kimi K3 以最新版 Claude 非法訓練而成——同一個模型,英國 AISI 與美國 CAISI 先前的聯合評測已顯示其網路攻防能力與美國前沿模型有一段差距。
其後 Anthropic 把打擊範圍制度化:禁止中國控制的實體使用 Claude 服務,並在 9 月 10 日以這份報告把整條時間線上的案例一次攤開。口徑的變化清晰可見——從「若干公司」到具名五家,從新聞聲明到系統性的情報文件。外媒報導指出,阿里巴巴、DeepSeek、月之暗面與 MiniMax 均未回應置評請求。
為什麼在此時公布:IPO 前的模型保衛戰
時間點很難不聯想到 Anthropic 自身的處境。這家成立五年的公司正以 9,650 億美元估值推進 IPO,掛牌時程的報導已指向 10 月中旬;而估值最關鍵的前提——使用者願為前沿模型持續付出溢價——正被低成本中國模型侵蝕。蒸餾攻擊打的正是這個前提:若對手能以極低的邊際成本「借」到 Claude 的能力,前沿模型的溢價與研發投入就難以回收。報告發布後,Anthropic 也藉此呼籲美國政府提供更多支援,對抗其認定的不公平競爭。
把威脅情報做成定期公開報告,在前沿實驗室之間已是常態:OpenAI 的 Disrupting Malicious Uses of AI 系列同樣定期整理惡意行為者如何將 AI 模型與網站、社交平台組合運用,Alphabet 旗下單位亦發布過類似報告。差別在於,Anthropic 這次把「競爭對手的不當取用」放進與國家級間諜行動同級的威脅分類,等於把商業糾紛拉升到國家安全的層級來陳述;外媒引述該公司威脅情報主管的警告,指缺乏安全防護的模型可能被用於大規模監控、間諜活動乃至生物武器計畫,讓蒸餾從成本問題升高為國安風險。另一方面,模型輸出的保護終究也是工程問題——研究界已示範加密推理區塊可被越獄的小模型逐字解碼,顯示「不讓輸出被拿走」在技術上並沒有簡單解。
對開發者與企業的實際意義
這份報告對應用層的啟示集中在三件事。第一,別假設「我呼叫的 API 就是我想用的模型」:多模型路由與中繼服務在華文圈相當普遍,若這類服務在背後改接其他模型,用戶的資料流向與品質假設都會跟著改變;導入或採購時,應要求供應商揭露實際接取的模型與資料處理路徑,具體至少問三個問題——對話內容是否用於訓練、供應商能否保證模型不被替換、違反保證時的求償條款為何。第二,帳號與金鑰衛生升級為供應鏈安全議題:報告描述的暗網生態顯示,遭竊信用卡與被入侵帳號已是現成商品,開發者貼進對話的憑證、API 金鑰與內部文件,都可能成為轉賣的標的。第三,模型能力數字要打折解讀:在前沿模型自己都會在評測中作弊的今年,被指控以蒸餾取得能力的模型,其 benchmark 分數與自主研發能力之間的關係更需要驗證,而不是照單全收。
指控的邊界:哪些事還沒被證明
最後必須劃清界線:文中所有關於具名公司的陳述,都是 Anthropic 的單方主張,未經法院認定,多數遭點名公司否認或未回應。蒸餾技術本身在取得授權、遵守智財與出口管制的前提下可以合法使用,爭點在於是否以欺詐手段大規模存取服務。Anthropic 也有自己的立場——正值 IPO 前的敏感時點,且與遭點名公司存在直接競爭關係,其公布的證據細節(帳號數、請求次數、時間範圍)目前無法被獨立覆核。若爭議未來進入司法程序,可對照Apple 控告 OpenAI 竊取營業秘密的模式:起訴階段的指控與最終認定之間,往往還有數年的距離。後續值得追蹤的指標包括:Anthropic 或美國政府是否提起訴訟、白宮是否把 4 月備忘錄化為具體措施、遭點名公司是否公開說明訓練資料來源,以及各家模型卡對訓練資料的聲明是否趨於透明。