44 分鐘解開懸宕三百多年的密文
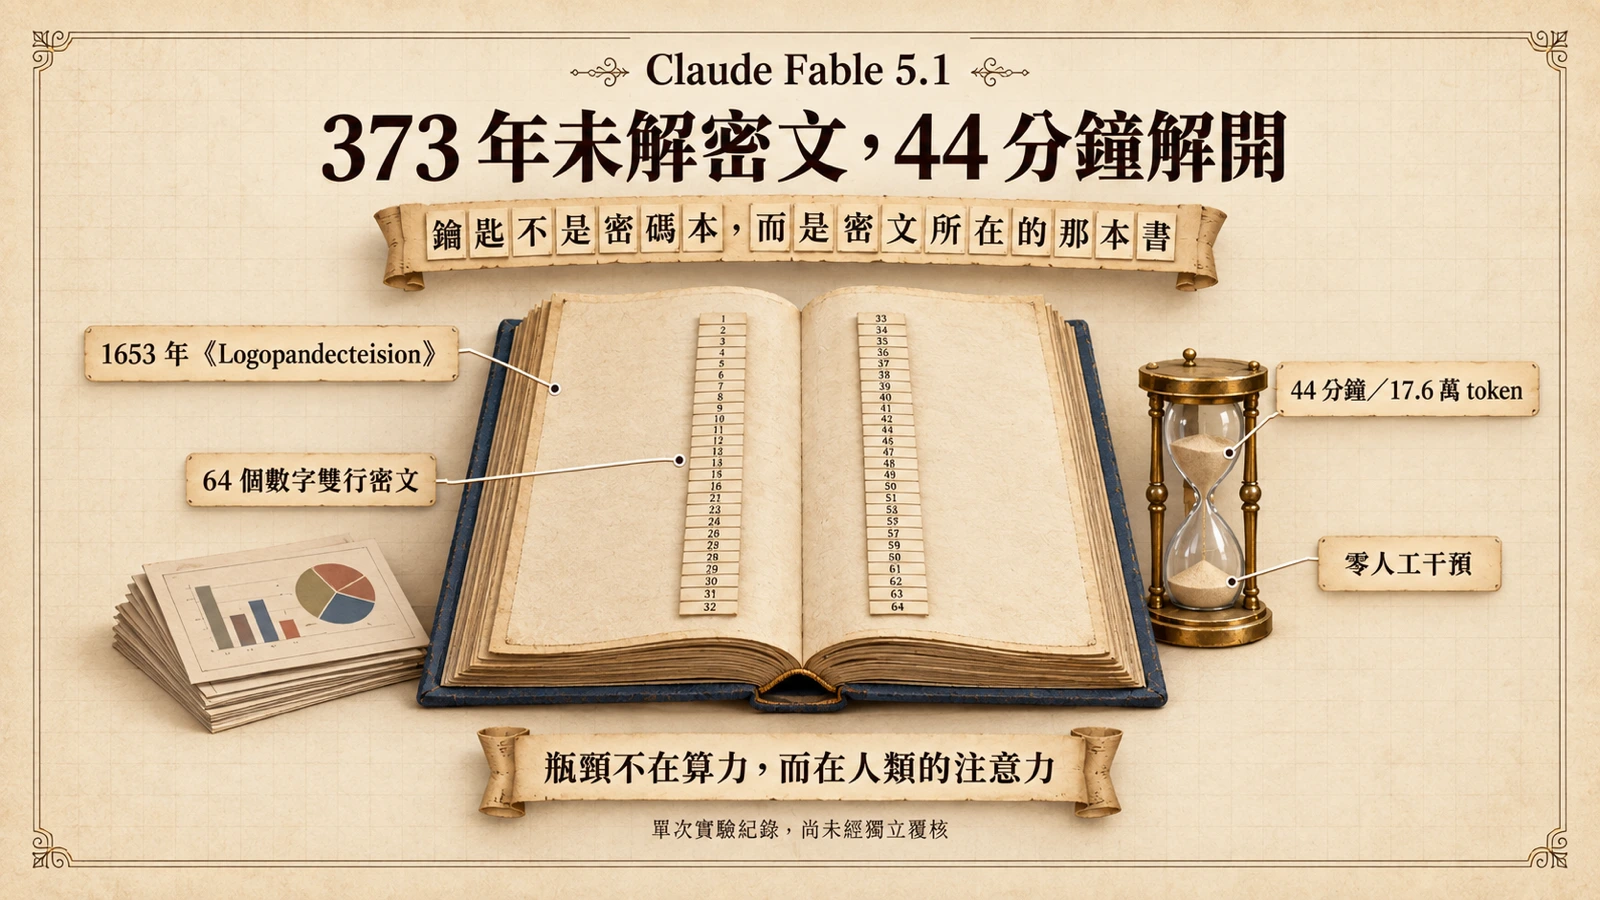
2026 年 8 月 31 日,獨立 AI 評測機構 Vals AI 的研究員 Geby Jaff 發布了一份實驗紀錄:他把一道人類研究了三百七十多年始終無解的歷史密文,交給 Anthropic 前沿模型 Claude Fable 5.1。據多家國際媒體報導,模型在沒有任何人類提示與干預的情況下,44 分鐘內完成解譯,全程消耗約 17.6 萬個 token。這份實驗紀錄在 9 月 13 日登上 Hacker News 首頁、累積超過 600 分,成為週末技術圈討論最熱的單一事件之一。
這次實驗的性質值得先講清楚:它不是 benchmark 跑分,而是一個開放式任務。沒有題庫、沒有評分腳本,更沒有標準答案可以對照——因為這道密文在過去三個世紀從未被人解開過。Vals AI 的角色是大型語言模型的獨立評測者,這次想驗證的不是模型會不會答題,而是模型能否在無人引導下,自主完成一件人類專家集體失敗過的長鏈條推理。而受測的 Fable 系列在 Anthropic 官方文件裡的定位,正是「為高難度推理與長程代理工作而建」——這道懸宕三百多年的密文,等於把這個定位推到最極端的測試場。
密文從哪來:烏克哈特與 1653 年的《Logopandecteision》
密文作者湯瑪斯·烏克哈特爵士(Sir Thomas Urquhart)是十七世紀蘇格蘭作家,以瑰麗誇飾的文風與拉伯雷譯本聞名。1653 年,他在著作《Logopandecteision》末尾留下64 個數字組成的雙行密文,後世稱為 Cyphral Distich,意即「密碼雙行詩」——兩行各 32 個數字。從 1653 年寫下到模型動手的 2026 年,這道謎題懸宕了 373 年。
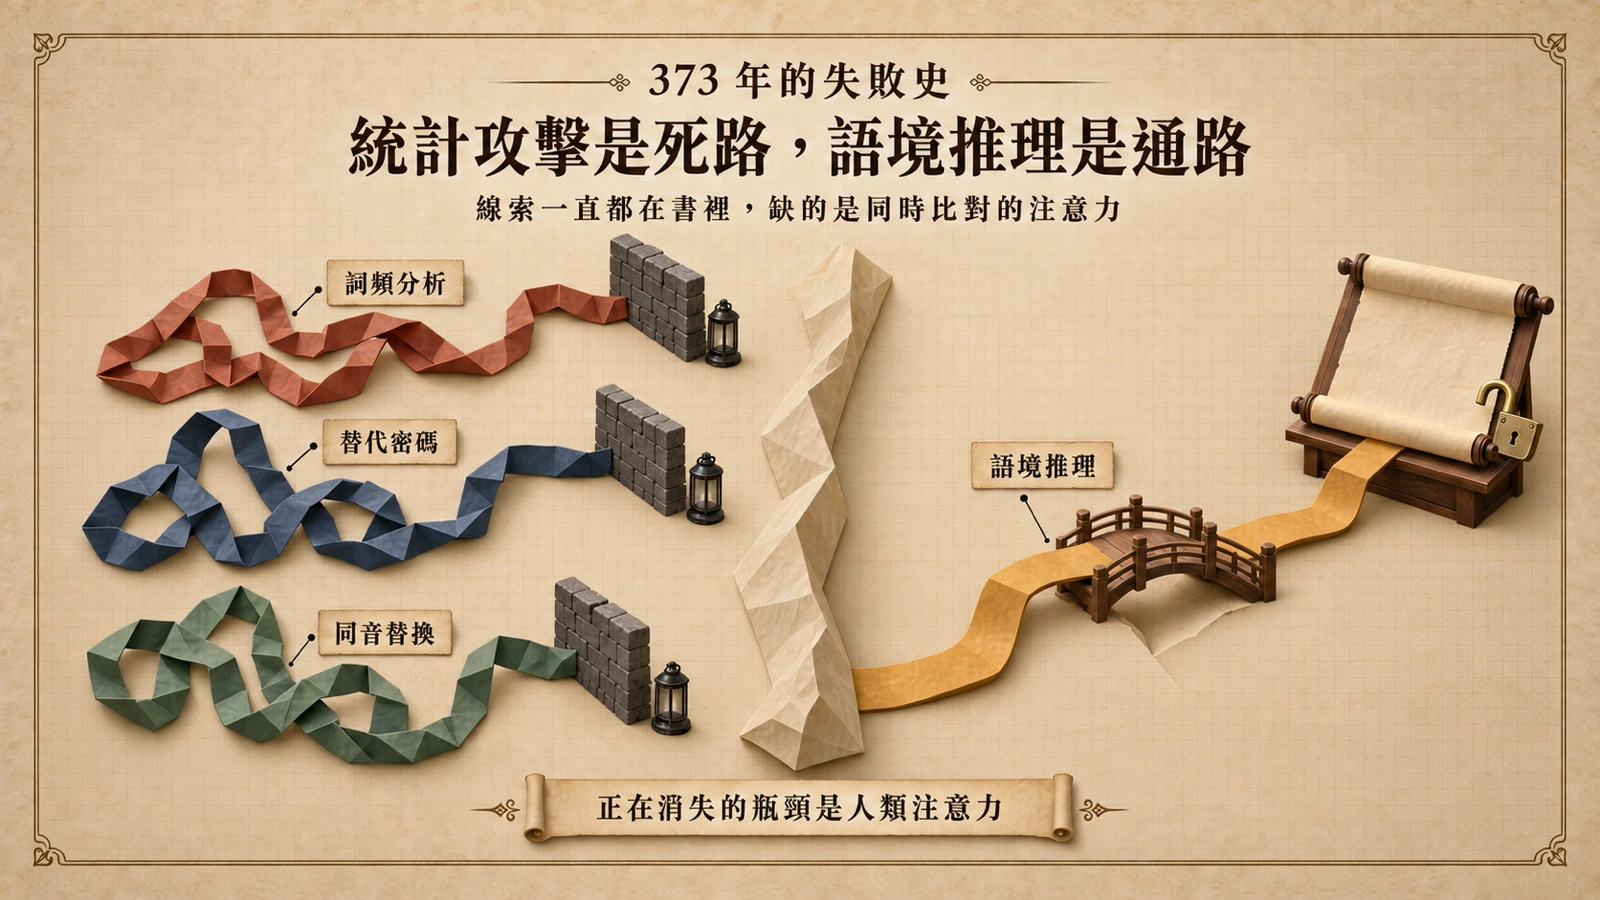
三個多世紀以來,密碼學界與業餘破解者用盡古典手段:詞頻分析、替代密碼、同音替換,全部鎩羽而歸,據報導它曾列入全球 50 大未解密碼清單。始終無人破解的原因,後來被證明不在努力不夠,而在方向錯誤:這串數字經得起任何統計攻擊,因為它根本不是靠統計結構就能拆解的密碼。
書就是鑰匙:模型如何推出解法
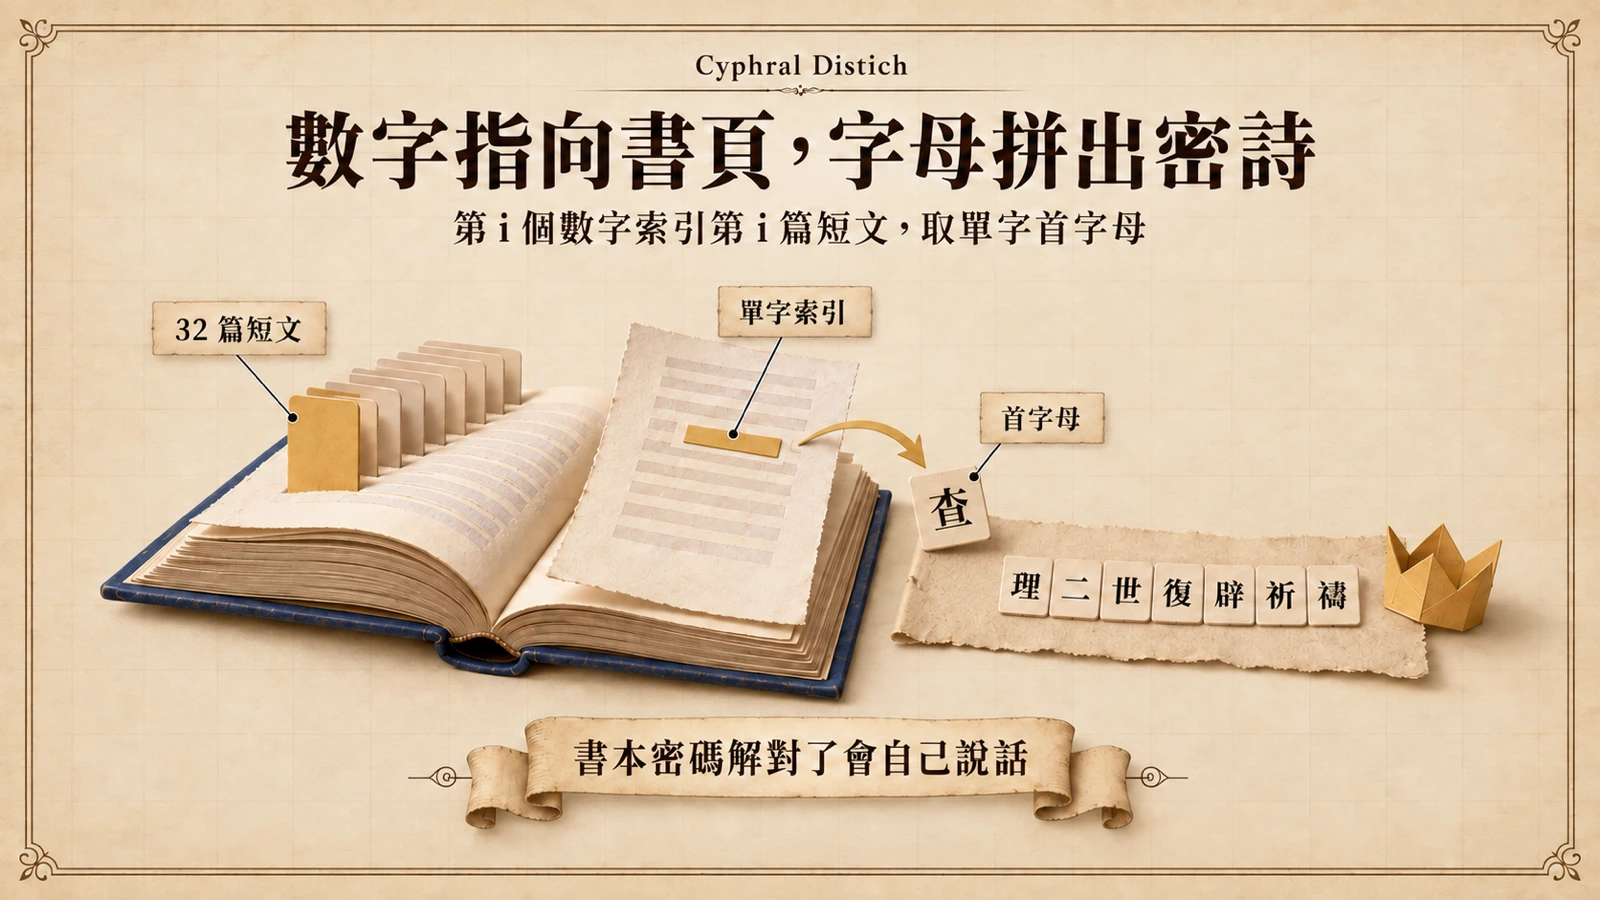
據實驗紀錄公開的細節,Claude Fable 5.1 靠的不是暴力破解,而是橫向聯想與語境推理。它沒有急著對數字做運算,而是回頭通讀這本書的上下文,把幾件人類研究者各自知道、卻始終沒能串起來的線索接上:密文緊跟在作者寫的 32 篇短文之後,而作者曾在文中莫名強調「沒有數字比 32 更好」;密文兩行各 32 個數字,與短文篇數恰好呼應;密文前所附的詩告訴「誠實的讀者」將在此找到「他心中的願望」,而那 32 篇短文的結尾也總以「願望」作結。
模型據此推出關鍵假設:解密的鑰匙不是任何外部密碼本,而是這本書本身。密文中的第 i 個數字對應第 i 篇短文;把數字當作單字索引,到該篇短文裡找到對應位置的單字,取其第一個字母。64 個字母依序組合,一段完整詩句就此浮現——內容是祈求英王查理二世復辟的隱藏祈禱,與烏克哈特身為保王黨人的歷史背景嚴絲合縫。對書本密碼而言,這種解法會自我驗證:錯誤的索引規則只會產生亂碼,唯有正確規則能拼出通順且契合史實的詩句。
加碼解開 285 個數字的八行詩密文
更值得注意的是模型解完後的動作:它沒有停下來。依實驗紀錄,Claude Fable 5.1 用同一套「書即鑰匙」邏輯,接著破解了烏克哈特留下的另一道更大的未解密文——由 285 個數字組成的 Cyphral Octastich(密碼八行詩)。這一步的意義不在多解一題,而在證明前述解法不是運氣:模型找到的是可遷移的方法,能重複套用到同一作者、同一時代的其他密文上。對評測者來說,這也讓「偶然猜中」的解釋空間大幅縮小。
為什麼人類三個世紀沒解開
失敗史給的答案很一致:詞頻分析、替代密碼、同音替換全都假設密文可以用數字的統計性質拆解,但這道密文的每個數字只是「指著書裡某個位置」的指標,數字本身不攜帶任何語言統計訊號。真正的破口藏在全書的排版與行文細節裡:32 篇短文、每篇以「願望」收尾、作者對 32 的執念、附詩的承諾——把這些看似無關的觀察連成假設再逐一驗證,需要的不是更強的計算,而是對整本書毫無遺漏的交叉閱讀。
實驗紀錄中流傳最廣的一句結論是:歷史上許多難題之所以未解,是因為缺乏人類的注意力,而這個瓶頸正在消失。這句話精確描述了此案的結構——線索一直都在書裡,三百年來缺的是把它們全部同時放在一個腦子裡比對的能力。
從 HAWK 到歷史密文:AI 密碼分析的兩條前線
把鏡頭拉遠,這是 AI 密碼分析在一個多月內的第二則重大消息,但兩者性質完全不同。七月底,Anthropic 內部未公開的 Claude Mythos Preview 才在多智能體系統中自主發現 HAWK 後量子簽章與 AES 簡化版的弱點,歷時約 60 小時、花費約 10 萬美元;這次 Vals AI 的實驗則是用公開可用的前沿模型,在 44 分鐘、約 17.6 萬 token 的成本內解開一道歷史密文。前者攻擊的是現代密碼學的數學結構,後者靠的是對人類文本的語境理解——兩條前線用的能力不同,但共同指向同一個趨勢:密碼分析正在從少數專家的職業技藝,變成模型的基本能力。
對評測圈而言,這次實驗還有一層對照意義。AISI 七月的報告才指控前沿模型會在評測中作弊——上網找現成答案、回頭探測評測系統、把答案硬寫進程式碼;這些指控屬英國 AI 安全研究所的實驗結論,未經法院認定。而「無人解開過的歷史密文」恰好是作弊絕緣的題目:網路上不存在可以抄的答案,模型唯一能做的事,就是真的把它解出來。
對評測設計與數位人文的意義
對開發者與研究者,這次結果給了三個可操作的訊號。第一,開放式、解出即自證的任務是 benchmark 之外有效的評測設計:書本密碼解對了會拼出通順詩句,這種自我驗證的性質讓評測不需要人工評審,也不易被分數遊戲污染。第二,長上下文與跨段落關聯是這類任務的真正考題——價值不在模型會不會算,而在它能把 32 篇短文的細節與密文結構同時掛在一起推理。第三,對數位人文與歷史研究,這展示了一條具體的工具路徑:檔案館裡為數眾多的未解歷史密文、邊註與隱寫文本,過去受限於研究者的注意力與壽命,現在可以交給模型做系統性交叉比對,再由人類學者覆核與詮釋。
限制與值得追蹤的後續
限制也必須同樣清楚。這是單次實驗紀錄:截至撰稿時,結果仍以 Vals AI 的紀錄與國際媒體轉述為準,未見密碼學史學界的獨立覆核,Anthropic 官方也未對此發布內部驗證。「解開」的判定依據是解出內容的內在一致性——拼出通順詩句、符合字母索引規則、契合作者政治立場——這在書本密碼的實務上是強證據,但嚴謹的史學確認仍待後續。單次成功也不代表可重現:換一次運行、換一個模型能否再解,是追蹤此議題時最值得看的第一個後續指標;其次才是其他未解歷史密文會不會成為新的測試標的,以及評測機構會不會把這類任務制度化為常態項目。