「實務上大致解決」:Cherny 點名的三層防禦
間接提示注入(indirect prompt injection)是代理系統最難纏的攻擊面:模型在替使用者瀏覽網頁、讀文件、解析工具回傳內容時,把藏在這些不可信資料裡的惡意指令當成真正指示來執行——例如把 SSH 金鑰悄悄寄到外部伺服器。Claude Code 負責人 Boris Cherny 在 2026 年 8 月 9 日的公開貼文裡,用一個生活化的例子說明這條攻擊路徑,接著丟出一句被廣泛轉傳的結論:在 Claude 模型上,Anthropic「實務上已大致解決提示注入的威脅」。
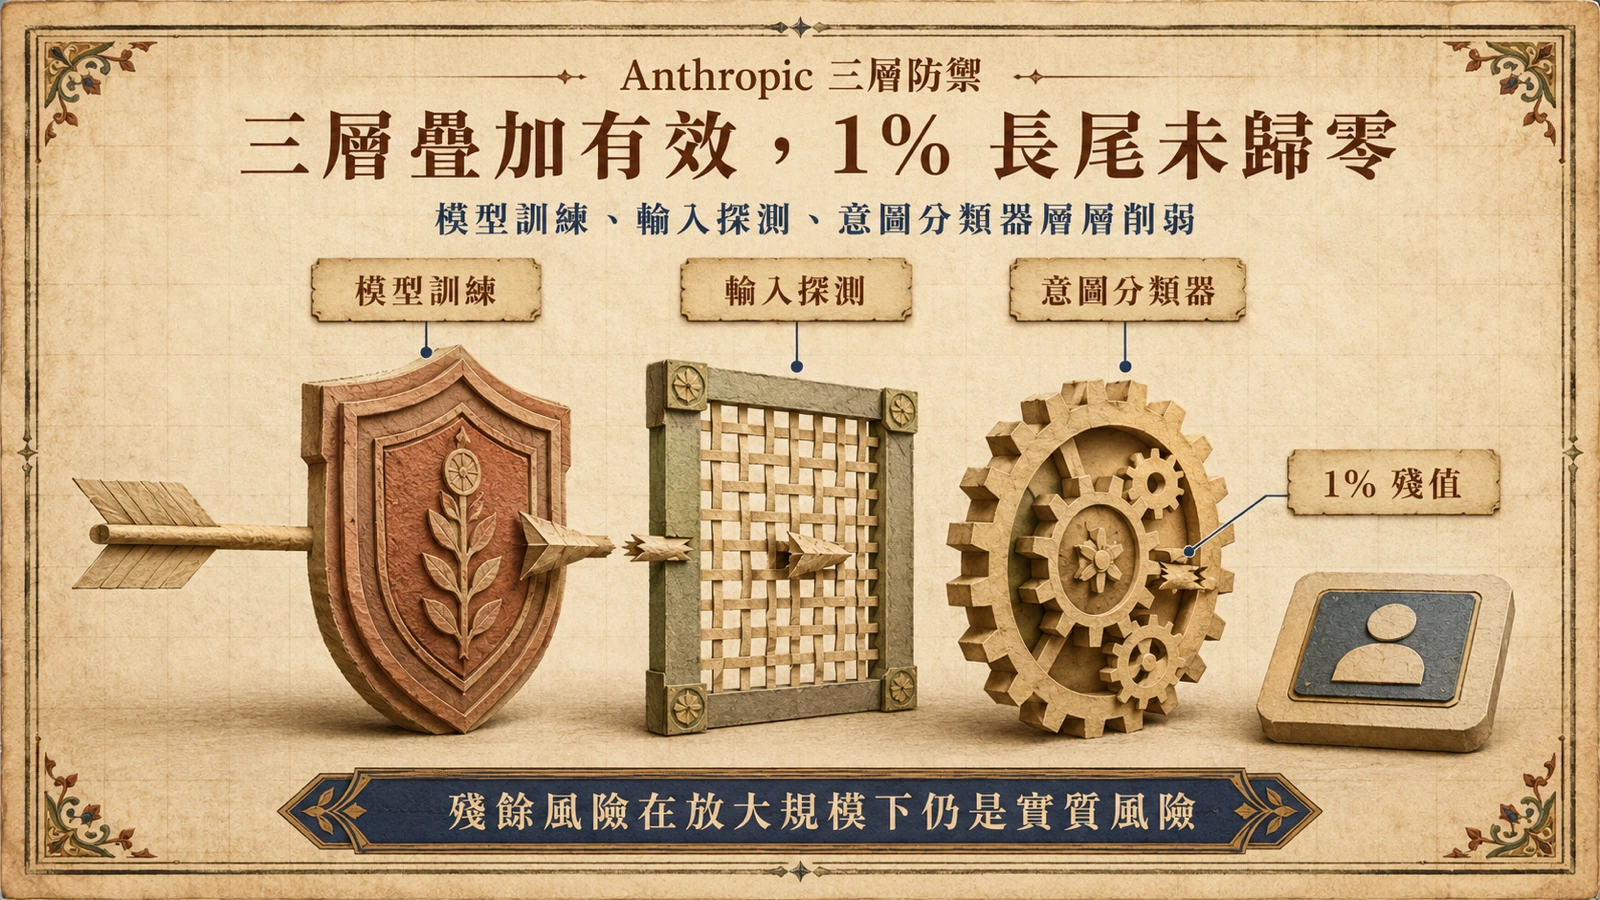
「大致解決」背後不是單一技術,而是三層防禦的疊加。Cherny 兩天前在另一則貼文裡把配方寫得很直白——把間接提示注入在未見過的攻擊上壓到接近零的,是三件事疊起來:模型訓練、輸入探測與一個檢查意圖的分類器。對應到 Anthropic 自己的技術說法,這三層分別是:用強化學習把抗提示注入的韌性直接寫進模型能力、對所有進入脈絡視窗的不可信內容以分類器掃描標記、再由一個獨立分類器在行動前覆核意圖。值得注意的是,「接近零」這個數字是 Cherny 以第一人稱陳述的 Anthropic 評測結果;他在文末另附上一份由獨立研究者製作的基準測試作為旁證,並稱紅隊測試得到相近結果——這三者是不同來源,不宜混為一談。
1% 殘值與「沒有任何代理免疫」:Anthropic 自己的但書
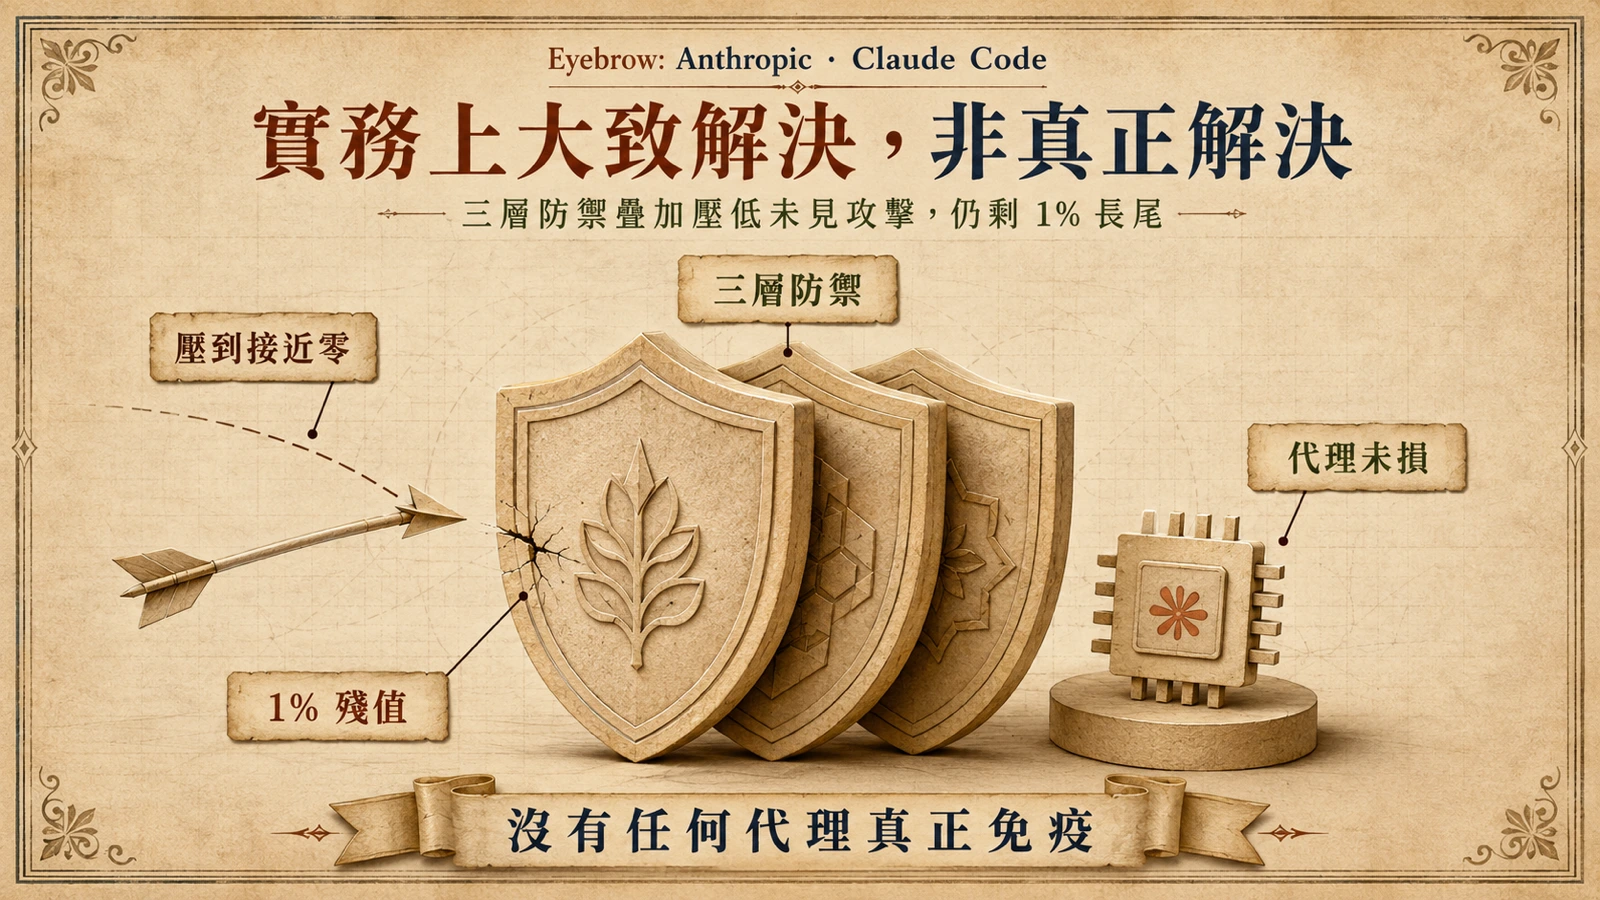
「大致解決」這四個字最容易在轉傳中被簡化成「已經解決」,但 Anthropic 自己的官方研究頁面其實把話說得保守得多。同一份說明防禦做法的文件,一方面列出強化學習訓練、不可信內容分類器、紅隊測試這幾道防線,另一方面明言:沒有任何瀏覽器代理對提示注入免疫。
這不是場面話。Anthropic 自己公布的數字是,在最嚴格的內部調適型紅隊攻擊者面前,攻擊成功率仍剩下約 1%;官方對這個 1% 的註解是,它「雖然是顯著改善,仍代表實質的風險」。把這句話和 Cherny 的「接近零」並讀,會得到一個比「解決」準確得多的圖像:在多數日常與常見攻擊場景裡,疊加防禦確實把成功率壓到極低;但在刻意設計、模型從未見過的對抗樣本面前,仍有一條沒有歸零的長尾。提示注入與 SQL 注入不同——後者有參數化查詢這種結構性的銀彈,前者面對的是會自己生成內容、又會把任何內容當指令的模型,本質上不存在一勞永逸的隔離。
auto 模式 8 月 14 日預設開啟:把關鍵決定交給分類器
這波更新的另一面,是 Claude Code 的權限模式即將改變。Cherny 引述官方公告指出,2026 年 8 月 14 日起,auto 模式將成為 Claude Code 在 Pro、Max 與 Team 方案的預設權限模式。auto 模式不再逐條彈出權限確認,而是由一個獨立分類器審查 shell 指令與動作;官方公布的測試數字是,這個分類器能攔下 89% 的危險指令,而人工逐條核准只能攔下 14%。
這組數字值得停下來看。它不等於「分類器比人強」,而是點出一個更實際的事實:人類在重複、瑣碎的權限彈窗前會疲勞、會盲點同意,於是手動核准的保護力反而薄弱;把審查交給一個不會疲勞、專門訓練來辨識危險指令的分類器,在統計上抓住了更多風險,這也是 Cherny 所屬團隊「只用 auto 模式」的理由。代價是同一個分類器會成為新的信任邊界——它的漏報與誤報,直接決定代理能在使用者的機器與帳號上做到什麼。於是「提示注入防得好不好」從單純的模型能力問題,延伸成一條涵蓋模型、分類器與權限設計的整體防線問題。
「最大挑戰、沒有銀彈」:獨立研究者的保留態度
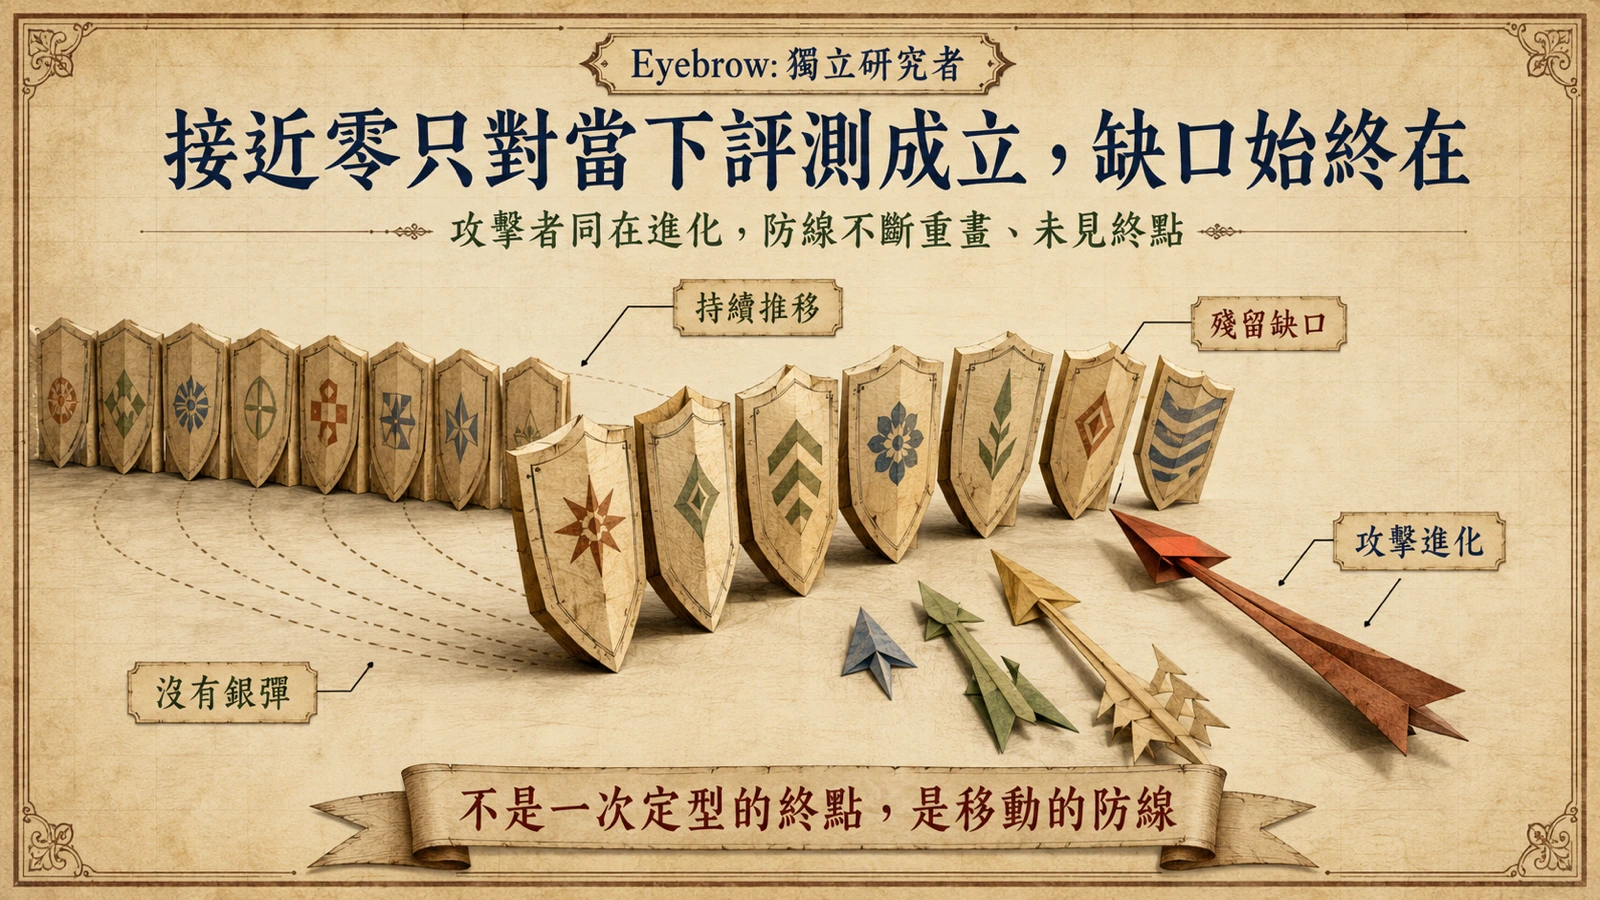
相較於 Anthropic 的樂觀,獨立研究圈的態度明顯保留。2022 年共同提出「提示注入」一詞的 Simon Willison,在關於代理安全的分析裡寫得直接:提示注入仍然是負責任地部署代理系統的最大挑戰,而我們沒有神奇解法,只能做取捨。他進一步認同一份論文的判斷——通用型代理恐怕無法提供有意義且可靠的安全保證。
這樣的保留不是否定 Anthropic 的進展。三層防禦把常見攻擊的成功率壓到極低,本身是貨真價實的工程成就,也足以解釋 Anthropic 為什麼敢讓 auto 模式預設開啟。研究者的警惕針對的是「解決」這個框架本身:當攻擊者同樣在進化、當模型被放進權限越來越大的真實環境,任何「接近零」的數字都只對特定評測集合與特定攻擊強度成立。換句話說,問題從「能不能完全擋住」轉變成「在可接受的殘餘風險下,能不能放心把代理放出沙箱」——這是一道持續移動的防線,而不是一次定型的終點。
對部署者的意義:進展是真的,終點還沒到
對實際在企業內部部署代理的團隊,這波更新傳遞的三個訊號比「解決了沒」更值得追蹤。第一,分層防禦優於單點依賴:模型訓練、輸入偵測、意圖覆核三者疊加的成效,遠高於只靠其中任何一層,這也與近期多起代理自主攻入生產環境的事件指向的「圍欄太單薄」教訓一致。第二,權限設計本身是安全控制:auto 模式用分類器取代彈窗疲勞,代表最小權限應該交給不會疲勞的自動審查機制來執行,而非仰賴人類逐條點同意。第三,殘餘風險不會消失:1% 的成功率在放大規模與高權限場景裡仍是實質風險,因此獨立於模型自身的軌跡監控、敏感動作的二次確認、以及對不可信內容的隔離處理,依然不可省略。
回到那句引發熱議的「實務上大致解決」——比較公允的解讀是:Anthropic 用三層防禦把過去讓許多注重安全的企業對代理卻步的提示注入,推進到「日常使用中極少發生」的程度,這是真正的進展;但「大致解決」前面的「實務上」三個字、以及官方自己強調的 1% 殘值與「沒有任何代理免疫」,才是這則消息裡最不該在轉傳中被丟掉的訊號。