模型 / MODELS新聞 / NEWS
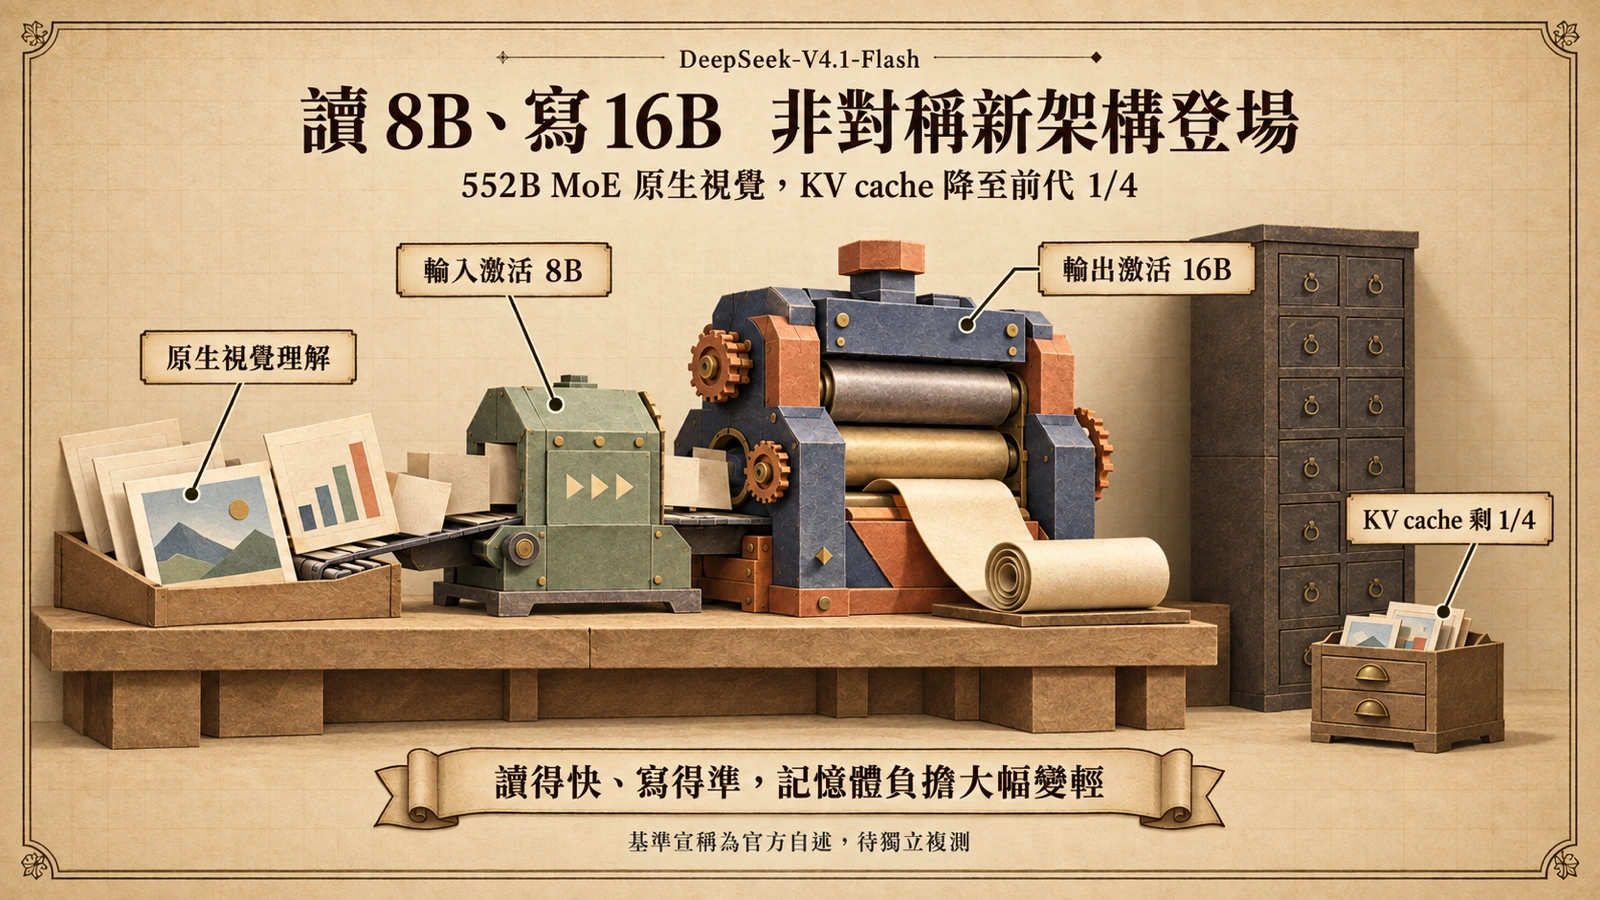
DeepSeek V4.1-Flash 發布:讀用 8B、寫用 16B 的非對稱新架構
DeepSeek 發布 V4.1-Flash:552B MoE 採 Causal Encoder-Decoder 新架構並具原生視覺理解,輸入激活 8B、輸出激活 16B,KV cache 降至前代 HBM 的 1/4。
多模態模型:影像、語音與文字跨模態能力的發布與評測。
共 6 則文章,依發布時間排序
DeepSeek 發布 V4.1-Flash:552B MoE 採 Causal Encoder-Decoder 新架構並具原生視覺理解,輸入激活 8B、輸出激活 16B,KV cache 降至前代 HBM 的 1/4。
DeepSeek 在 API 平台推出實驗性多模態模型 deepseek-v4-flash-vision-exp,Chat API 可直接傳圖,圖片依尺寸折算 token、與文字合併按輸入 token 計費。
MiniMax 官方開源的全模態影片模型 MiniMax-H3,一次前向傳遞同時生成影片與原生立體聲音訊;ComfyUI 0.30.0 起原生支援,可用 Python 經 API 無頭驅動、不必開圖形介面。
Meta 以 Apache 2.0 開源 30B 多模態模型 Muse Glimmer,蒸餾自 Muse Spark、為常駐本機代理設計,在 SWE-Bench Pro、MCP Atlas 等同尺寸代理基準多項領先,單張 GPU 即可運行。
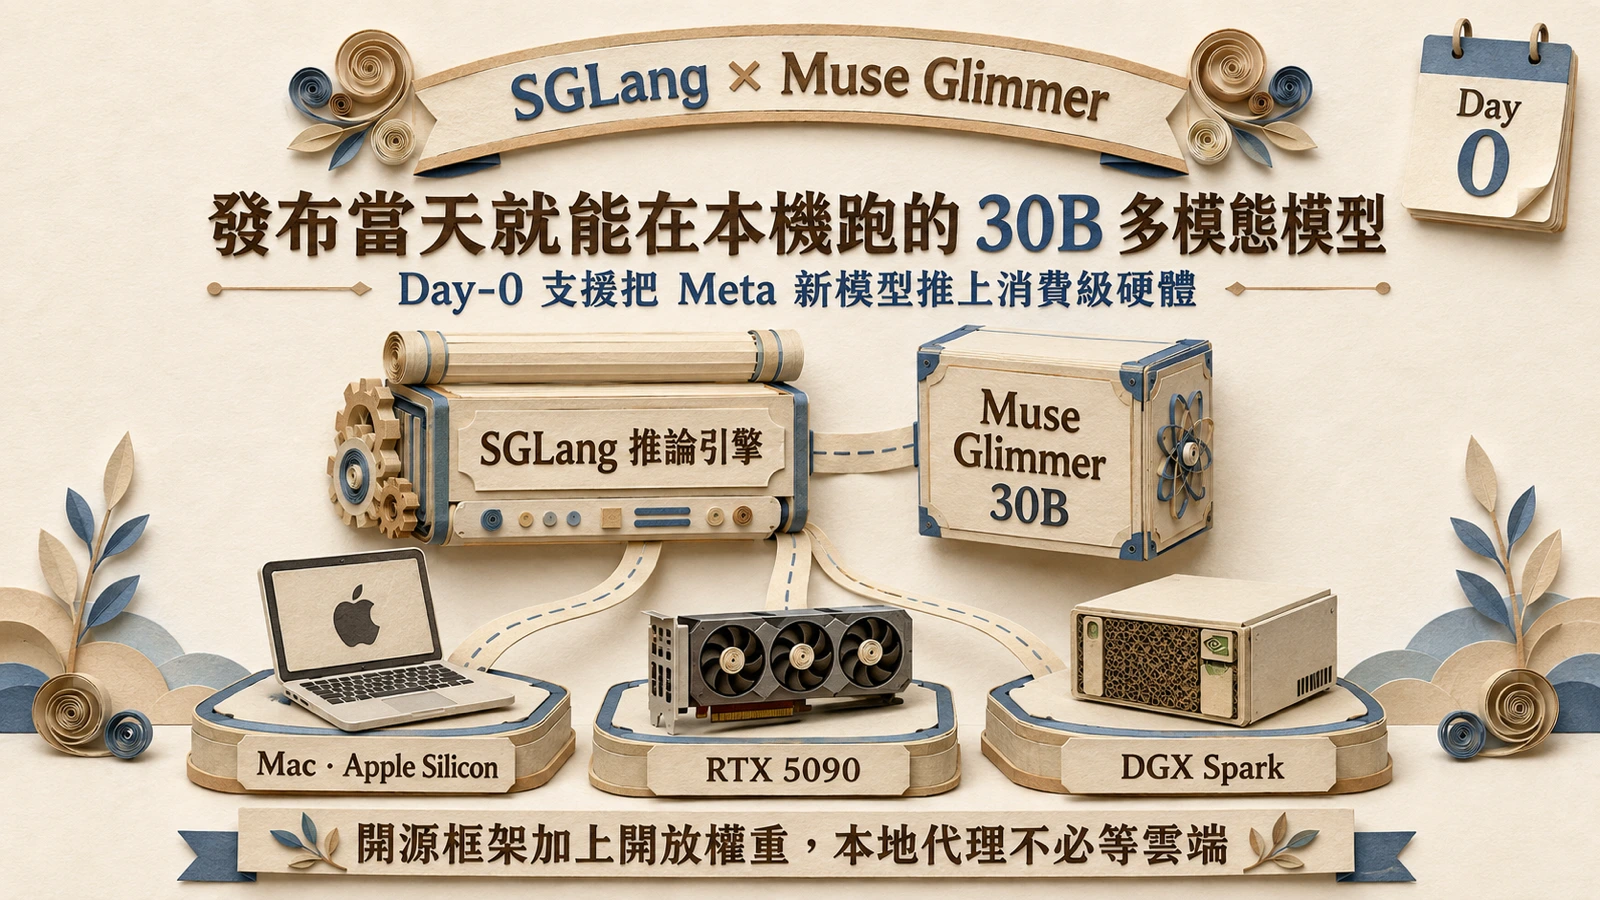
Meta 超級智慧實驗室發布 30B 多模態模型 Muse Glimmer,SGLang 同日推出 Day-0 支援,以 DFlash 推測解碼、RadixAttention 前綴快取與 CUDA graphs 在 RTX 5090 繳出每秒 1,452 token,把多模態代理搬上消費級硬體。
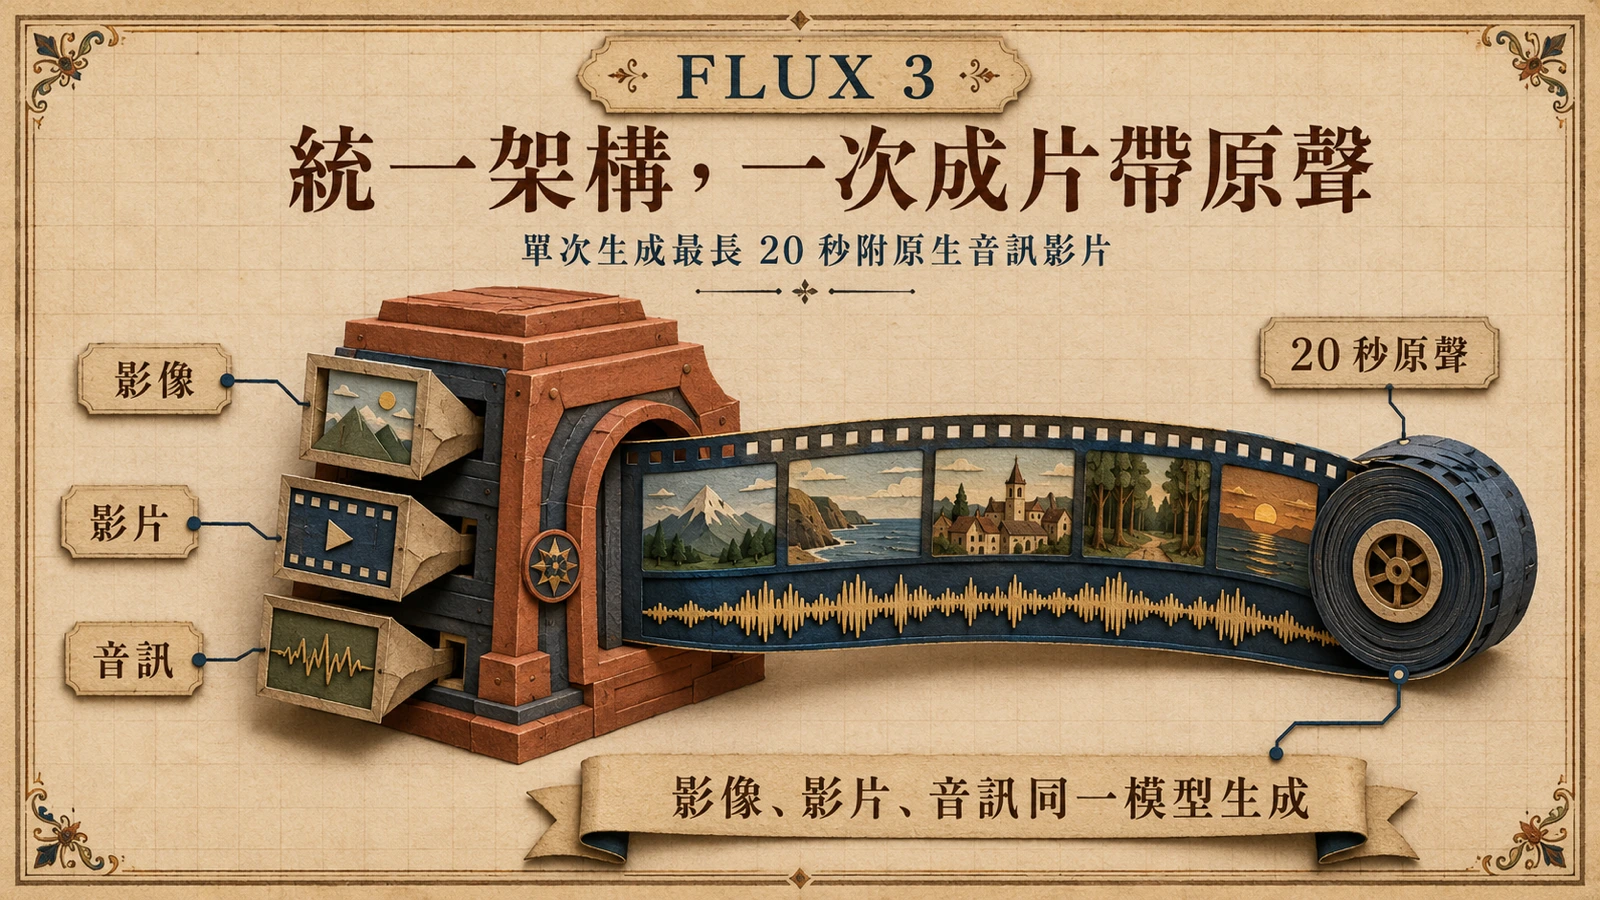
Black Forest Labs 以 Early Access 推出 FLUX 3 多模態基礎模型,於統一架構內聯合學習影像、影片與音訊,單次可生成最長 20 秒含原生音訊的影片,並公布對多家競品的初步人工評測勝率。