30 倍怎麼來的:NVIDIA 的實測口徑
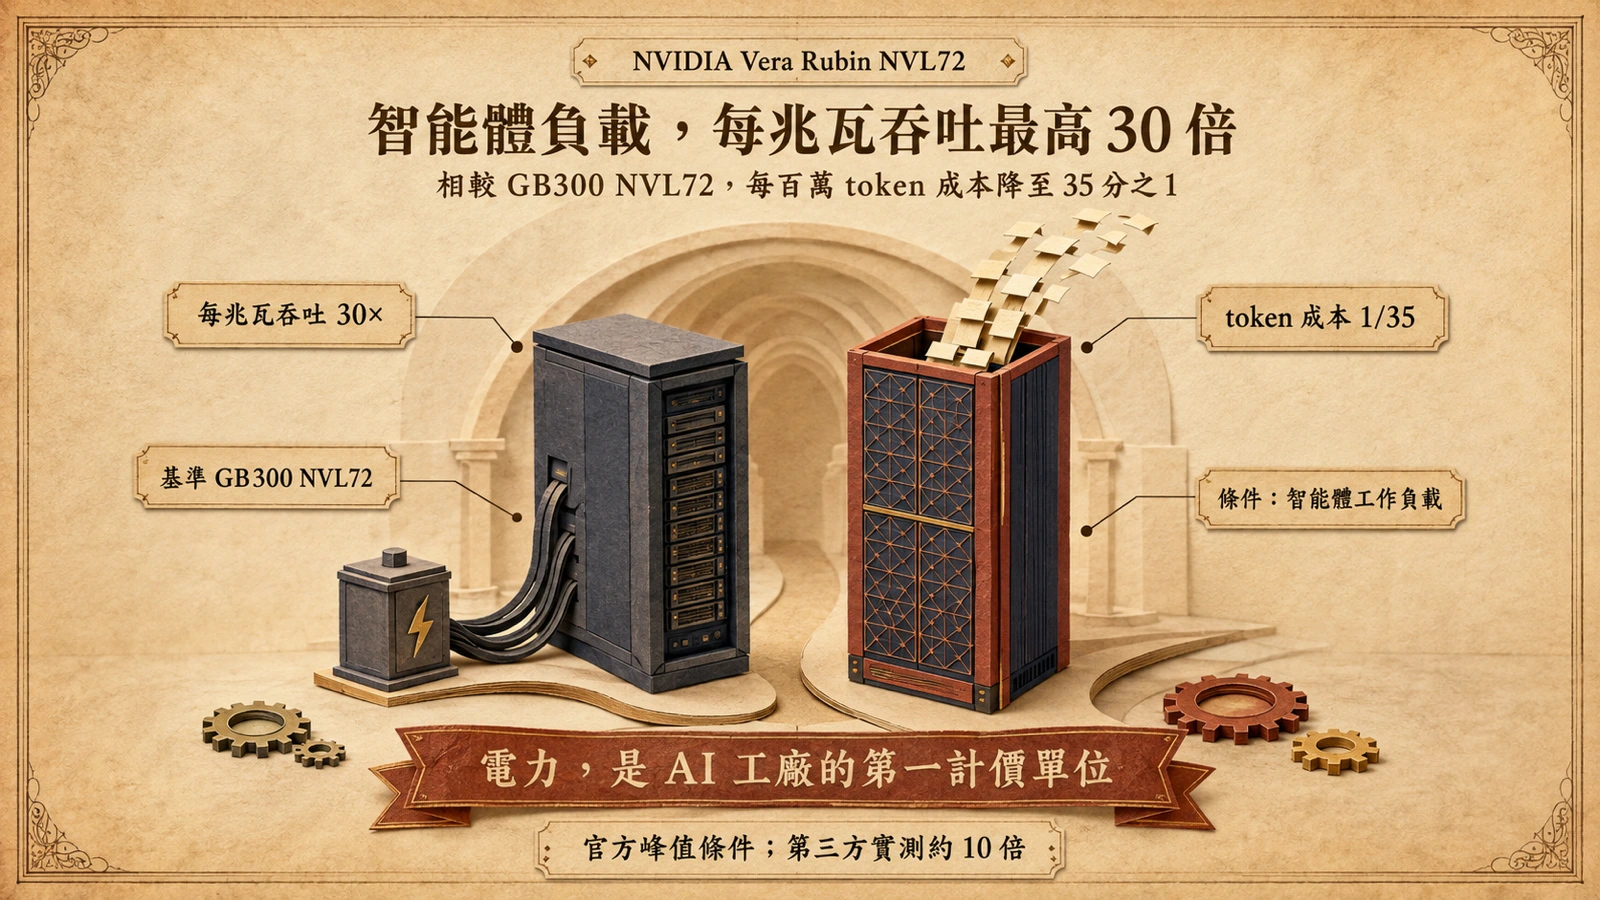
NVIDIA 在官方部落格發布了新一代 Vera Rubin NVL72 的量測結果:在 AI 智能體工作負載下,這套機櫃級系統的每兆瓦吞吐量較 GB300 NVL72 最高提升 30 倍,同一份數據並列出每百萬 token 成本最多降到 35 分之 1。值得注意的定位是「實測」——NVIDIA 把它當作量測數據發布,而不是路線圖承諾;對照半導體業慣常以紙面峰值算力宣傳新世代,這個口徑本身就值得記錄。
要正確讀這組數字,得先固定三個條件。第一,比較對象是 GB300 NVL72——Blackwell Ultra 世代的同形態機櫃,不是更早的 GB200,更不是 Hopper;拿 30 倍去除以舊兩代的系統,倍數會被放大。第二,量測單位是「每兆瓦吞吐量」,分母是電力而不是晶片數量;從單晶片視角轉向電力視角,等於承認資料中心的真實約束已經從「買到多少 GPU」變成「拿到多少電」。第三,官方措辭是「最高」30 倍,屬於峰值條件,不是所有工作負載的平均增幅。
這三個條件劃出了數字的適用範圍:30 倍專屬於智能體型工作負載,而智能體正是當前推理需求成長最快的形態——也因此,這組數字真正影響的是接下來一輪 AI 基礎設施採購的比較基準。
每兆瓦與每 token:AI 工廠的計價單位變了
「每兆瓦」會成為主要單位,背景是前沿 AI 基礎設施的建置尺度已經跳到 GW 級。OpenAI 在喬治亞州推動的 Project Camellia 規劃 3.2GW,AMD 與 Anthropic 的合作以 2GW 起跳;當單一客戶的用電量以核電機組為單位計算,電力取得、變電與散熱就成為比晶片產能更硬的瓶頸。在電力受限的市場裡,雲端業者能賣出多少推理容量,直接由「每兆瓦可以榨出多少 token」決定。
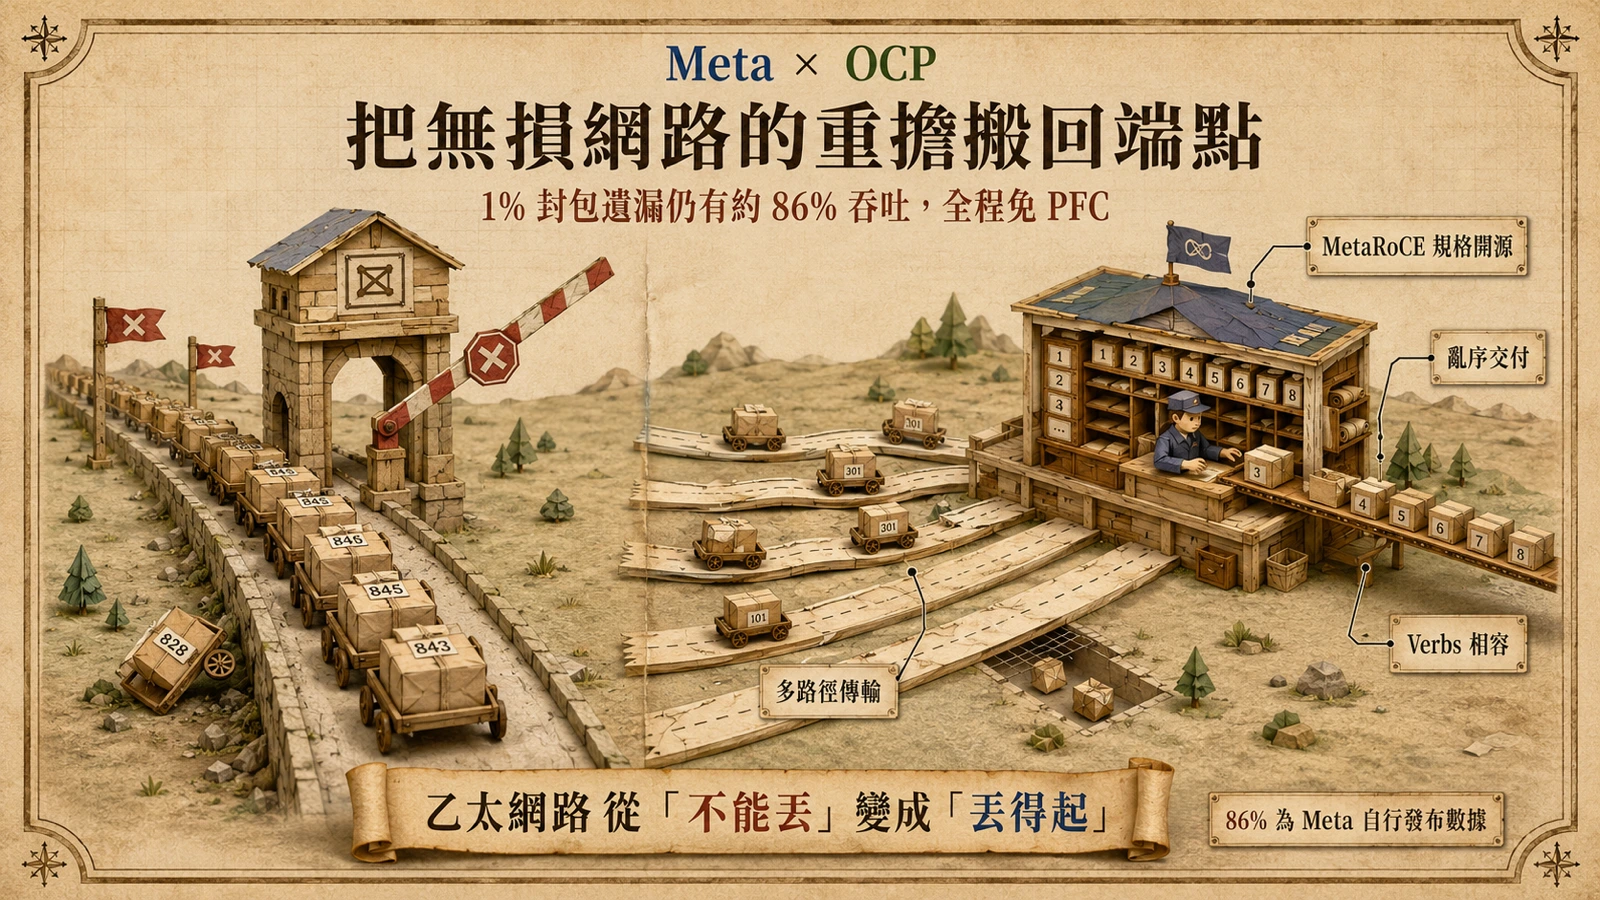
NVIDIA 對這個轉向有自覺的論述。在開發者部落格的架構文章中,NVIDIA 把智能體時代的能源效率定義為「AI 工廠問題,而不只是 GPU 功耗問題」:單顆晶片每瓦效能再漂亮,如果記憶體搬移、網路互連與工具執行把電力浪費在非產出的環節,整座工廠的每瓦產出依然上不去。這也是 Meta 為百萬 GPU 乙太網重造 MetaRoCE/RDMA 傳輸協定所處理的同一類系統瓶頸。同一篇文章以 Rubin GPU 對 Blackwell「每單位能量最高 10 倍智能體吞吐」描述晶片層級的量級,而整機櫃加上記憶體與網路的一致設計,才把系統級數字推到對 GB300 的 30 倍。
換句話說,30 倍不是一顆晶片的奇蹟,而是「把整座機櫃當成一顆晶片來設計」的結果。這也是為什麼它出現在智能體負載上最明顯——愈是狀態複雜、環節互咬的工作負載,系統級優化的槓桿愈大。
機制:Rubin GPU、Vera CPU 與 KV cache 分工
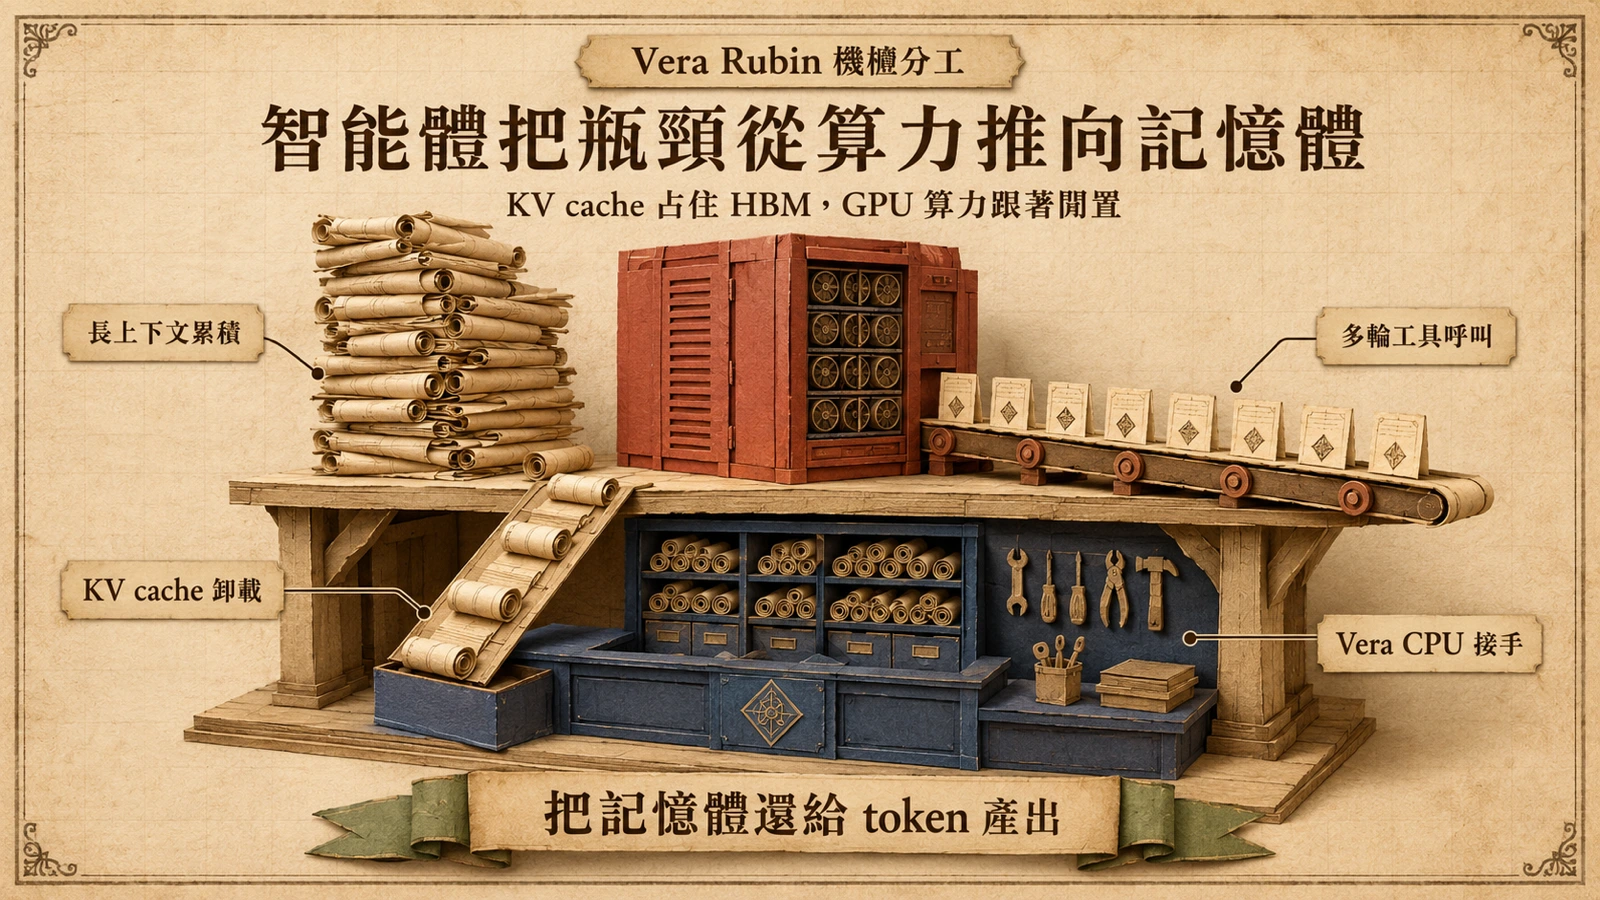
智能體負載與單輪對話的根本差異,在於狀態會累積。一個智能體在任務中反覆呼叫工具,系統提示、工具回傳值與中間推理全部堆進同一個上下文視窗,數十萬 token 的長上下文成為常態。每多一輪,KV cache——模型注意力必須保留的中間狀態——就跟著長大,而它直接住在 HBM 記憶體裡,與正在產出的 token 搶空間。記憶體被對話歷史占滿,能同時服務的併發請求就變少,GPU 算力閒置,每瓦產出跟著下滑。智能體推理的成本結構因此常常不是算力不足,而是記憶體被自己的歷史吃掉。
NVIDIA 在性能每瓦的技術拆解中給出的解法是分工:Rubin GPU 專注大型上下文的處理與解碼,Vera CPU 承接工具執行與 KV cache 卸載。用白話說,就是把「不需要 GPU 算力的工作」從昂貴的 HBM 與 GPU 核心搬走——工具呼叫的排程、等待與快取狀態交給 CPU 側的記憶體階層,GPU 記憶體還給真正產生 token 的計算。這正是官方所稱機櫃級共同設計的具體內容:效率來自讓對的資料住在對的記憶體、由對的運算單元處理。
對部署智能體的團隊,這個機制點出一個採購視角:比較不同平台時,只看每顆 GPU 的算力與記憶體容量會失真,因為智能體的瓶頸在系統層——上下文放在哪裡、工具呼叫誰來跑、狀態如何在多輪之間復用,這些才是決定每兆瓦產出的變數。
官方 30 倍與第三方 10 倍的差距
第一份非 NVIDIA 官方的實機數據來自 CoreWeave。這家雲端業者發布了他們量測的 Vera Rubin NVL72 矽晶片表現:在相近的每用戶生成速度下,每兆瓦 token 產量約為 Blackwell 的 10 倍,測試模型為 DeepSeek R1。CoreWeave 將其定位為首批實機量測——意義在於 Vera Rubin 的效率主張已經有人用實際晶片驗證,而不只存在於發布材料裡。
兩組數字並排,差距比數字本身更有資訊量。基準不同:官方的 30 倍對 GB300 NVL72,CoreWeave 的 10 倍對 GB200 NVL72——若 GB300 相對 GB200 本身已有可觀增益,兩組數字可以同時成立。負載不同:官方鎖定智能體工作負載,CoreWeave 跑的是 DeepSeek R1 這類推理模型。量測者不同:一邊是平台商的實驗室,一邊是營運中的雲端業者,後者的條件通常更貼近生產環境。
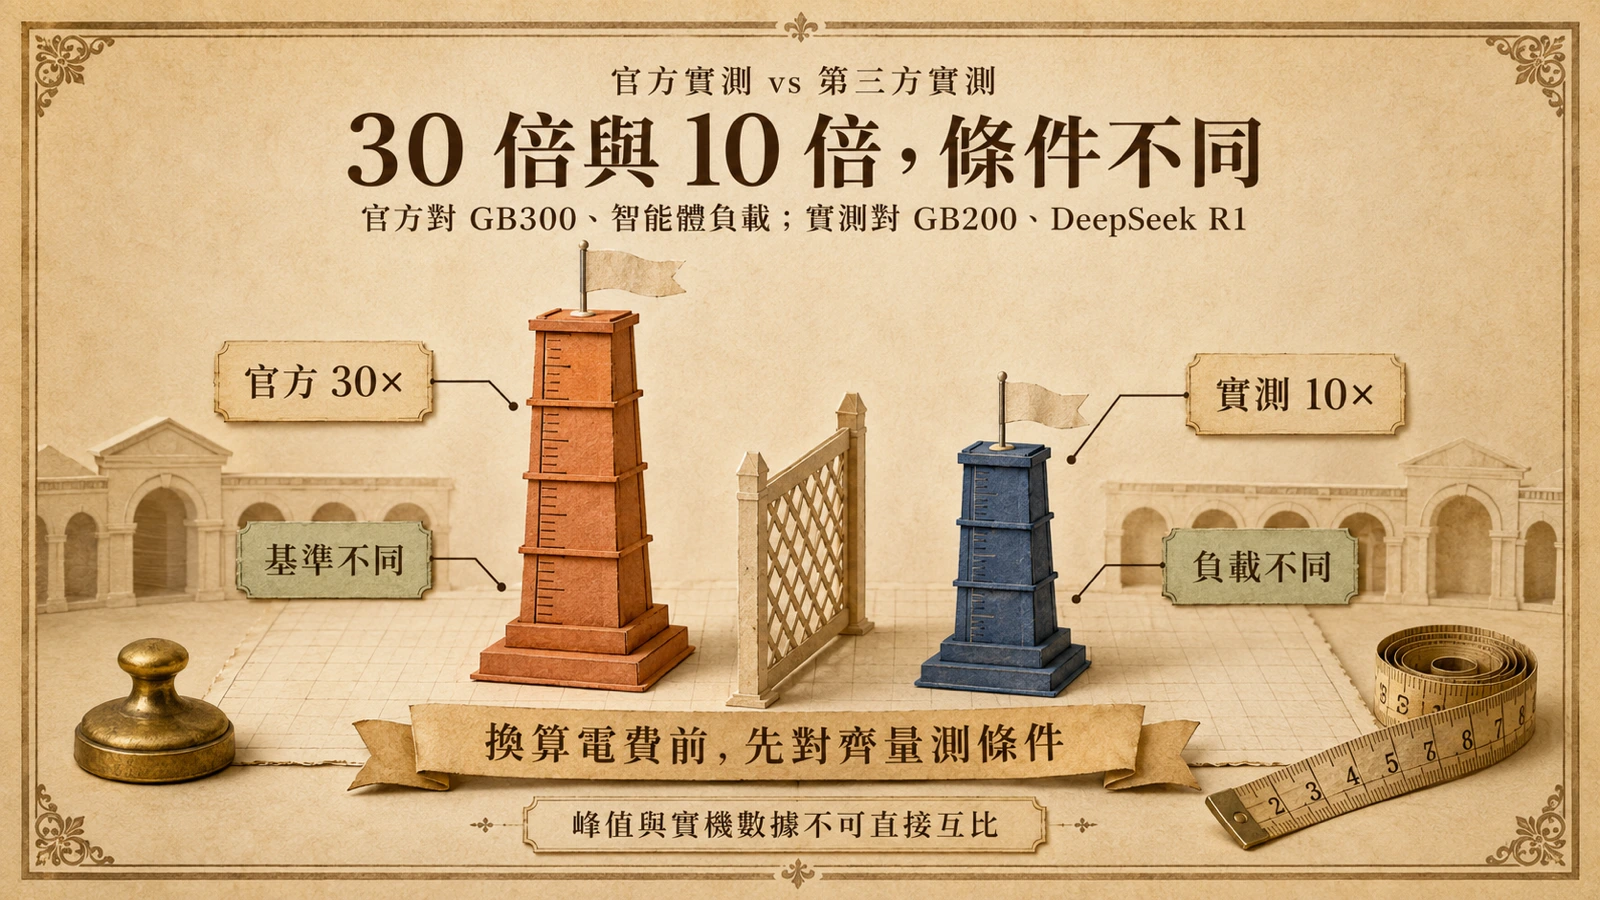
對需要做換算的人,結論很實際:30 倍是 NVIDIA 選定條件下的最高值,10 倍是另一組條件下的實機值;你的智能體應用會落在哪裡,取決於上下文長度、工具呼叫密度與併發形態,最終只能用自己的負載實測。
對雲端業者與企業採購的意義
對雲端與 AI 工廠營運者,這組數字直接改寫產能盤算。在電力配額固定的市場,每兆瓦吞吐量就是可售容量:同樣 100MW 的電力契約,吞吐量提升意味著能服務的推理請求與 token 帳單等比增加,而不必再去爭取更難拿到的電力與土地。35 分之 1 的 token 成本若有一部分反映到服務價格,智能體應用的單位經濟也會跟著鬆動——單次任務動輒消耗數十萬 token 的使用情境,對成本曲線特別敏感。
對企業採購,更結構性的影響是比較語言的統一。當 NVIDIA 用每兆瓦吞吐量與每 token 成本定義效率,競爭對手也得用同一單位應戰;AMD 為 Anthropic 部署的 MI450 Helios 機櫃同樣以機櫃級方案競爭前沿工作負載,屆時各家發布的每瓦數據能不能用一致條件檢驗,會直接影響採購判斷的品質。跨廠商的效能宣稱從來不會自動對齊,買方自己建立負載基準,才是唯一可靠的換算基礎。
對開發者,短期內最實際的動作不是等待新硬體,而是先把應用的上下文效率顧好——快取命中、上下文修剪與工具結果摘要,在現有硬體上就能降低每任務 token 成本,也讓未來換到 Vera Rubin 這類平台時的增益最大化。
限制與後續追蹤指標
這組數字也有它還沒回答的部分。首先,30 倍是 NVIDIA 自家量測的峰值,獨立複核仍然稀少;CoreWeave 的一份實測已經顯示,換個基準與負載,倍數就從 30 降到 10,條件敏感性極高。其次,每兆瓦口徑衡量的是系統耗電,實際專案的總擁成本還要計入冷卻、變電與廠務開銷——同一座工廠的經濟學不會只由 GPU 機櫃決定。最後,這波公布聚焦效能數據本身,對一般企業更具體的問題——雲端執行個體何時開放、定價如何反映成本降幅——都還沒有答案。
值得追蹤的指標因此很明確:CoreWeave 之後是否有更多獨立實測,且基準涵蓋 GB300 與智能體框架;各雲端業者開放 Vera Rubin 執行個體的時程與價格;AMD MI450 Helios 是否以同口徑發布每瓦數據;以及上下文快取這類軟體層優化在新舊平台上的實測差距。這些數據到齊之前,30 倍應該被當成一個「方向正確、幅度待驗證」的訊號,而不是可以直接寫進財務模型的常數。