Meta 把自研 RDMA 傳輸協定交給 OCP
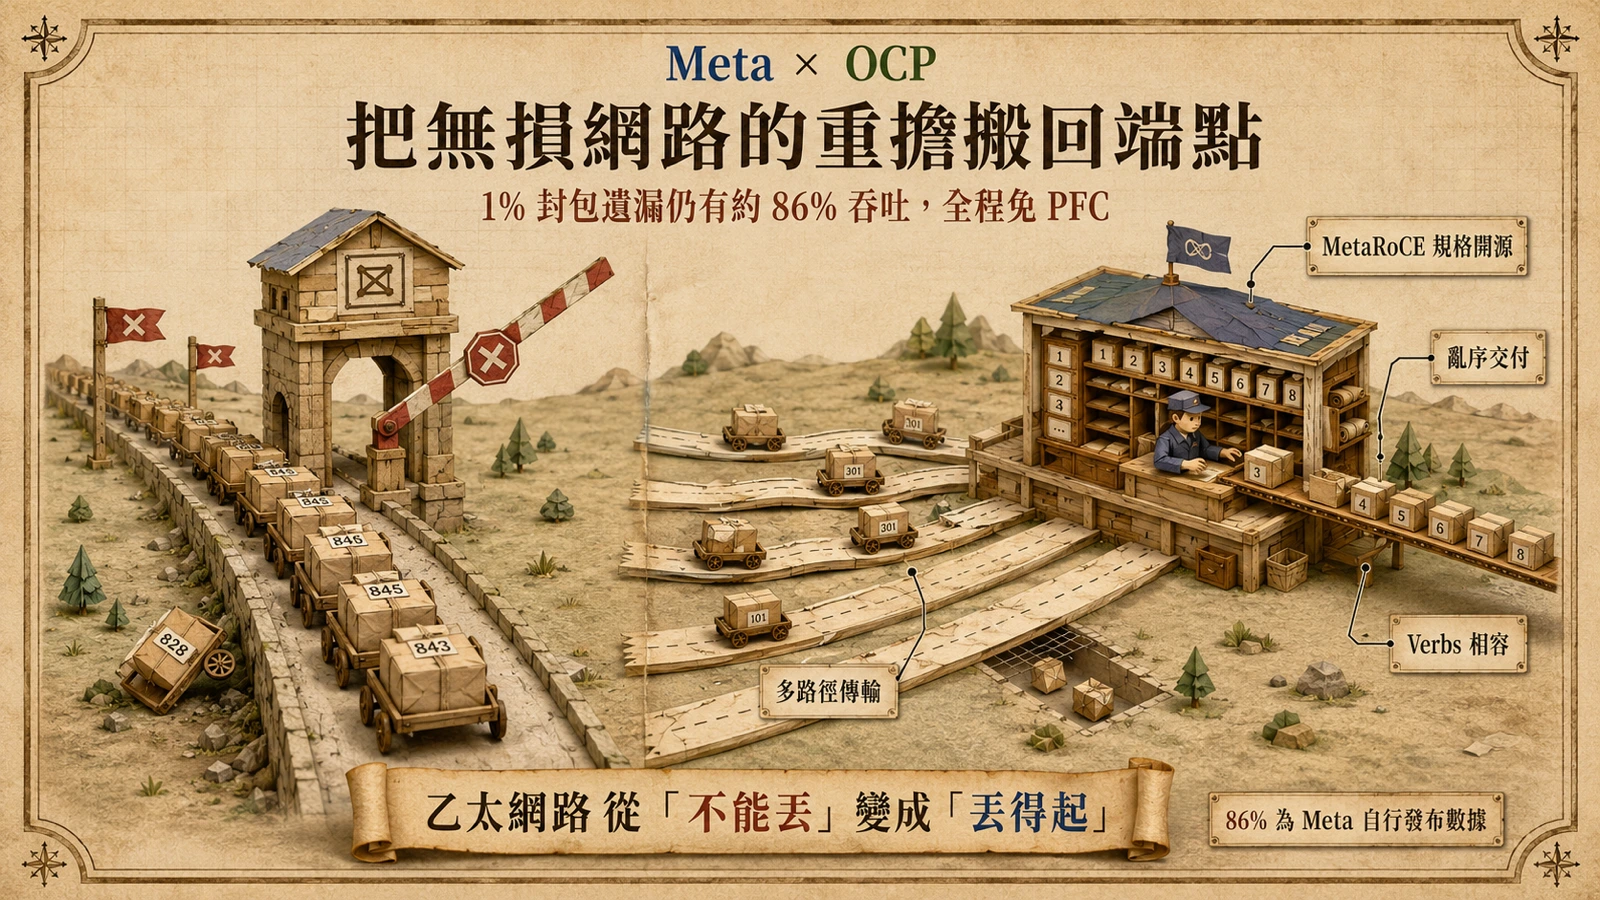
8 月 24 日,Meta 在工程部落格發布 MetaRoCE——一個從白紙重新設計(clean-sheet)的 RDMA 傳輸協定,目的是讓 AI 工作負載直接跑在通用乙太網路上。據Meta 工程部落格的發布文章,Meta 這次交付給開放運算計畫(Open Compute Project,OCP)的不只是一篇說明,而是三件套:完整協定規格、參考軟體實作,以及合規測試套件。任何交換器、網路卡或軟體廠商都可以依規格實作,再用測試套件驗證互通。
背景是 AI 叢集的規模正在快速長大。Meta 在對外說明中直指:傳統 RDMA 並不是為數百萬個加速器組成的叢集設計的。更具體地說,大模型訓練的每個反覆步驟都是集合通訊:每張 GPU 算完本地梯度後,全體要一起把梯度加總再廣播回去(all-reduce)。這種運算天生「等最慢的」——只要有一張卡的資料晚到,其他數萬張卡全部在原地等待,所以網路的尾延遲(最慢那百分之一傳輸的延遲)會直接變成訓練每一步的成本。這種「幾萬條連線同步呼吸」的流量模型,與傳統雲端「每條連線各自獨立」的假設完全不同,也是傳輸協定必須重造的根本原因。
MetaRoCE 的回答,是把傳輸層的可靠性機制從網路(交換器)搬到端點(網路卡):原生支援亂序交付、多路徑與容錯,搭配雙向擁塞控制,在免 PFC 的前提下朝百萬 GPU 規模提供高吞吐與低尾延遲。Meta 並強調,現有 RDMA Verbs API 與軟體棧不需修改即可運行——這是既有生態系能直接搬過來的關鍵承諾。
為什麼 RDMA 需要「無損」網路:PFC 的承諾與代價
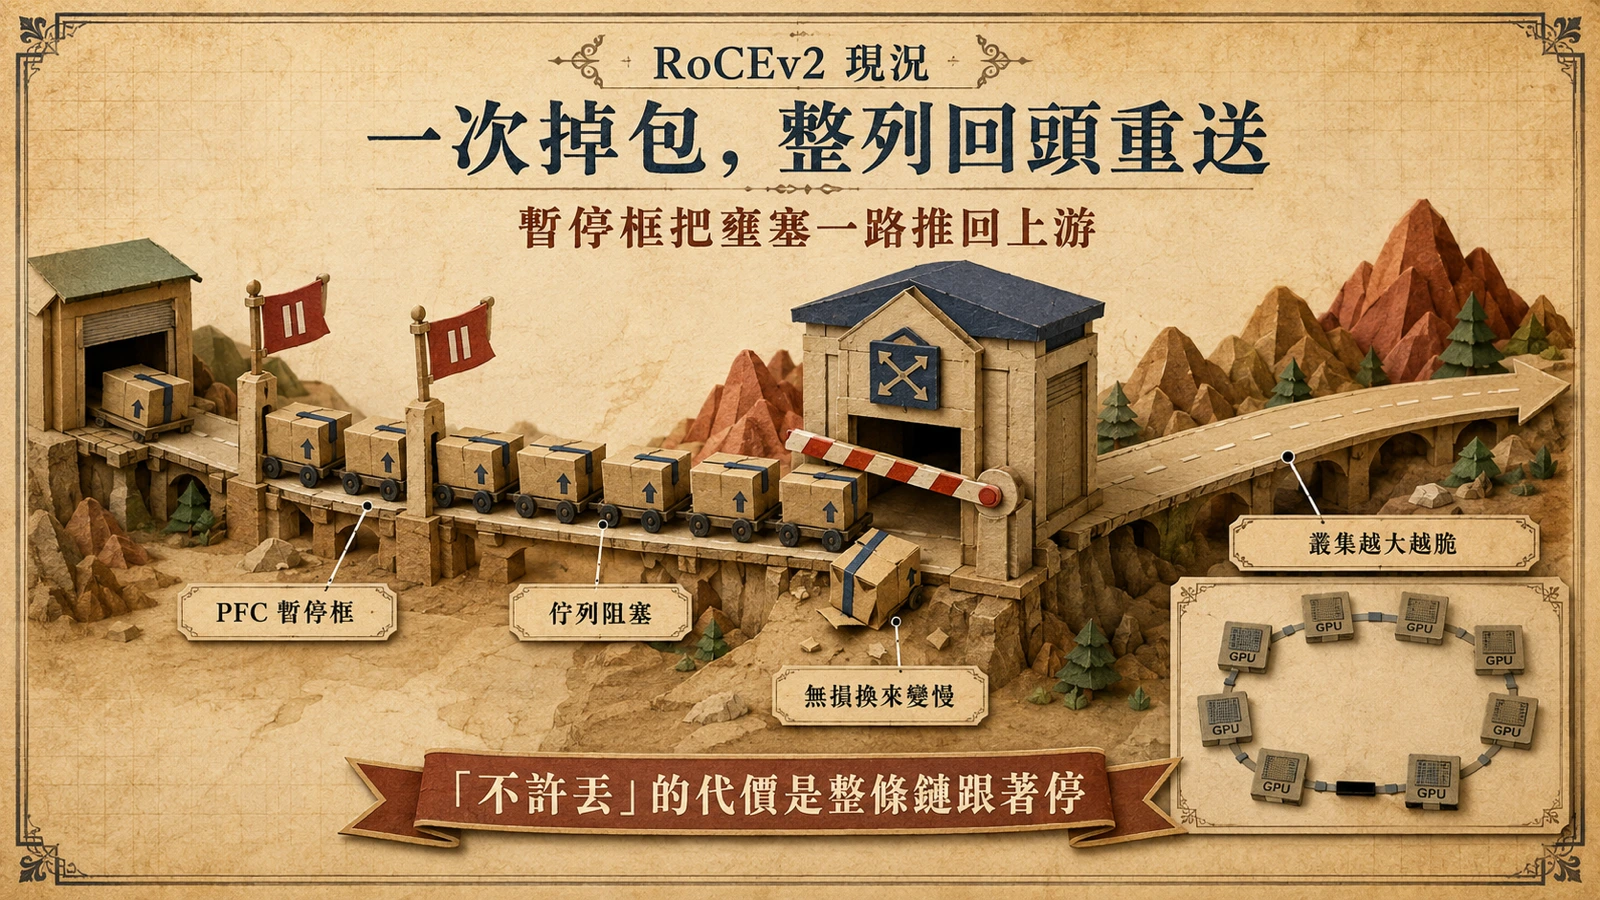
要看懂 MetaRoCE 改了什麼,得先回到 RDMA 在乙太網路上的原生缺陷。RDMA(Remote Direct Memory Access)讓一台機器直接讀寫另一台機器的記憶體,繞過作業系統核心、免複製,因此成為 AI 訓練集合通訊的骨幹。在 Meta 的環境裡,這些流量跑在一張專用後端 fabric 上:據Meta 2024 年的工程說明,這張 fabric 以非阻塞架構連接所有 RDMA 網路卡,採用 RoCEv2 協定,把 RDMA 服務封裝進 UDP 封包傳送。
問題正出在 UDP:它不保證送達,而 RDMA 傳統的可靠傳輸是「往回重送」式的——中途丟一個封包,已經送出的整批資料都要重來一次,丟包率只要小幅上升,吞吐就會崩塌。因此業界的標準解法是把乙太網路硬做成「無損」:啟用 PFC(Priority Flow Control,優先權流量控制),讓交換器在緩衝區將滿時向上游發出暫停框、禁止上游繼續送——用「不許丟」換「不會丟」。
PFC 在數千張 GPU 的規模大致可行,代價卻隨規模放大。暫停框是往回傳播的:一個熱點的壅塞會一路卡住上游交換器,形成佇列阻塞;暫停框連鎖還可能釀成風暴甚至死鎖。更麻煩的是,無損的保證高度依賴每台交換器的緩衝區設定與廠商實作,跨廠商、跨世代混搭時很難維持——而百萬 GPU 級的叢集,不可能永遠只用單一廠商的單一世代設備。
MetaRoCE 的解法:把傳輸智慧搬到端點,容許丟包而非禁止丟包
MetaRoCE 的核心翻轉,一句話可以講完:與其把網路做成不會丟包,不如讓端點丟得起。拆開來是四個設計。
第一,原生亂序交付。傳輸協定自己追蹤哪些區塊到了、哪些沒到,只補送缺漏的部分(選擇性重送),而不是整批回頭。丟一個封包的代價,從「整條流重送」降到「補一個區塊」。
第二,多路徑傳輸。既然端點能重排順序,資料就能同時灑到多條路徑上,把大流量的傳輸攤平到整張 fabric,而不是讓單一路徑被塞爆——路徑分散本身就是吞吐與穩定性的來源。
第三,雙向擁塞控制。接收端與發送端都參與壅塞訊號的產生與反應,讓佇列在爆掉之前就被控制住,而不是等爆掉之後靠 PFC 拉暫停。Meta 的說法是,這套設計的效能收斂到與具備壅塞感知的無損傳輸相當,但全程不需要 PFC。
第四,Verbs 相容。應用程式看到的仍是同一套 RDMA Verbs 介面,NCCL 等集合通訊庫與既有軟體棧不必改寫;換協定的成本被壓進網路卡與驅動層。對一個想成為產業標準的開放規格來說,這是能不能被採用的前提。
1% 封包遺漏還有 86% 吞吐:數字怎麼讀
整篇發布裡最該記住的數字是:據官方發布的數據,MetaRoCE 在 1% 封包遺漏率下仍維持約 86% 吞吐,到了 10% 的極端遺漏率仍能提供可用頻寬。對照組是傳統設計——仰賴無損網路的 RoCE 一旦失去 PFC 保護,丟包率爬升時吞吐會直接崩塌,因為每次掉包都觸發整批重送。
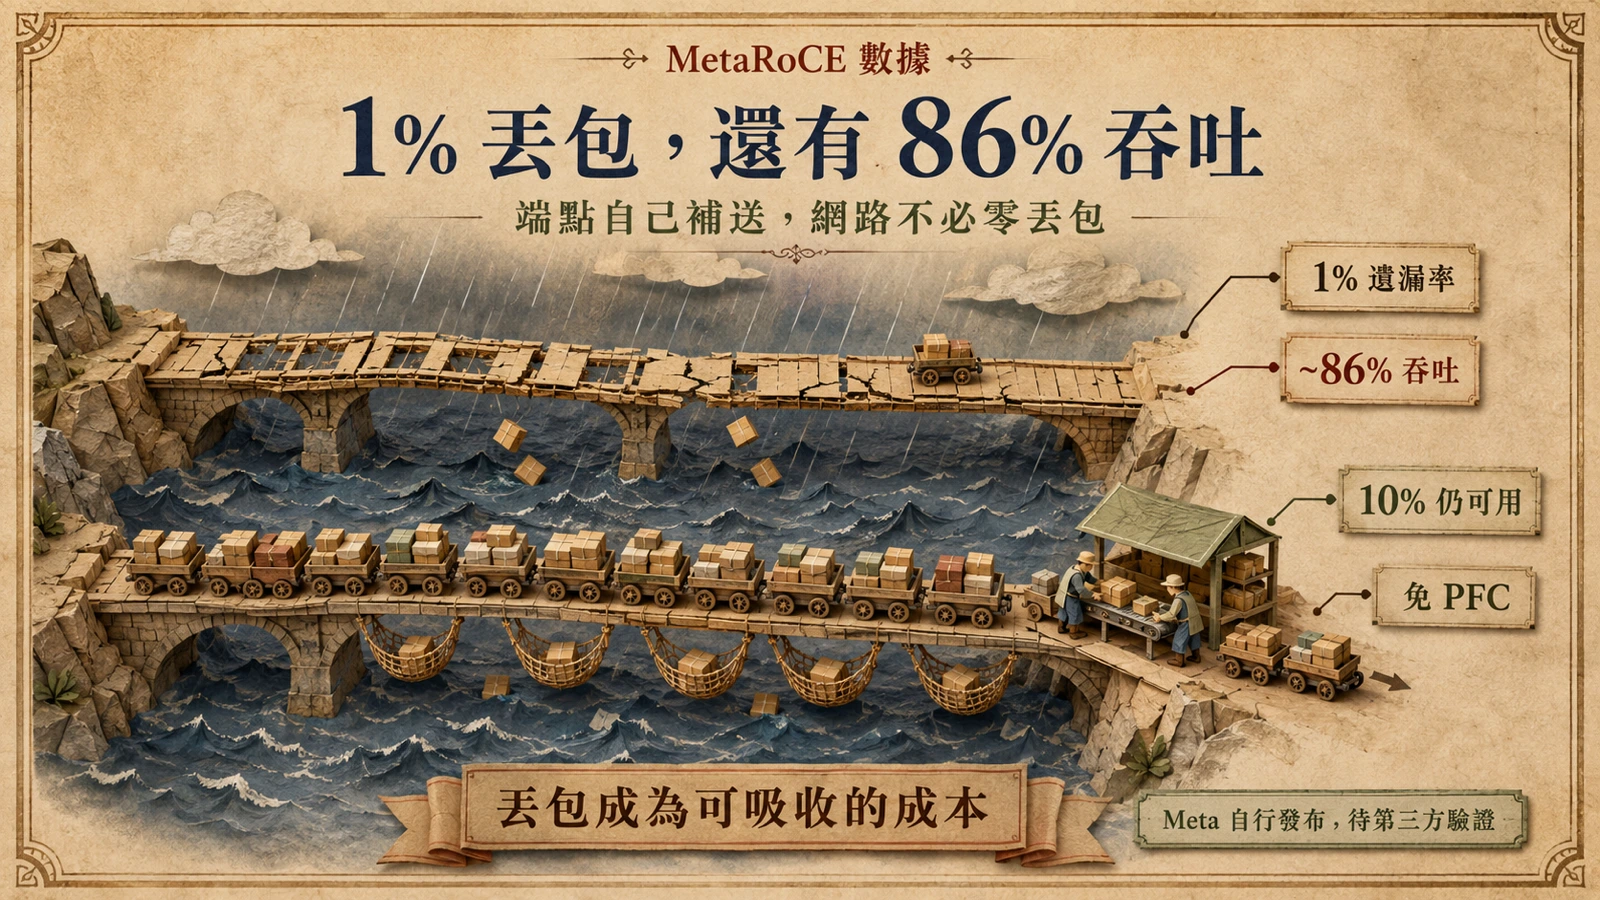
這個數字的實務意義大於字面:AI 叢集可以跑在「普通的」乙太網路上——不必逐台調 PFC 水位、不必擔心混搭廠商、不必把無損列為採購硬條件。用既有、量產、多供應商的零組件堆出超大叢集,正是 Meta 長年透過 OCP 推動的路線:規格先開放,多家廠商都能做,再用規模壓成本。
對採購端還有另一層意義:當「無損」不再是入場條件,選擇權就回到買方手上。過去組 RoCE 叢集,往往得整批採用同一家廠商的設備,並照其建議書逐台調校 PFC 與 ECN 參數,換廠商等於重調一輪;規格與合規測試套件開放之後,不同廠商的交換器與網路卡可以用同一套標準驗收,混搭與替換的摩擦成本大幅下降。這是把網路從「整批綁定的專屬工程」推向「可驗收的標準品」的一步。
不過讀者該按住興奮。86% 是 Meta 自行發布的數字,測試拓撲、流量模型與比較基準的完整細節,要以 OCP 上的規格與測試套件文件為準,目前尚無第三方獨立重現。合規測試套件的價值之一,正是讓外部驗證變得可執行——這也是為什麼「連測試都一起開源」比單純公布一篇論文更有分量。
從 RoCEv2 到 MetaRoCE:Meta 自己走過的三年
MetaRoCE 不是憑空出現。它的前代,就是前文那張 RoCEv2 後端 fabric:在 Meta 2024 年的說明裡,這張網路靠 PFC、ECN 等工程手段把無損保證營運到當時的訓練規模,相關經驗並整理成論文發表於 SIGCOMM 2024,成為理解「為什麼要重造」的完整生產記錄。
值得注意的轉折在路徑選擇:2024 年的做法是把既有協定「調」到能用;2026 年的 MetaRoCE 則承認這條路有規模天花板,改為重寫傳輸層。從調校既有協定到 clean-sheet 重設計,這個時間差本身說明了叢集規模這兩年的變化速度——當叢集從數萬 GPU 朝數十萬、百萬 GPU 邁進,為通用資料中心設計的機制,其維運成本終會超過重造的成本。
同一方向上的其他人:Resilient RoCE 與 Ultra Ethernet
MetaRoCE 並非唯一往這個方向走的。NVIDIA 的網路文件把現況說得很直白:據DOCA 文件對流量控制的說明,PFC 的設計目的就是「為 RoCE 流量提供無損服務,為標準乙太網路流量提供盡力而為服務」——在主流乙太網路生態裡,RoCE 的可靠性長年預設綁在 PFC 之上。NVIDIA 推動的「Resilient RoCE」同樣瞄準這個痛點,讓 RoCE 能在不啟用流量控制的有損網路上運行。差別在於,MetaRoCE 是從白紙重設計的傳輸協定,而且這次把規格、參考實作與合規測試一併公開交給 OCP,讓任何廠商都能實作並驗證——把一家公司的韌性,變成整個產業可以檢驗的預設。OCP 本身正是 Meta 十多年前參與創立的開放硬體組織,Meta 的伺服器與資料中心設計長年透過它開放;MetaRoCE 延續的,是同一條「把自研基礎建設變成產業標準」的路線。
更大的背景是乙太網路與 InfiniBand 之爭。InfiniBand 是封閉、垂直整合的方案,在超大叢集的效能紀錄強;而 Meta 這類超大買家長期押注乙太網路生態的開放性與成本曲線,Ultra Ethernet 聯盟同樣朝多路徑、亂序容忍與更強擁塞訊號的方向走。MetaRoCE 的加入,等於把超大型買家的自研成果開源化,讓「乙太網路承載 AI」這條路多了一個可合規驗證的具體規格。
誰該現在關注、誰可以先等等
三種讀者的行動建議不同。網路設備與網路卡廠商是最直接的受影響者:規格與合規測試套件已在 OCP,何時實作、何時送測,直接決定能否切入下一代 AI 叢集的設計週期。自建訓練叢集的大型團隊,值得追蹤 OCP 文件與參考實作的進展,特別是硬體卸載時程——軟體參考實作能驗證正確性,但線速吞吐終究需要網路卡硬體支援。一般企業與雲端使用者則無需任何行動:這是資料中心內部骨架的更換,不影響對外服務,既有 RoCEv2 環境也不會失效。
後續值得追蹤三個指標:OCP 上的規格與參考實作何時可供下載、第一家通過合規測試的第三方廠商是誰、Meta 自己的下一世代叢集是否以 MetaRoCE 為基礎。三者分別對應規格落地、生態採用與規模驗證——在此之前,MetaRoCE 是一個方向明確、證據仍由單一公司提供的承諾。
而需求端早已把規模撐起來:從OpenAI 在喬治亞州的 3.2GW 資料中心這類建設可以看出,AI 園區的電力合約已經以 GW 計。傳輸層的重造是這波建設中最少被看見的一段,卻決定訓練叢集還能不能繼續長大。