一天 500 兆 Token:央視財經揭露的新數字
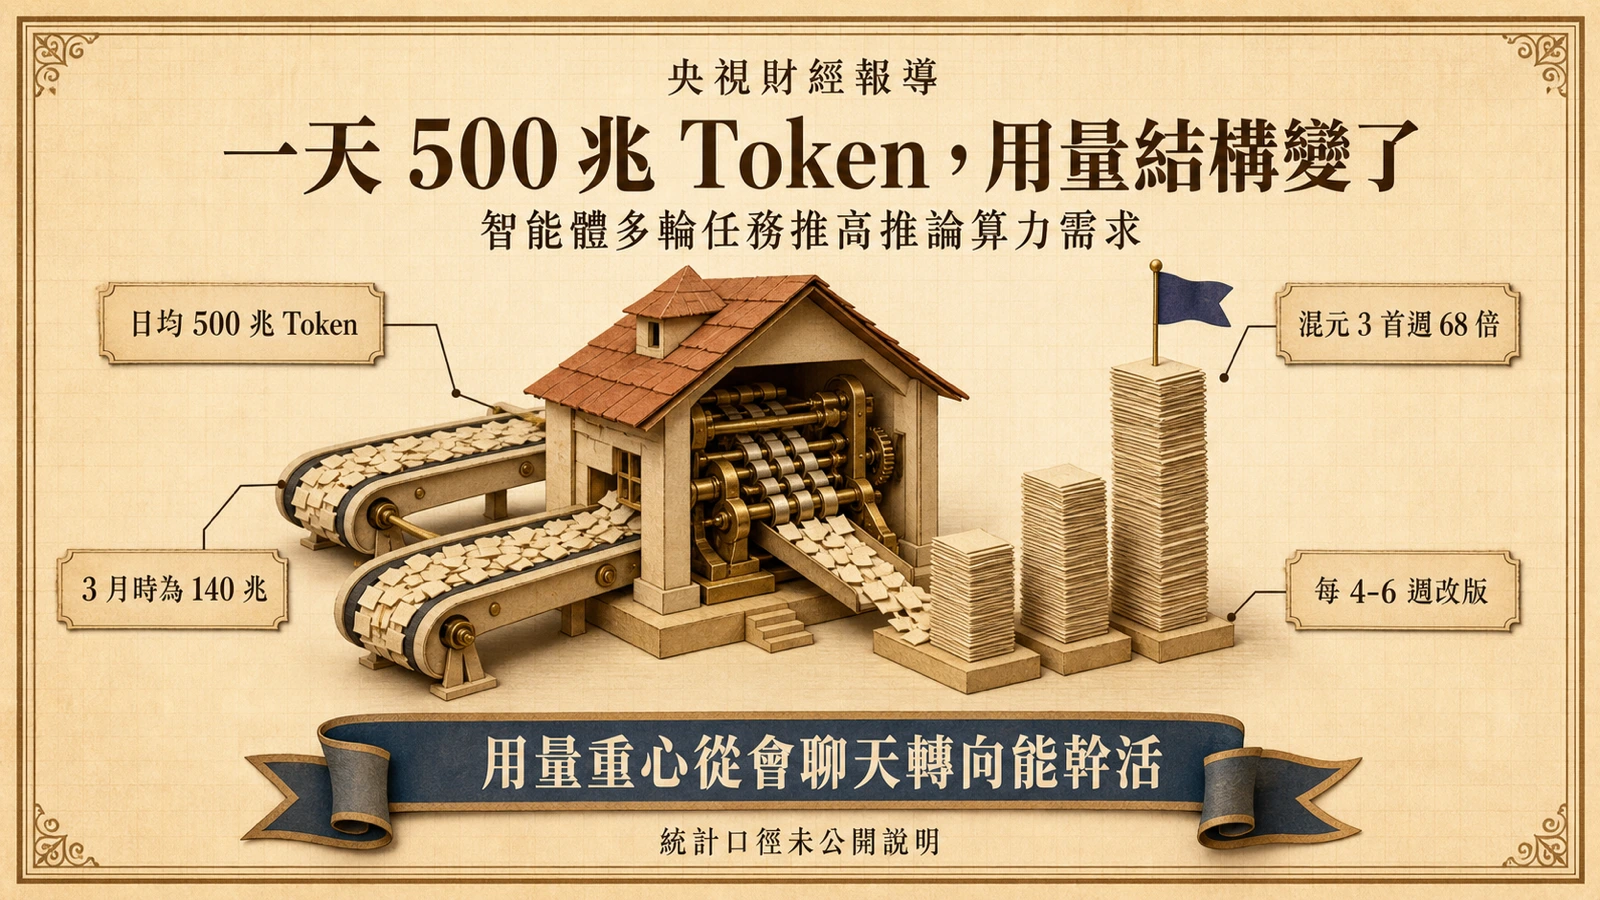
8 月 27 日,央視財經釋出了一個把中國 AI 應用規模具象化的數字:隨著人工智能應用加速落地,截至 2026 年 6 月,中國日均詞元調用量已突破 500 萬億。詞元是中國官方對 token 的譯名,也就是大模型處理與計費的最小單位;500 萬億即台灣慣用的 500 兆,換算下來平均每秒約 58 億個 Token 在中國境內的模型服務上被消化。這不是單一廠商的數字,而是把全中國大模型調用總量放到同一個刻度上的全國口徑。
報導給出的定性判斷同樣值得記錄:全球大模型正處於競爭最激烈、迭代最快的階段,而中國大模型已在全球競爭中位居第一梯隊。報導引述業內人士的觀察,指人工智能正從「會聊天」走向「能幹活」,智能體開始規模化落地,一次任務需要反覆檢索、讀取上下文、呼叫工具、進行多輪回饋,推理算力需求隨之爆發。換句話說,這則報導的重點不是「用量很大」,而是用量的結構變了——從一次性問答,轉向會自己跑完整套流程的智能體。
詞元經濟:Token 被寫進政策文件的原因
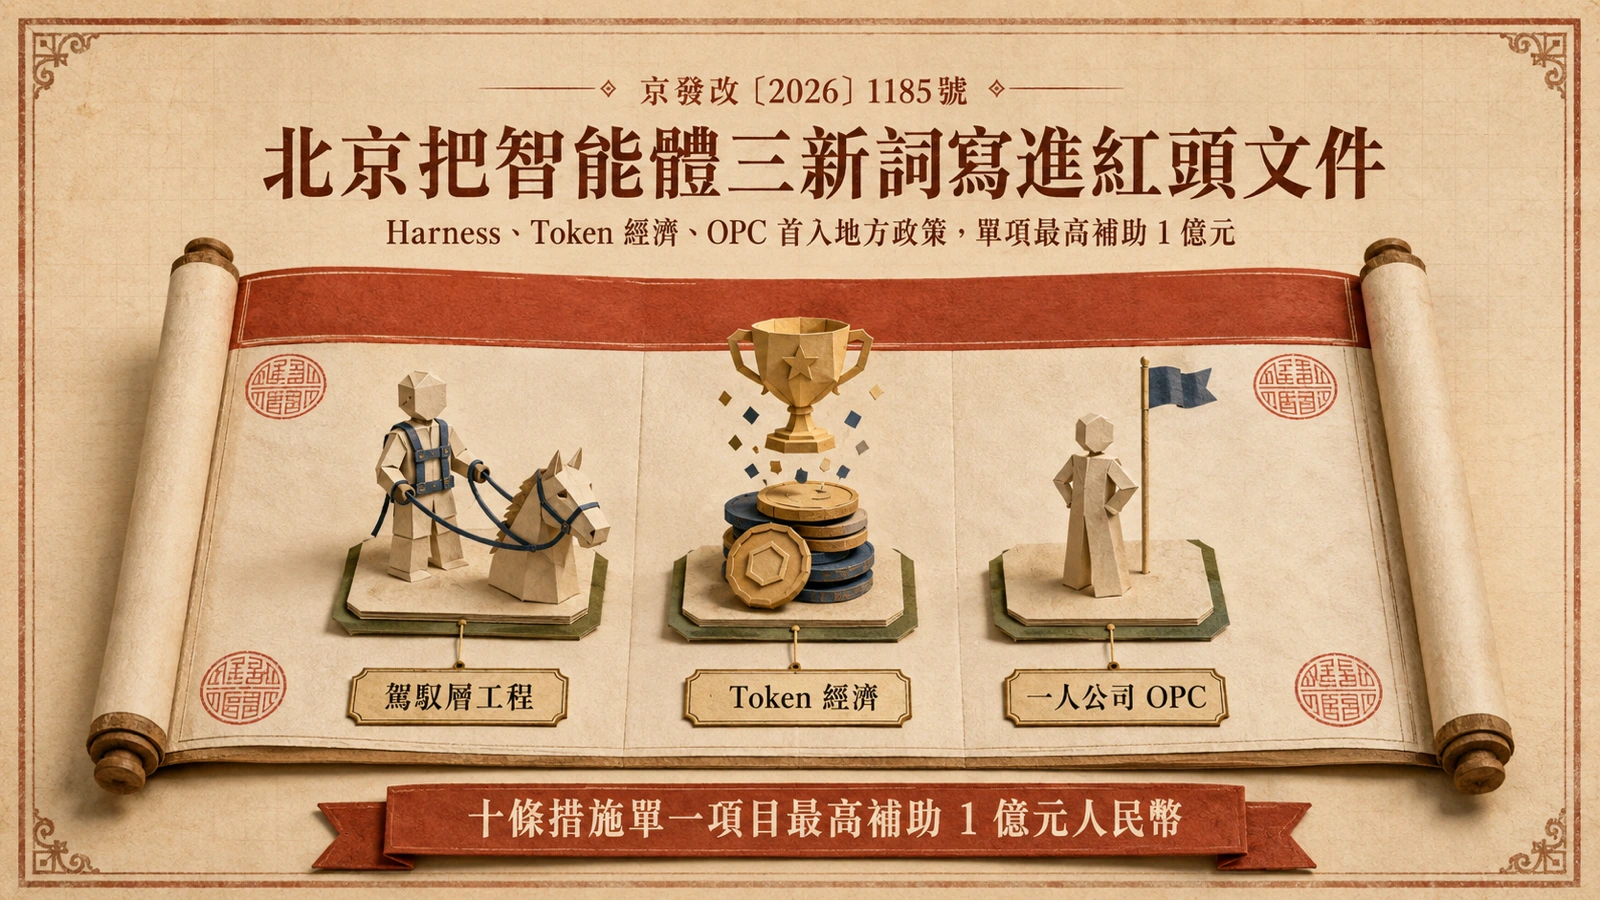
「詞元」這個詞值得停下來看。它不是媒體自創的行話,而是中國官方語境對 token 的正式譯名——央視財經的報導與各大媒體轉述,標題裡用的正是「詞元調用量」,直接把模型調用當成可以統計、可以比較的經濟量。地方層級也出現同樣的訊號,Token 價值計費等概念也被寫進北京市的智能體政策文件(見〈北京智能體新政〉)。
把 token 當成經濟指標來統計,背後的邏輯類似把用電量當成經濟活動的代理指標:模型呼叫次數乘上每次呼叫的長度,約略等於整個社會「讓 AI 做事」的總量。這對台灣讀者有個翻譯層的提醒:中國文件裡的詞元調用量,就是國際語境的 token usage;讀中國官方與媒體的 AI 統計時,單位換算(萬億等於兆)是第一個要過的關卡,第二個關卡則是統計口徑——這點留到最後一節展開。
500 兆的全球對照:推論需求不是中國獨有
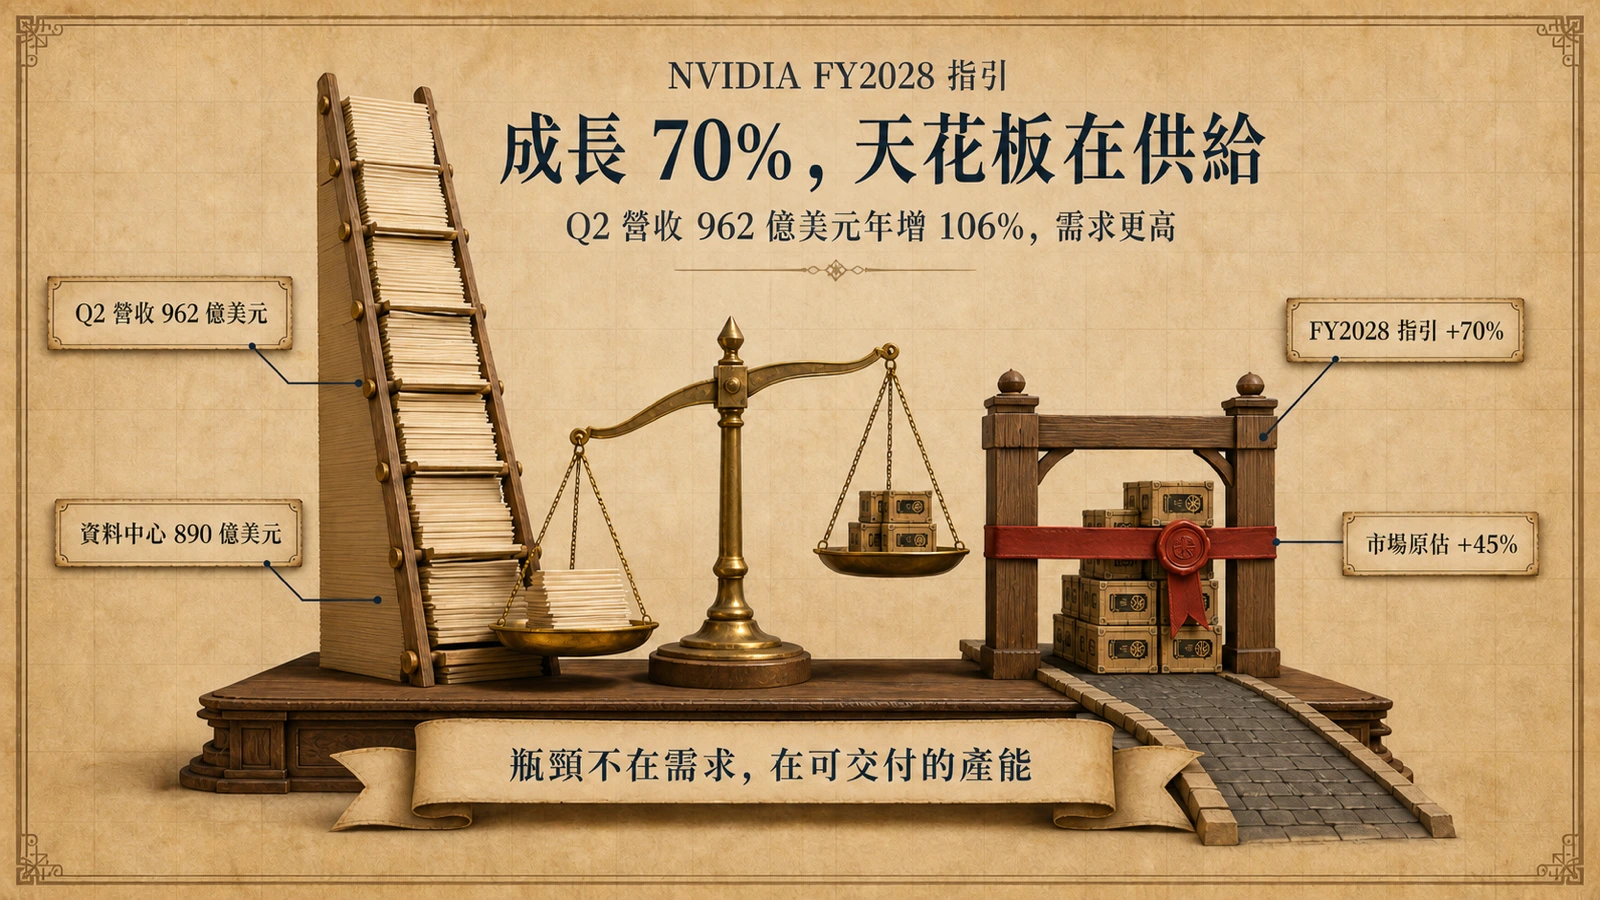
要判斷 500 萬億有多陡,單看這則報導並不夠:它給的是「突破」式的門檻表述,沒有附上前值,也沒有說明統計範圍,轉述媒體同樣沒有補上可比較的基期。同一時間軸上能對照的是產業端的數字——NVIDIA 前一天公布的財報顯示,單季資料中心營收 890 億美元、年增 117%,黃仁勳並把話說得直白:現在,算力就是收入(見〈NVIDIA 財報與 70% 指引〉)。國家級的詞元統計與跨國晶片財報,在不同戰場指向同一件事:推論流量正在成為 AI 產業的主要計價單位。
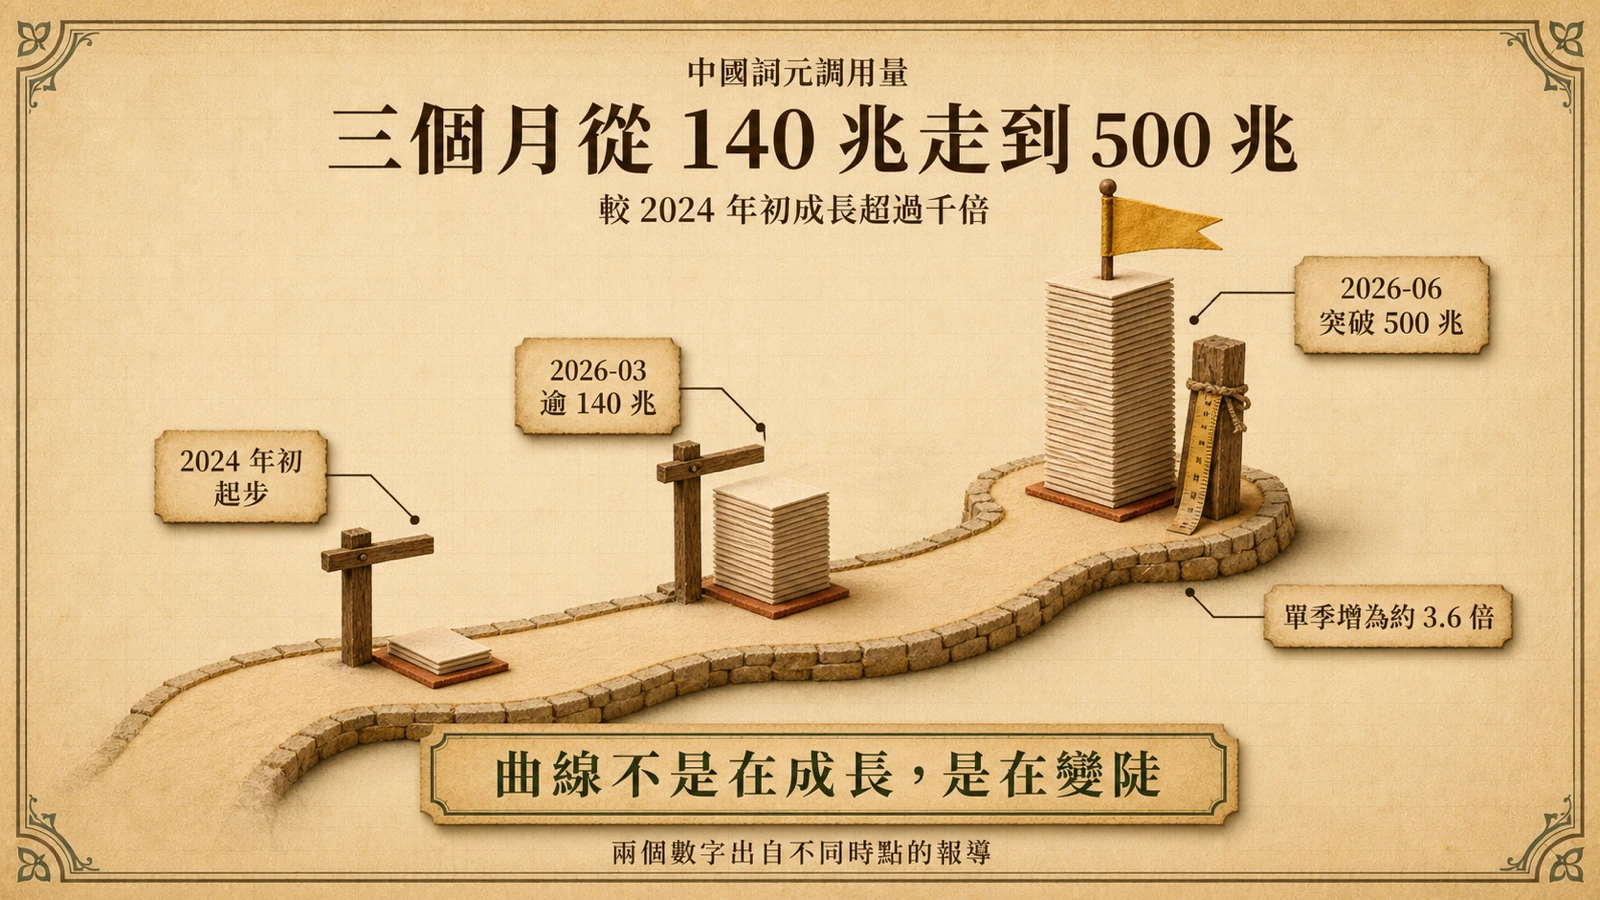
同樣的結構變化正在各地同步發生:企業端把預算從訓練轉向推論、智能體把每次任務拆成多次呼叫;中國的特殊之處在於統計被官方化、指標被政策化,詞元調用量成了被正式追蹤的國家級數字,而不是個別雲端廠商財報裡的營運指標。
智能體為什麼吃 Token:一次任務等於十幾次往返
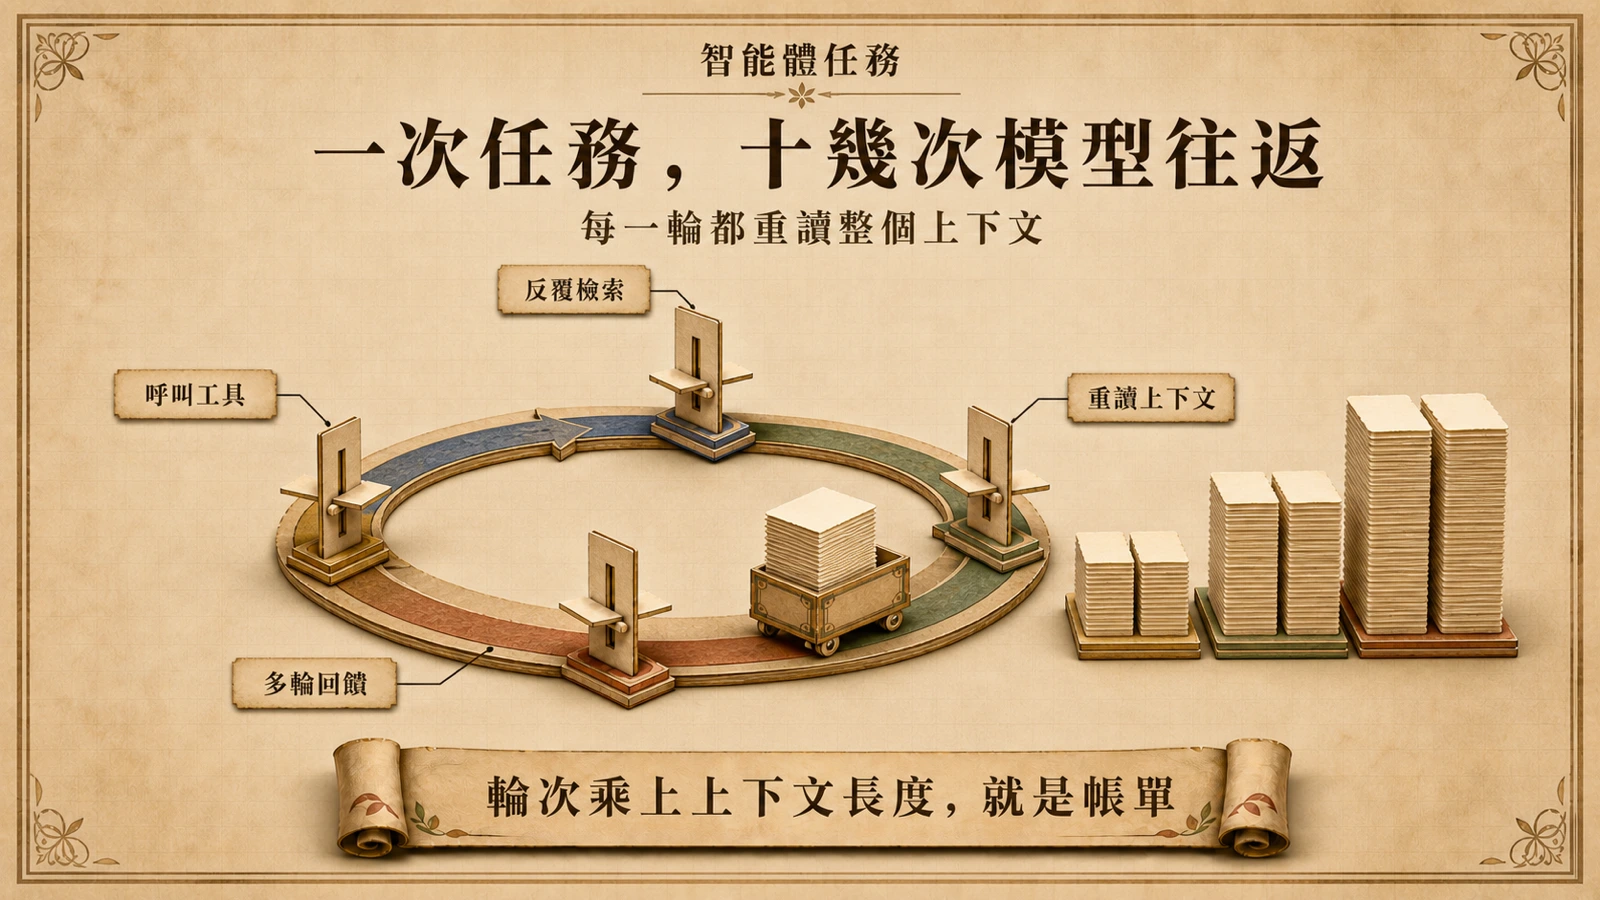
聊天機器人的用量好懂:使用者輸入一段、模型回一段,一來一往兩個方向。智能體完全不是這個帳。報導形容,一次任務需要反覆檢索、讀取上下文、呼叫工具、進行多輪回饋——拆開看,每一項都是模型呼叫:檢索要模型下查詢並讀結果、呼叫工具前後要模型規劃與判讀、出錯要模型修正再試。關鍵在於每一輪呼叫,模型都得把整段對話與任務狀態重讀一次,輸入 Token 隨輪次與上下文長度疊加,而報導也點出各大廠持續加大訓練投入、模型參數量與上下文窗口不斷擴大,又讓單次輸入變得更長。
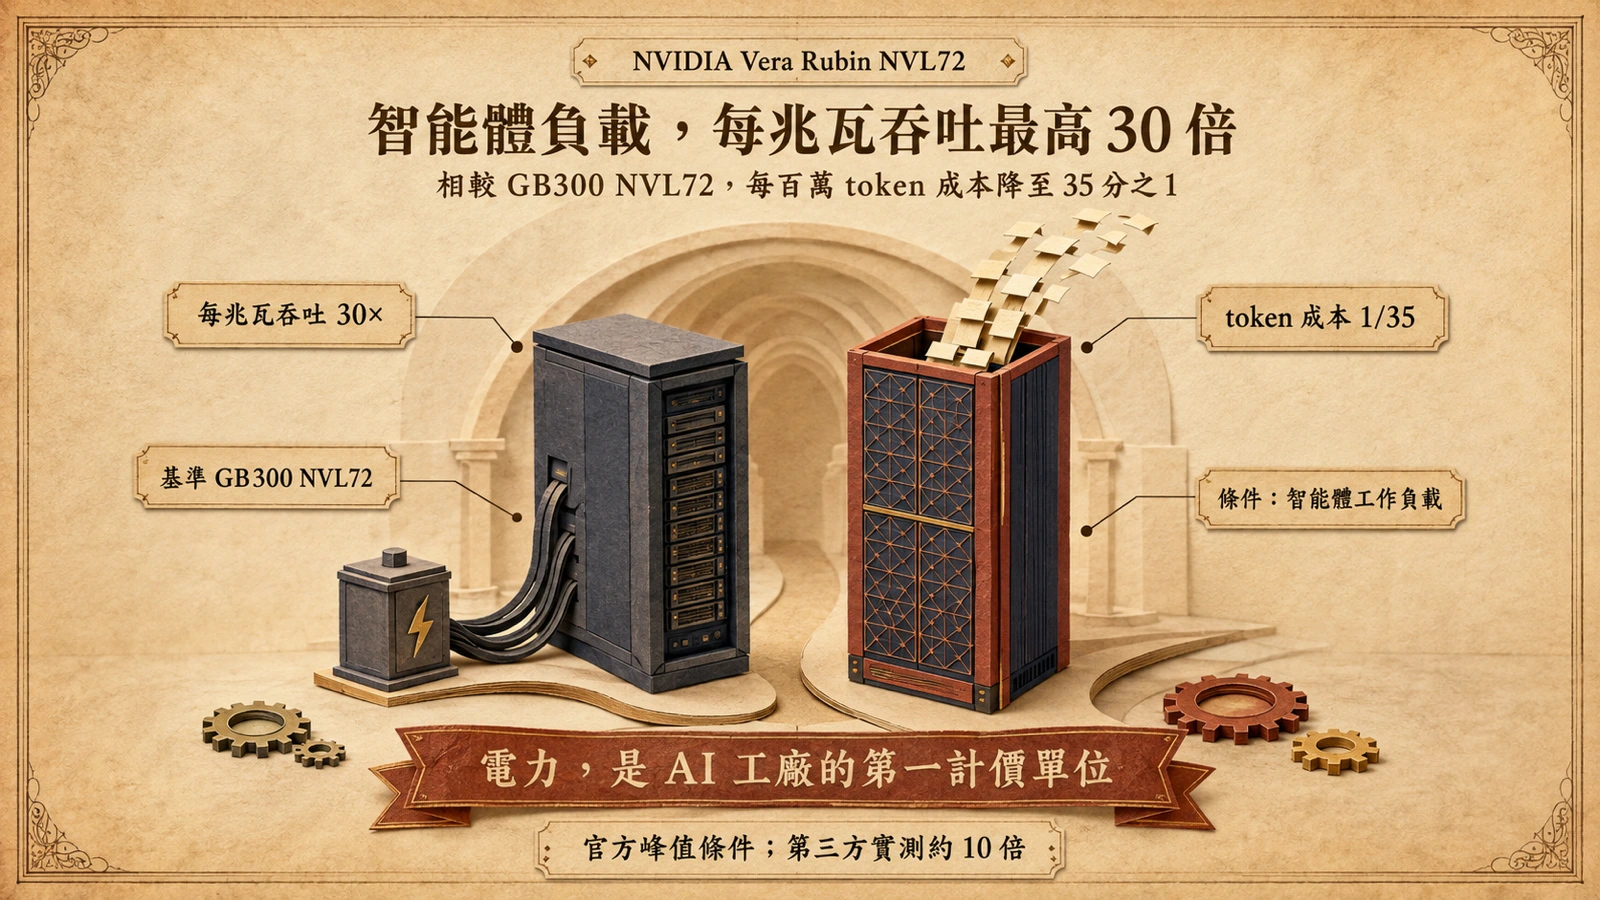
這也是為什麼硬體端已經把智能體當成第一假設。NVIDIA 新一代機櫃系統的官方實測,就直接以 AI 智能體工作負載為基準:每兆瓦吞吐量較 GB300 NVL72 最高提升 30 倍,同一份數據把每百萬 token 成本列為核心指標。當晶片廠用 token 成本定義新世代產品,等於承認推論流量的主導權已經從聊天轉到智能體手上。
混元 3 首週 68 倍:換代直接引爆用量
報導裡最硬的單點數字來自騰訊。騰訊公司智慧產業總經理劉峰表示,混元 3 正式版上線第一週,Token 調用量比上一代混元 2 增長 68 倍。68 倍首先要冷讀:新模型上線首週對比的是前代的常態基線,中間摻有新鮮感、遷移潮與可能的促銷計價,倍數不能直接等同於真實需求膨脹 68 倍。但它至少說明兩件事:旗艦換代已經是一次流量事件,用量會在新舊版本之間快速搬家;而新一代模型被大量用在智能體場景,單一任務的 Token 消耗本來就比聊天高出一個量級。
換代的節奏也在壓縮。稀宇科技(MiniMax)開放平台首席架構師馮雯在 IT 之家的報導 中說,2025 年下半年各廠商希望每 3 個月迭代一次模型,如今每 4 至 6 週就要發布一個新模型。模型每月一換、用量跟著版本跳,推論效率就成了所有廠商共同的成本戰場——騰訊混元團隊自己就開源了推測解碼框架,把推論加速 2.4 倍(見〈AngelSpec 推測解碼框架 DFly〉)。用量暴增的另一面,是每一家都想讓單一 token 更便宜。
智算中心與長約:算力端的回應
用量與換代的壓力,直接反映在算力建設。報導指出,為爭奪算力資源,互聯網大廠加速布局 AI 智算中心,並簽署長期合作協議鎖定資源;遠景科技集團人工智能算力中心總經理鄭子浩的說法是,AI 智算中心的建設呈井噴式發展,支撐來自用戶給到的長期穩定訂單承諾。報導並指多地正加速布局國產詞元工廠與智算綜合體,推動國產算力產業鏈從「產品驗證」邁向「批量交付」——「詞元工廠」這個詞本身,就是 token 被當成可量產商品的證據。
這條供給曲線的緊俏有全球背景,但中國多了一層出口管制下的國產替代:詞元工廠吃的是國產晶片,國產算力鏈能否批量交付,決定這條 500 兆的曲線還能不能繼續往上畫。
對開發者與企業,這波供需變化有兩個實際後果。其一是容量:大廠用長約鎖定資源,意味著公開市場的算力在高峰期更貴也更難即取,智能體上線前的容量規劃要提前。其二是計價:以量計費的環境裡,Token 單價因競爭持續下探,但智能體的多輪消耗會把帳單乘回去——成本模型該用「任務」而不是「訊息」當單位來估。
數字的界線與後續該追蹤的訊號
最後要替這個數字畫界線。其一,統計口徑未見公開說明:現有的轉述報導都沒有交代涵蓋哪些業者與服務、是否計入免費額度與快取命中、輸入與輸出是否合併計算——同樣叫「調用量」,不同計法可以差出好幾倍。其二,量不等於價值:單價下降會自然放大調用量,68 倍也含有低基數與嘗鮮效應。其三,「全球第一梯隊」是央視的定性說法,不是可回查的評測排名,不宜直接當作模型能力的結論。
值得按表追蹤的訊號:官方是否將詞元統計常態化發布,若有,口徑說明是第一個要看的附件;下一期日均數字能否附上可比較的前值,讓 500 兆從單一門檻變成可追蹤的序列;智算中心「批量交付」的實際產能與簽約產能之間的差距;以及出口管制下國產晶片實際承載的推論比例。500 兆是驚人的快照,但要判斷它是起點還是高原,得等下一個可比較的數字——而它能不能持續往上,最終由算力供給能不能跟上決定。