v6.0 釋出:第四種模型類型上線
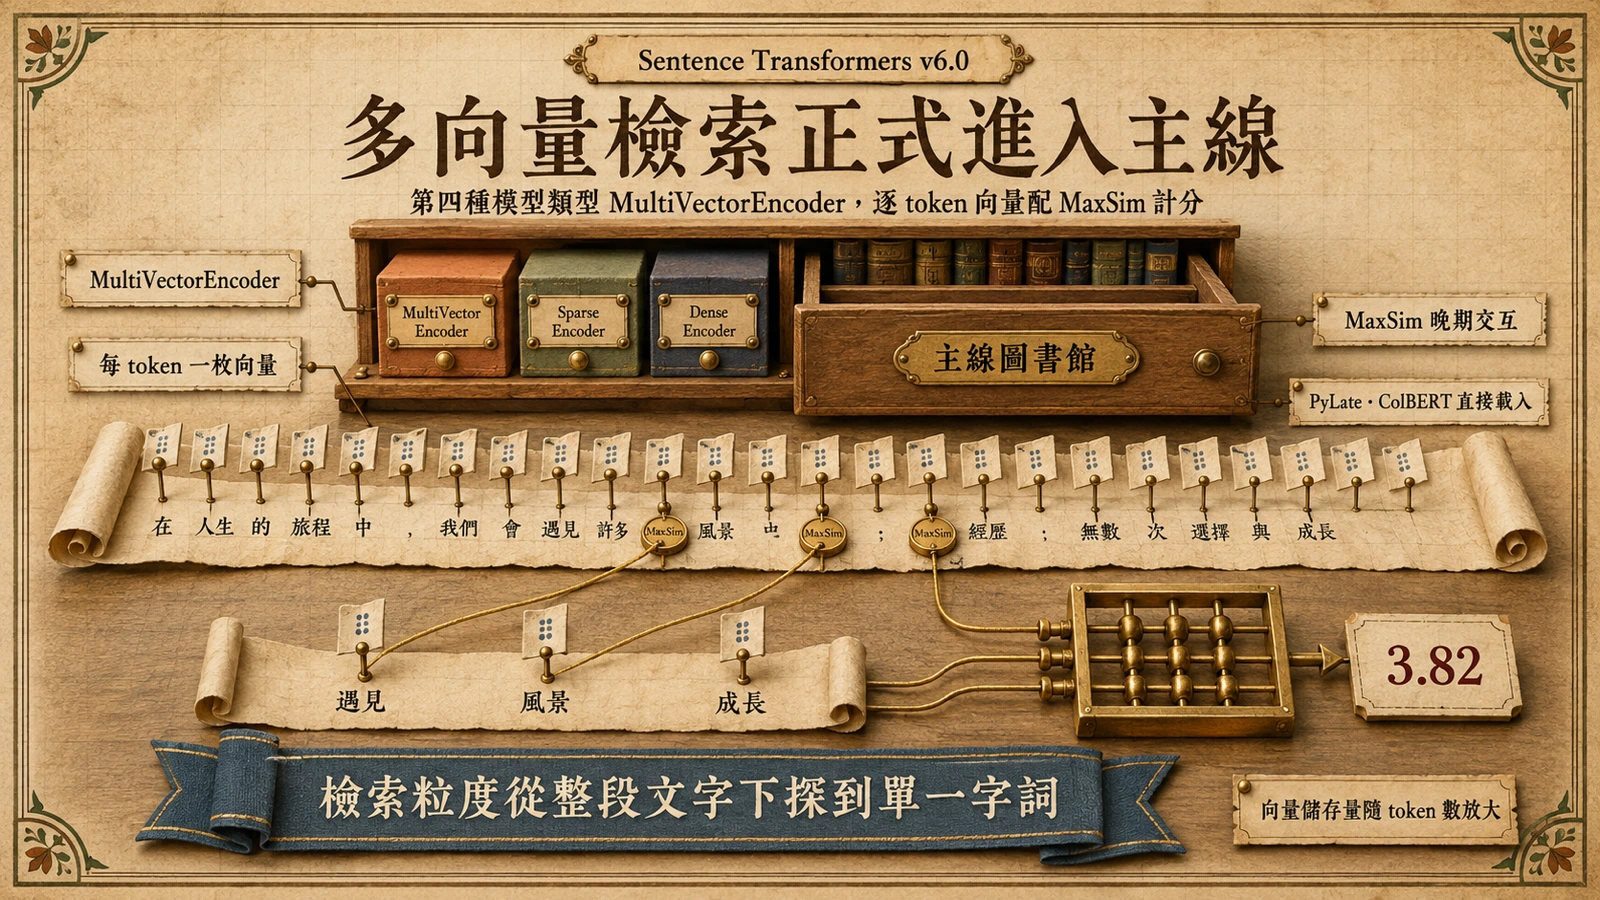
在語意搜尋與 RAG 的世界裡,Sentence Transformers 是被下載與引用最頻繁的嵌入模型工具箱之一:載入預訓練模型、計算語意向量、微調出自己的檢索模型,都繞不開它。8 月 18 日,這個函式庫釋出 v6.0.0,版本標題一句話講完重點——MultiVectorEncoder for ColBERT 與晚期交互模型。換言之,ColBERT 風格的多向量檢索,從此成為主線功能。
官方文件把 MultiVectorEncoder 定位為第四個模型家族,與既有的單向量稠密模型、稀疏詞彙模型並列。維護者 Tom Aarsen 在釋出宣傳中說得更直白:ColBERT 式的晚期交互模型,如今是這個函式庫的一等公民。
「第四種模型類型」聽來平淡,放在檢索工程的脈絡裡卻是個分水嶺。過去想用 ColBERT 式模型,開發者得在 sentence-transformers 之外另起爐灶;從 v6.0 開始,訓練、微調、推論到檢查點分享,全部回到同一套主流 API 底下。而且這次更新不是憑空發明,而是把一條在函式庫外長出來的生態整併回家——故事要從 PyLate 說起。
單向量壓縮掉了什麼
要理解多向量模型解決什麼問題,得先看單向量模型的根本取捨。官方部落格用一句話把差別講清楚:一般的嵌入模型把整段文字壓縮成一個向量,多向量模型則為每個 token 各保留一個向量。
「一個向量代表整段文字」是效率上的聰明設計:文件端的向量可以離線預先算好、存進向量資料庫,查詢時只需算一次相似度就能排序。但壓縮必然丟失細節——當文件裡只有一小段話、甚至一個專有名詞與查詢真正相關,這個線索會被稀釋進整段文字的平均之中。文件愈長、主題愈雜,問題愈嚴重:舉個例子,一份數百字的技術文件被壓成單一個 768 維向量後,「剛好提到那個 API 參數」與「完全沒提」在向量空間裡可能只差一點點。
多向量模型保留 token 級的粒度:文件裡每個字都帶著自己的向量,查詢可以對到「字」,而不只是對到「整段話的大意」。這正是 ColBERT 自 Stanford 團隊提出以來的核心主張——與其把所有證據攪進一鍋粥,不如讓每個字各自留下指紋,相關性判斷自然更細。
MaxSim:晚期交互的計分方式
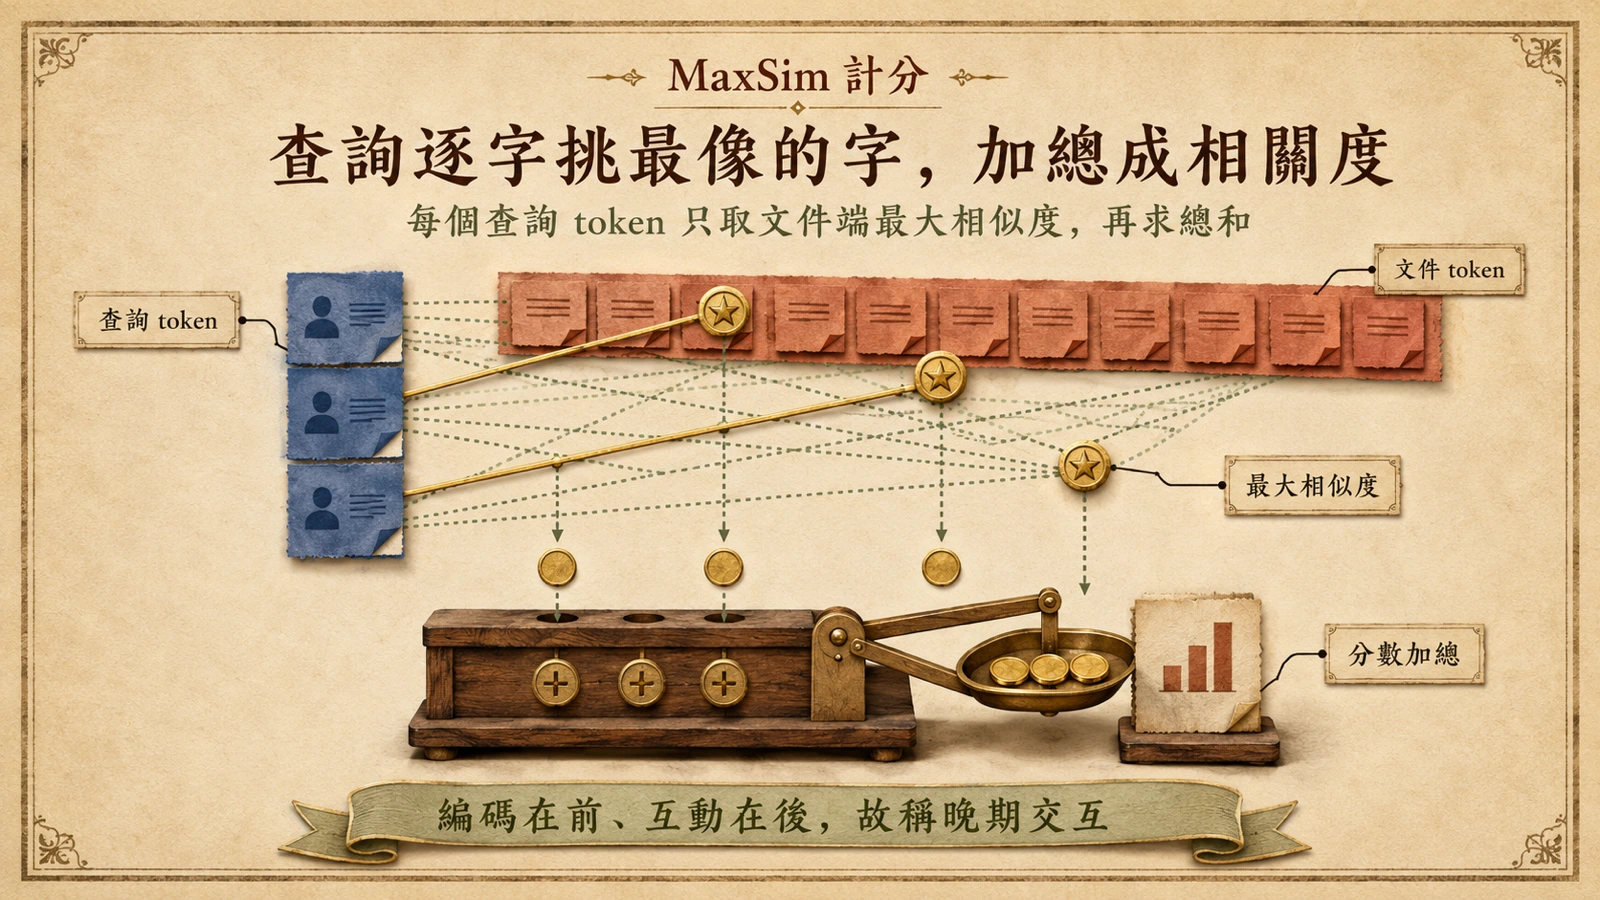
多向量模型的計分函式叫 MaxSim,概念並不複雜:查詢端的每個 token,各自在文件端所有 token 裡找出相似度最高的一個,再把這些最大值加總,就是這份文件對這個查詢的分數。換個說法,查詢的每個字都在問:「文件裡有沒有哪個字最像我?」每個字都得到好答案,總分就高;只要有幾個字在文件裡找不到著落,分數就被拉低。
這種「先各自編碼、查詢時才互動」的設計,正是「晚期交互」(late interaction)名稱的由來。放在檢索模型的光譜上看會更清楚:一端是雙編碼器(bi-encoder),查詢與文件各壓成一個向量、算一次相似度,最快、可以預先建索引,但互動最少;另一端是交叉編碼器(cross-encoder),把查詢與文件串在一起送進模型深層互動,品質最好,但文件端無法預先計算,在百萬級語料庫上逐一跑一遍的成本令人卻步。PyLate 論文對晚期交互的位置給出簡潔的定位:它在交叉編碼器的檢索品質與單向量雙編碼器的效率之間,取得了具吸引力的平衡。
換句話說,多向量不是要取代單向量,而是在「快但粗」與「準但慢」之間,多給開發者一個可調的選項。
從 PyLate 到主線:一次生態整併
v6.0 的 MultiVectorEncoder 不是憑空冒出來的功能,而是一場生態整併的收尾。ColBERT 風格模型雖然品質出色,長期卻卡在工具鏈破碎:訓練要一套、索引檢索要另一套,門檻把多數團隊擋在外面。LightOn 團隊為此開發了 PyLate——一套疊在 sentence-transformers 之上的函式庫,論文於 2025 年 8 月登上 arXiv,開宗明義寫道:PyLate 旨在加速晚期交互模型的研究與實際應用。它提供與 sentence-transformers 相近的使用體驗,以及稱為 FastPLAID 的檢索索引,讓訓練與部署第一次變得親民。
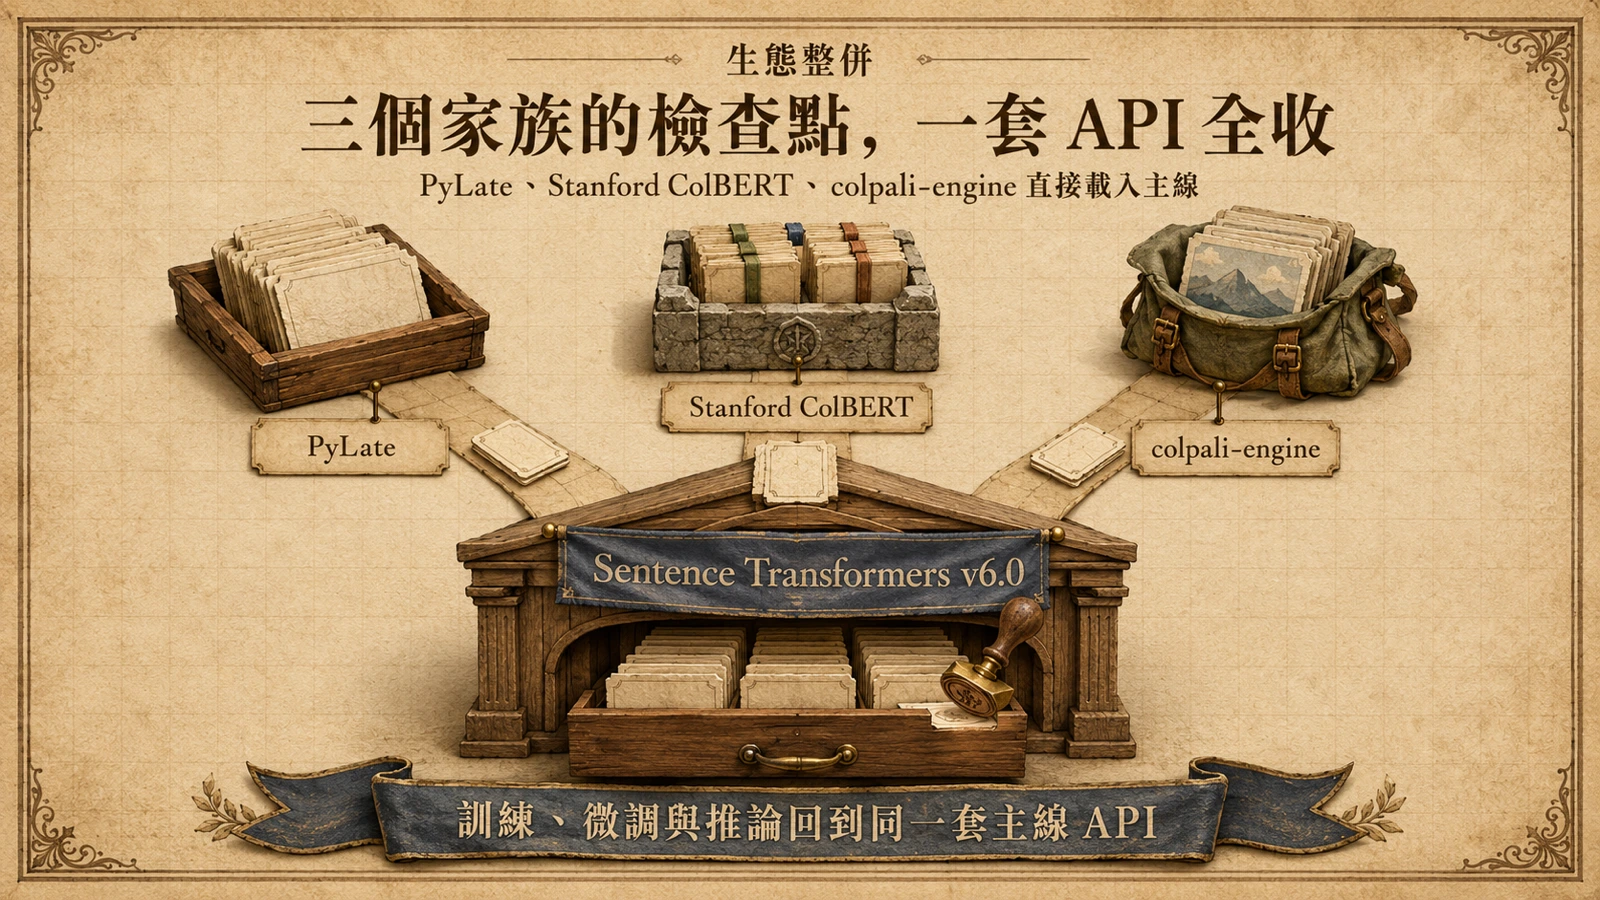
v6.0 把這條路線正式收編。依版本說明,來自 PyLate、Stanford ColBERT 與 colpali-engine 三個家族的檢查點,現在都能直接載入 MultiVectorEncoder 使用。第三個名字尤其值得注意:colpali-engine 是文件影像檢索專案 ColPali 的引擎,處理的是「畫面即文件」的場景——掃描 PDF、文件截圖、投影片。這代表同一套主線 API 的射程不只純文字,視覺文件檢索的檢查點也在其中。
對 RAG 開發者的實際影響
對正在打造檢索或 RAG 系統的團隊,這次更新的意義可以分成三層。
第一層是選型自由度。檢索層從此可以在同一個函式庫裡按語料特性挑模型:短查詢對短文件、追求延遲與成本的場景,單向量模型依然划算;長文件、多主題、需要精準命中特定片段的場景,多向量模型提供了新的品質台階。兩者之間的切換成本,從「換一套函式庫」降到「換一個模型類型」。
第二層是訓練與微調路徑的統一。官方文件已列出適用於 MultiVectorEncoder 的損失函式,微調不必再繞經外部工具;對已經用 sentence-transformers 建立訓練管線的團隊來說,等於把既有投資直接延伸到多向量模型上。
第三層是遷移與分享。既有 PyLate 檢查點直接載入,不必重訓;檢查點回到 Hugging Face Hub 的主流分享路徑後,模型卡、範例與社群複用都站在同一個入口。由於 v6.0 是主版本號更新,升級前建議先讀官方的遷移指南,確認既有程式碼不受 API 變動影響。
代價、限制與後續觀察
多向量不是免費的午餐,最大的代價在儲存與索引。單向量模型每份文件存一個向量;多向量模型存的是「每個 token 一個向量」——一份 300 token 的文件就是 300 個向量,整個語料庫的向量總量可能放大兩個數量級,索引大小、記憶體用量與查詢延遲都會跟著上升。這也是為什麼向量檢索的基礎設施端持續往儲存層與索引層擠壓成本,例如〈小紅書 Helmsman 用全快閃伺服器重建向量檢索架構〉所展示的路線。
還有幾件事值得保守看待。其一,釋出說明並未附上「多向量全面勝過單向量」的基準數字——品質增益高度取決於語料與查詢型態,該在自己的資料上實測,而不是照單全收。其二,周邊生態需要時間跟上:向量資料庫與檢索引擎對多向量索引、MaxSim 查詢的支援程度不一,導入前得先確認自家技術棧接不接得起來。其三,v6.0 是主版本更新,這類更新常伴隨行為調整,正式升級前在測試環境跑一輪是最便宜的保險。
後續值得追蹤的訊號有三個:PyLate 會不會轉入維護模式或與主線並行發展;主流向量資料庫對多向量檢索的支援進度;以及 Hub 上相容 MultiVectorEncoder 的檢查點數量成長曲線。最後這項或許最誠實——當檢查點像單向量模型一樣遍地開花,晚期交互檢索才算真正走進主流。