Token 不是目的,工程框架才是
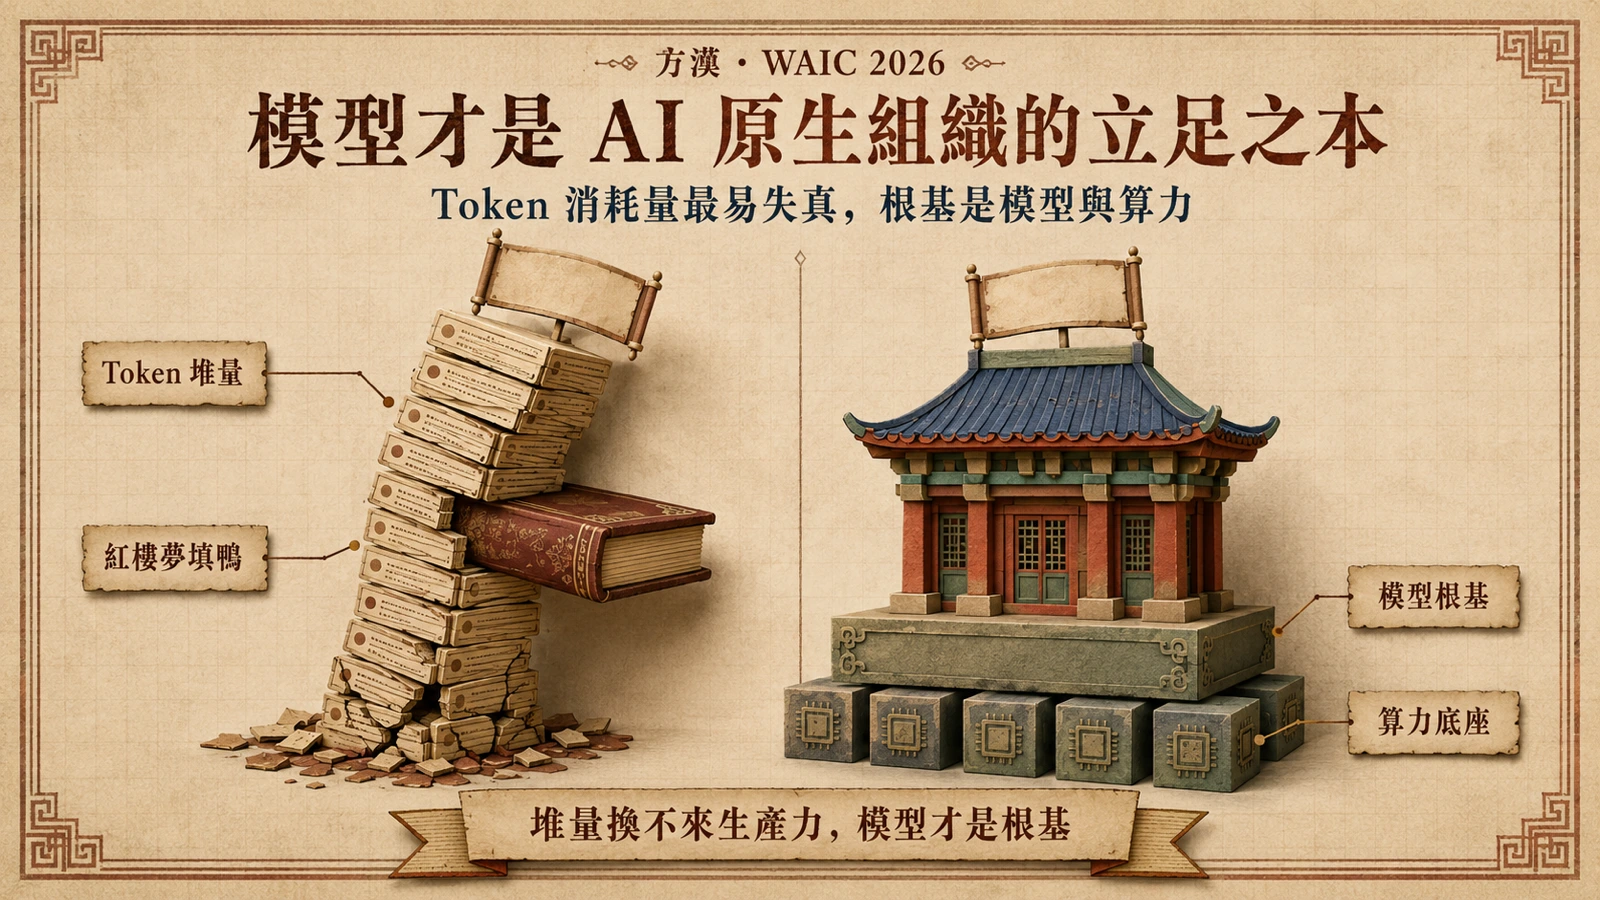
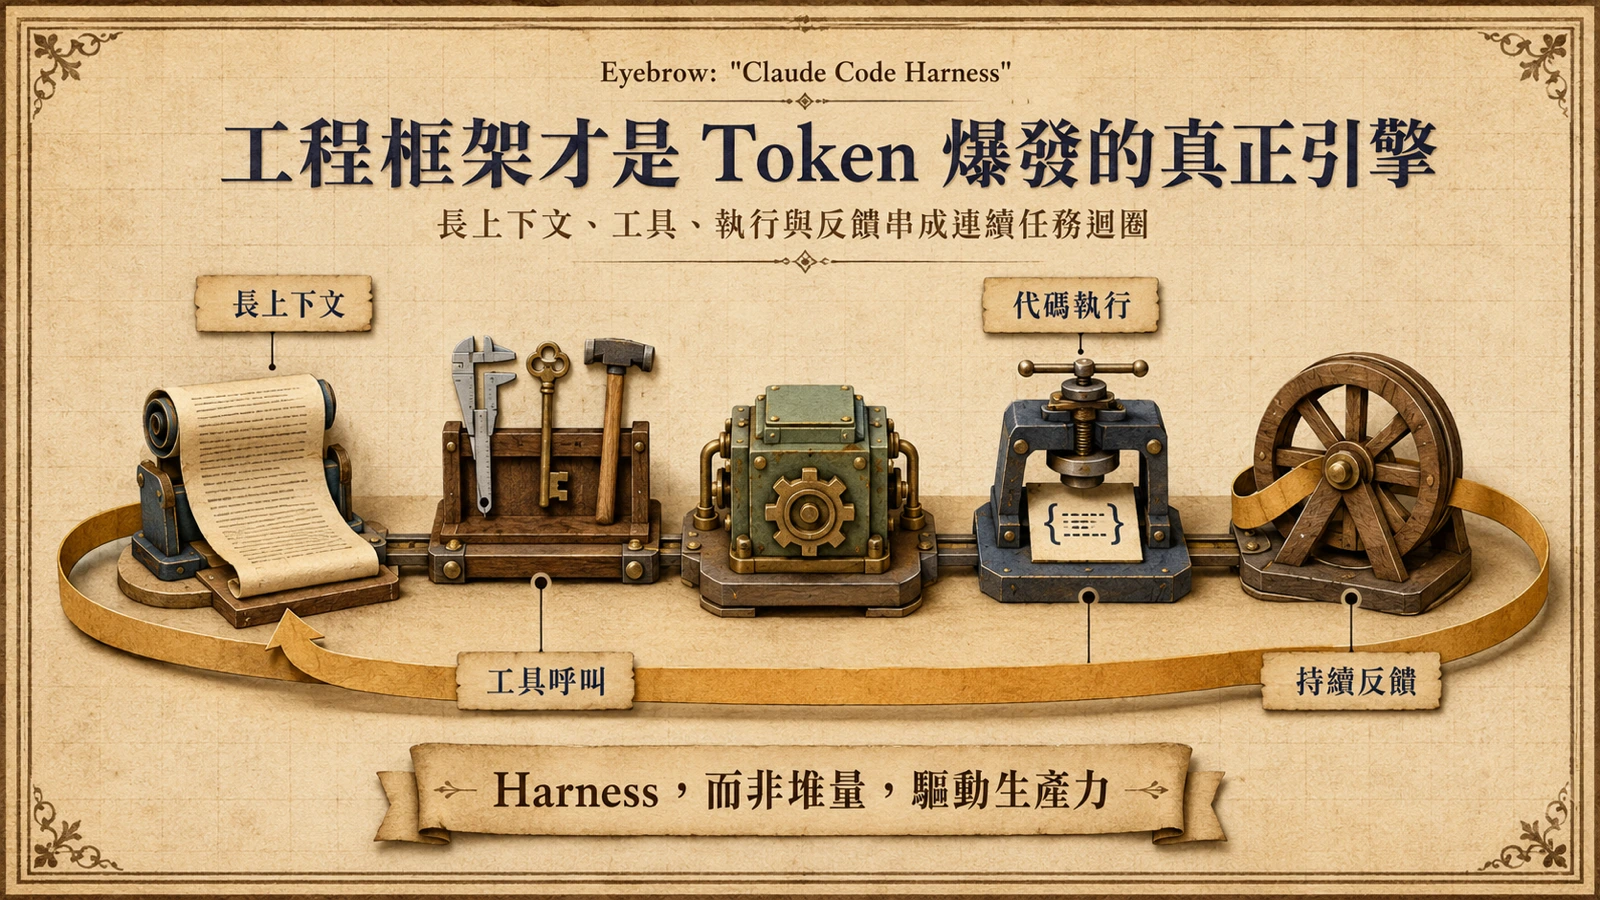
據《新浪財經》報導,昆侖萬維董事長兼 CEO 方漢在 2026 世界人工智能大會(WAIC)「騰訊 WAIC 之夜」圓桌上直言,Token 消耗量是最容易統計、也最容易失真的指標。他透露,公司內部曾追蹤員工 Token 使用,結果發現有人為了湊指標,把一整本《紅樓夢》餵進模型,瞬間燒掉大量額度。Token 能證明員工「用了 AI」,卻無法證明 AI 創造了多少價值。真正讓 Token 需求爆發的,是 Claude Code 等 Coding Agent 建立起的一套完整 Harness——長上下文、工具呼叫、代碼執行與持續反饋,讓模型得以連續完成複雜任務。本場圓桌討論另經中關村在線報導。
Coding 引爆 Token,但責任仍在人
方漢觀察,過去中國大量高端顯卡多用於圖像與視頻生成,用於編程的比例並不高;Claude Code 出現後,算力迅速轉向 Coding,也讓模型公司的訂閱收入與經常性收入明顯改善。但他同時警示,AI 編程會帶來嚴重的技術債,產能上升的同時代碼質量可能下降,因 AI 生成代碼導致的生產事故增幅可能達數倍。他因此強調:不手寫代碼不等於不審查,代碼審查、測試、權限、沙箱與責任機制必須同步強化,最終責任仍然在人。
組織轉型從考核中層開始
不同於與會其他嘉賓的路線,方漢選擇從中層切入。他親自設計 AI 編程題,現場考核中層研發管理者,結果 90 分以上的僅一人,相當一部分低於 60 分。他本人今年已消耗約 290 億 Token,主要用於撰寫簡報、研究文件與技術探索,目的是理解模型能做什麼,再與中層討論如何把合適的 AI 流程引入團隊。昆侖萬維的兩個實踐是:在工作群裡放入學習型 Agent,先當秘書記錄討論、整理組織記憶;以及讓每個開發組共享一套編程記憶系統,由負責人定知識結構,成員持續補充規範,系統每天自動清理過時內容。
世界模型與垂直深耕:為何不靠通用模型
方漢預告的三個模型——音樂、具身世界與遊戲世界——指向同一個判斷:在通用前沿模型尚未吃透的垂直域,自研模型仍有結構性價值。具身世界模型是機器人與實體智能的關鍵瓶頸,需要的是物理因果一致的模擬能力,而非純文字推理;遊戲世界模型則關係到環境與 NPC 的生成。這些領域的訓練資料、評測迴圈與通用語言模型差距甚大,通用模型若未針對性感測與控制資料訓練,難以直接勝任。
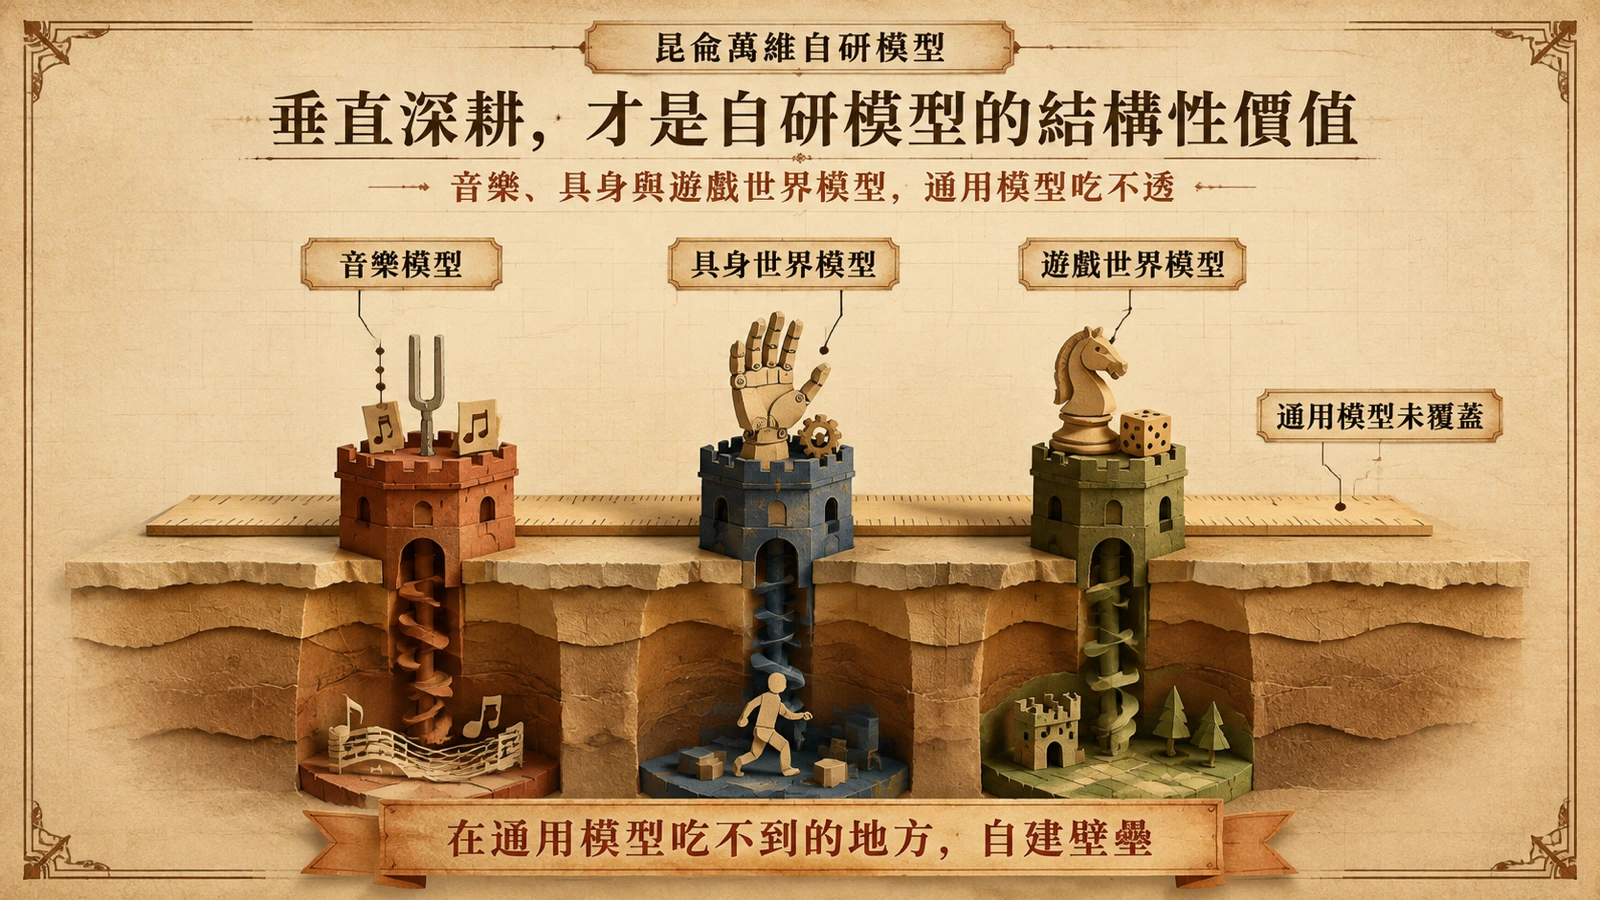
從這個角度看,「沒有自己的模型未來會非常吃力」並非全面主義,而是選擇性深耕:在通用模型已足以覆蓋的場景(如文字編程、摘要)仰賴外部能力,在物理、多模態與互動模擬等仍待突破的環節自建壁壘。方漢所稱「今日需要外部 Skills 完成的任務終將被原生能力吸收」也可由此理解——模型邊界會持續往外推,短期靠工程補位的 Skills,長期會被原生模型能力取代,這正是他堅持持續訓練的底層邏輯。
模型與算力仍是長期立足之本
被問及資源投向何處,方漢的答案與同場嘉賓不同——他選模型。他澄清外界誤解,強調昆侖萬維仍在持續訓練模型,並將發布音樂模型、具身世界模型與遊戲世界模型。他的判斷是:沒有自己的模型,公司未來會非常吃力;模型與算力仍然是一家 AI 公司長期立足的基礎。隨著模型能力增強,今日需要外部 Skills 完成的任務,終將被原生能力吸收。同期中國業界的模型推進如螞蟻 Ling-3.0-flash 以稀疏 MoE 壓低單次推論成本,正呼應「沒有自己的模型會非常吃力」的判斷。