從多模態模型到多模態智能體:Qwen-MM-Plugins 做什麼
一個看得懂圖片、聽得懂語音的多模態模型,並不等於一個能在實際工作流程裡讀圖、剪片、操作 3D 模型的智能體,見〈MineExplorer 基準實測〉。QwenLM 在 GitHub 釋出的 Qwen-MM-Plugins,補的就是這段從「模型」到「智能體」之間的落差。專案在 README 把自己定位得很明白——為 Qwen 模型打造的原生多模態插件,目標是「Make any agent harness multimodal-native」,讓任何智能體框架都具備多模態能力。
這表示它發布的不是另一個模型,而是一組能把多模態能力「裝」進既有開發框架的插件。從 Claude Code、Codex 到 Gemini CLI,開發者不必再把讀圖、語音轉錄、3D 操作等流程從頭串接,而是安裝對應插件,讓框架裡的智能體直接呼叫。對一個原本只會處理文字的智能體框架來說,這等同於一次性獲得看圖、聽聲音、讀文件的能力。
背後的模型脈絡也值得對照。Qwen 的視覺語言模型線一路推進,其技術報告將 Qwen3-VL 稱為「the most capable vision-language model in the Qwen series to date」,並把 agentic decision-making 列為應用願景。不過 Qwen-MM-Plugins 的 README 並未把任何單一模型指定為唯一底層,而是泛稱「for Qwen models」,並以「the VL model’s patch grid」描述其動態解析的讀取機制——換言之,這套插件鎖定的是 Qwen 多模態模型這條線,而非綁死某一個版本。
skill 加 MCP server:一套能力的兩個零件
Qwen-MM-Plugins 最關鍵的設計,是把「一項能力」拆成兩個分工明確的零件。據 README 說明,每項能力都分開安裝,由一個 skill(讓模型知道工具存在)加上一個選用的 MCP server(工具本身)組成;而這個 MCP server 是「launched on demand by uvx」,按需啟動、不必常駐。
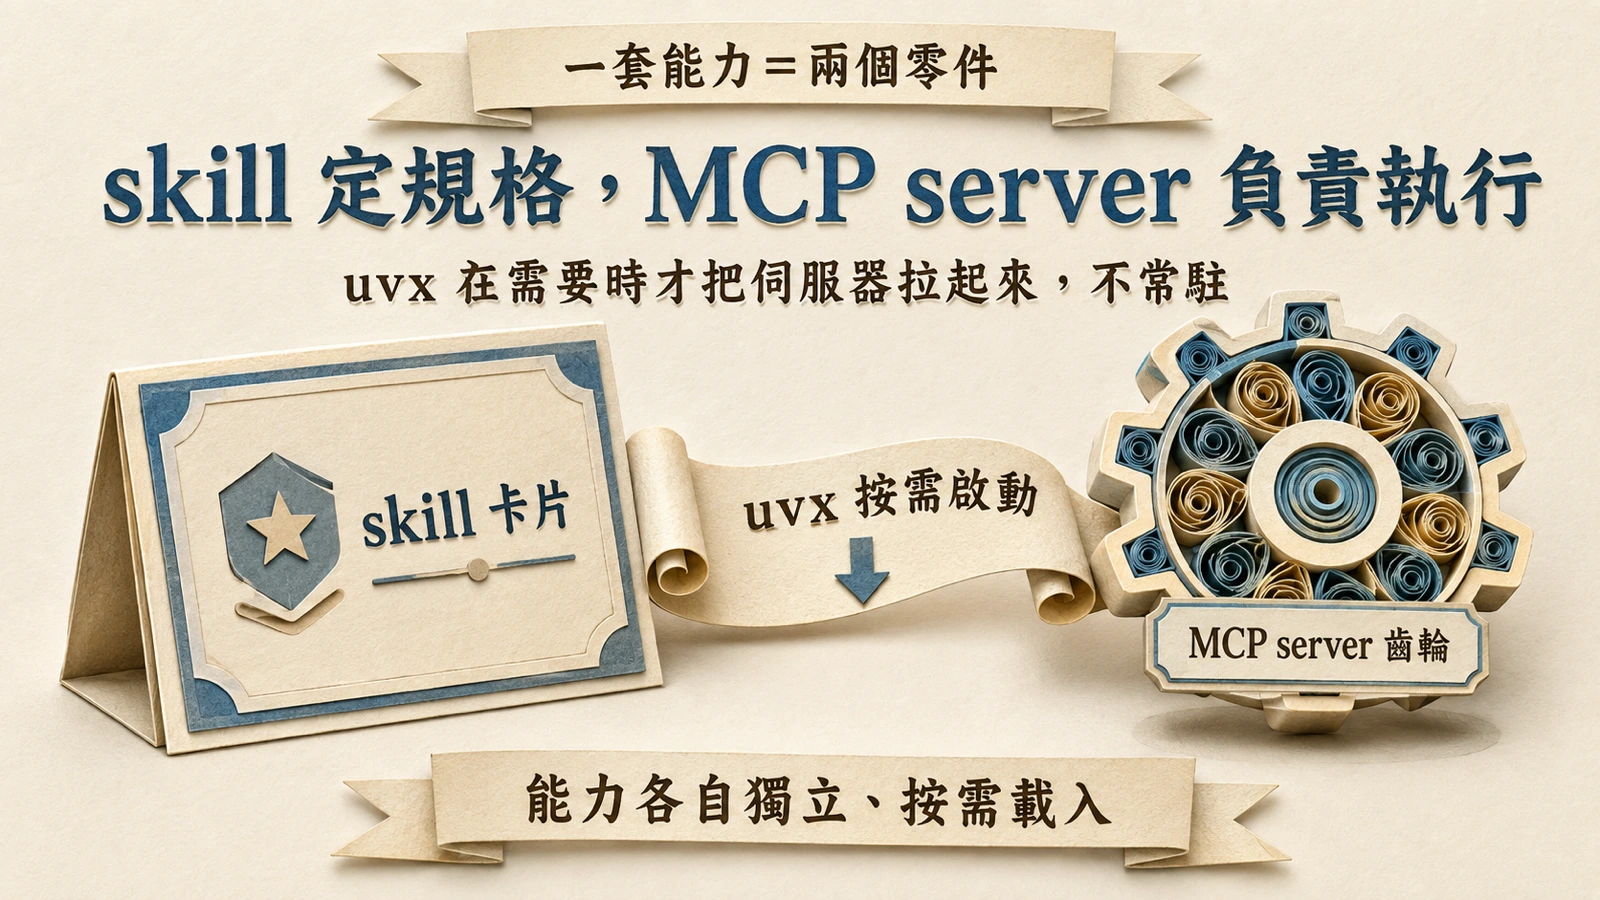
MCP(Model Context Protocol)是這套架構的共通語言。它讓模型能用標準化方式呼叫外部工具與資料來源,因此同一項多模態能力才可能跨框架通用:不管底層是 Claude Code 還是 Gemini CLI,只要框架支援 MCP,就能載入同一個插件。這也解釋了 Qwen 為什麼敢說要讓「任何」智能體框架變得多模態原生——多模態能力被封裝成可插拔的工具,而不是綁死在單一模型或單一產品裡。
讀圖、剪片、畫 3D、跑 CAD:六大能力拆解
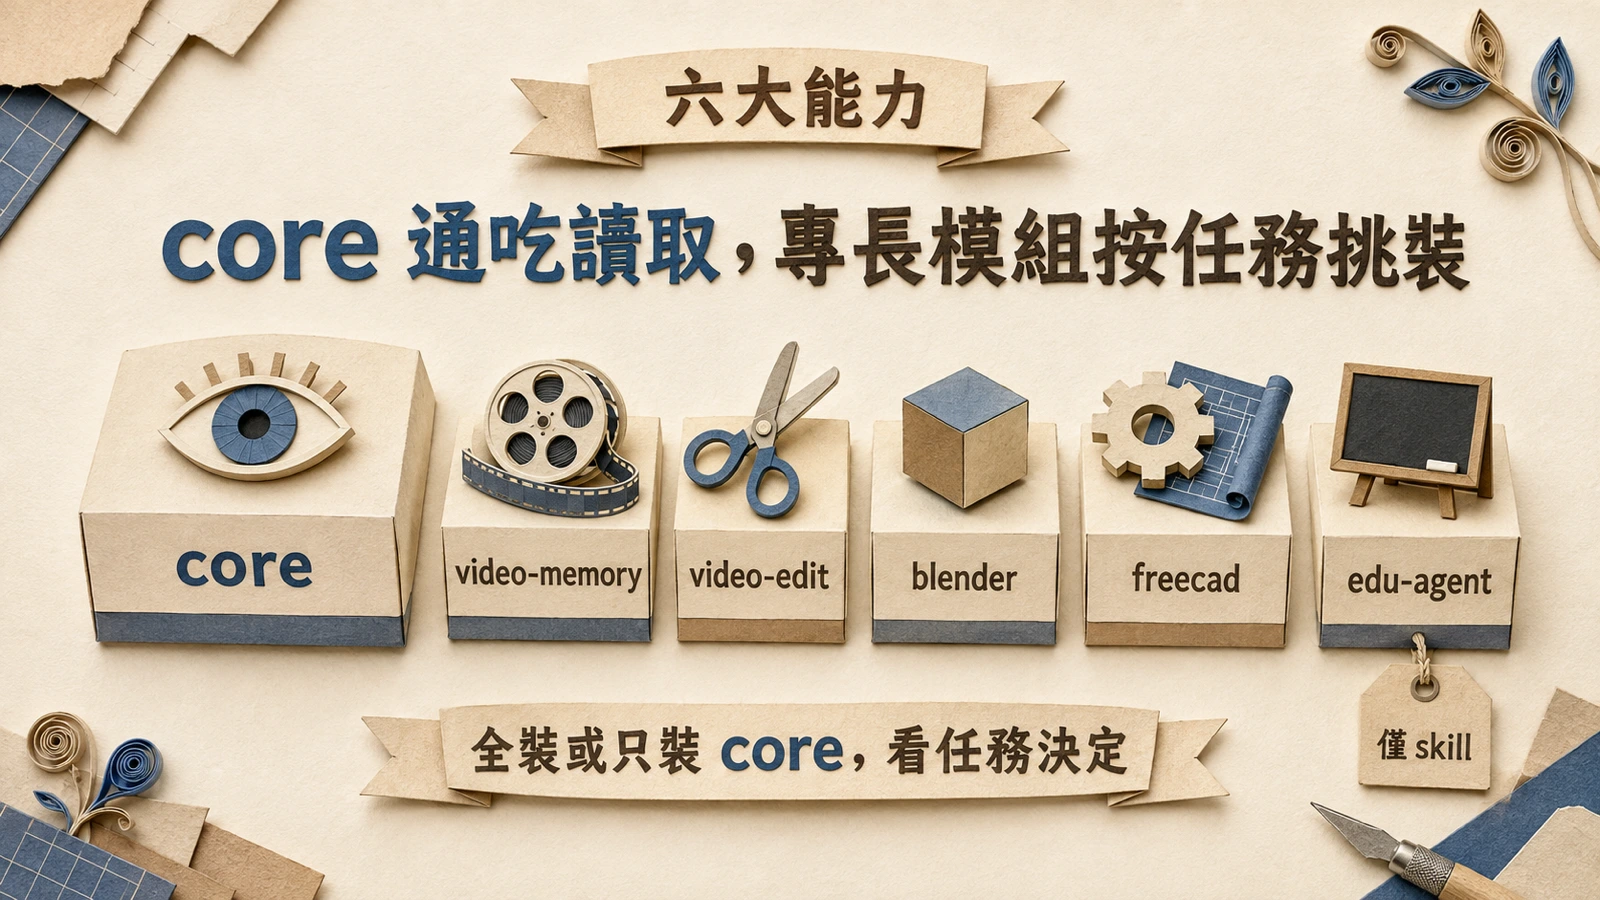
Qwen-MM-Plugins 目前提供六項能力,各自獨立安裝。核心的 core 涵蓋最常見的多模態讀取:圖片、影片、文件與 3D 模型的動態解析讀取,README 形容「every image, video frame, and document page is auto-scaled to the VL model’s patch grid」,再加上 OCR、grounding、分割、ASR 語音轉錄、vision chat 與網頁搜尋。也就是說,光是 core 這一項,就讓智能體同時具備看圖、讀文件、聽語音、查網路的能力。
在 core 之上,其餘能力往不同專業領域延伸:
- video-memory:針對長影片的問答與記憶,補強模型對長視訊的理解。
- video-edit:不只讀,還能剪輯,並生成圖像、影片與音訊。
- blender:以薄用戶端連接 Blender,提供 22 個 3D 建模工具。
- freecad:連接 FreeCAD 參數化 CAD,提供 14 個工具,支援 STEP/STL 匯入匯出與有限元素分析。
- edu-agent:製作教學用的講解影片,這一項只提供 skill、沒有 MCP server。
這份清單透露出 Qwen 的企圖:多模態不只是「看懂」,而是涵蓋到 3D 建模、參數化 CAD、影片剪輯與生成等需要實際動手的領域。README 的 cookbooks 並以一個它稱為 Qwen3.8-Max 的模型示範這些插件實際運作,不過專案本身並未把任何單一模型指定為唯一底層。
裝進 Claude Code、Codex、Gemini CLI:跨框架安裝
要讓這套插件真正「跨框架」,安裝體驗就得統一。README 指出一支腳本就能在它支援的每個框架上處理 install、configure、verify、uninstall,並列出 Claude Code、Codex、Qoder、OpenClaw、Qwen Code、Gemini CLI 等框架。對開發者而言,這代表不必為每個框架學一套不同的接入方式——同一支 install.sh 走完安裝、設定、驗證到解除安裝的完整流程。
不過「原生讀取」與「需要金鑰的服務」之間有一條清楚的界線。據 README,原生讀取圖片、影片、文件不需要任何 API key;但 OCR、grounding、語音轉錄、圖像與影音生成、長影片記憶等需要 DASHSCOPE_API_KEY,網頁搜尋與網頁擷取則需要 SERPER_API_KEY。此外像 Blender、FreeCAD 這類本地工具,使用者得自行安裝 ffmpeg、blender 等系統相依套件。換句話說,門檻不在框架相容性,而在於你要用到哪一層能力——純讀取幾乎零設定,要驅動生成或 3D/CAD,就得備齊對應金鑰與本機工具。
從能看見到能動手:多模態智能體的下一步
Qwen-MM-Plugins 的意義,在於它把「多模態」從模型的屬性,變成智能體框架可以即插即用的能力模組。過去要讓一個程式碼智能體讀懂截圖、讓寫作助理聽懂語音備忘,開發者往往得自己串接 OCR、ASR、視覺模型與一堆膠水程式碼;當這些能力被收攏成 skill 加 MCP server 的標準形式,並能用一支腳本裝進主流框架,多模態智能體的製作門檻就被顯著拉低。
值得觀察的反而是限制與代價。生成式能力與語音轉錄綁定 DashScope 金鑰,意味著最核心的「動手」環節仍落在 Qwen 自家的雲端服務上;而 Blender、FreeCAD 雖然走本地薄用戶端,卻要求使用者自備對應的系統環境。再加上專案以 Apache-2.0 釋出、卻在 Blender 與 FreeCAD 能力內含第三方 MIT 程式碼,商業部署時的授權組合也需要留意。Qwen 把多模態模型推進到「多模態智能體」這一步已經跨出,但能不能成為各家框架的共同標準,最終仍取決於 MCP 生態的成熟度,以及這套插件在真實工作流程裡的穩定度;至於能力如何接到付款與訂單,可對照千問開放平台的對話式服務架構。