發生了什麼:Copilot CLI 多了一個會自己挑模型的路由器
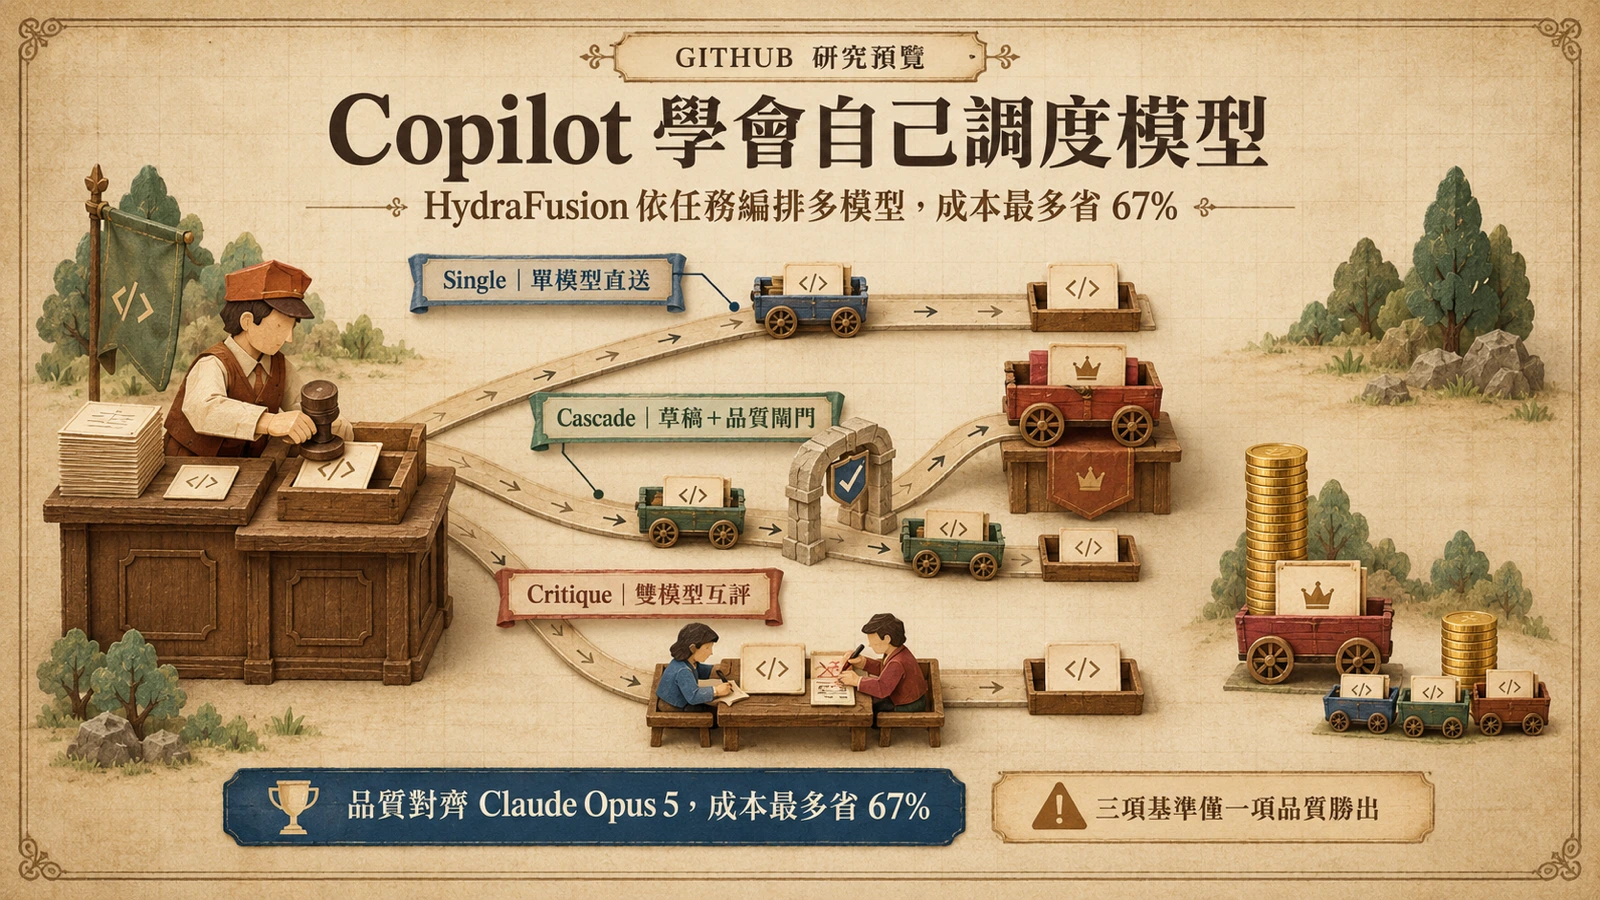
2026 年 9 月 4 日(美國時間),GitHub 在官方部落格發布 Project HydraFusion:一個在 GitHub Copilot CLI 中以研究預覽(research preview)形式上線的多模型編排層。GitHub 社群討論區的公告用一句話定位它——一個「透過執行期編排提供前緣智能」的研究預覽。名字的意象也直白:像九頭蛇一樣,一個身體、多個頭,各自咬住問題的不同部位。
對使用者來說,直接的差別是決策權的移轉。過去在 Copilot 裡,「選模型」是選單上的一次性決定:挑定了某個旗艦模型,整個工作階段都由它處理,無論任務是改一行錯字還是重構整個模組,都按同一套單價計費。HydraFusion 把這個決策上收到執行期:使用者只交代任務,系統在每次執行時判斷該用哪個模型、要不要組合、要不要事後審查。官方說明目前開放給所有 Copilot 方案的使用者,在 Copilot CLI 中以 /experimental 指令開啟,用量以消耗的 token 計算。
這不是 GitHub 第一次往多模型方向走——官方部落格同期也有讓 Copilot CLI 結合不同模型家族、互相提供第二意見的功能實驗。但 HydraFusion 把「多模型」從功能選項升級成執行架構本身,性質不一樣:它賭的是「調度」比「挑選」更能同時滿足品質與成本。
機制拆解:Single、Cascade、Critique 三種工作流
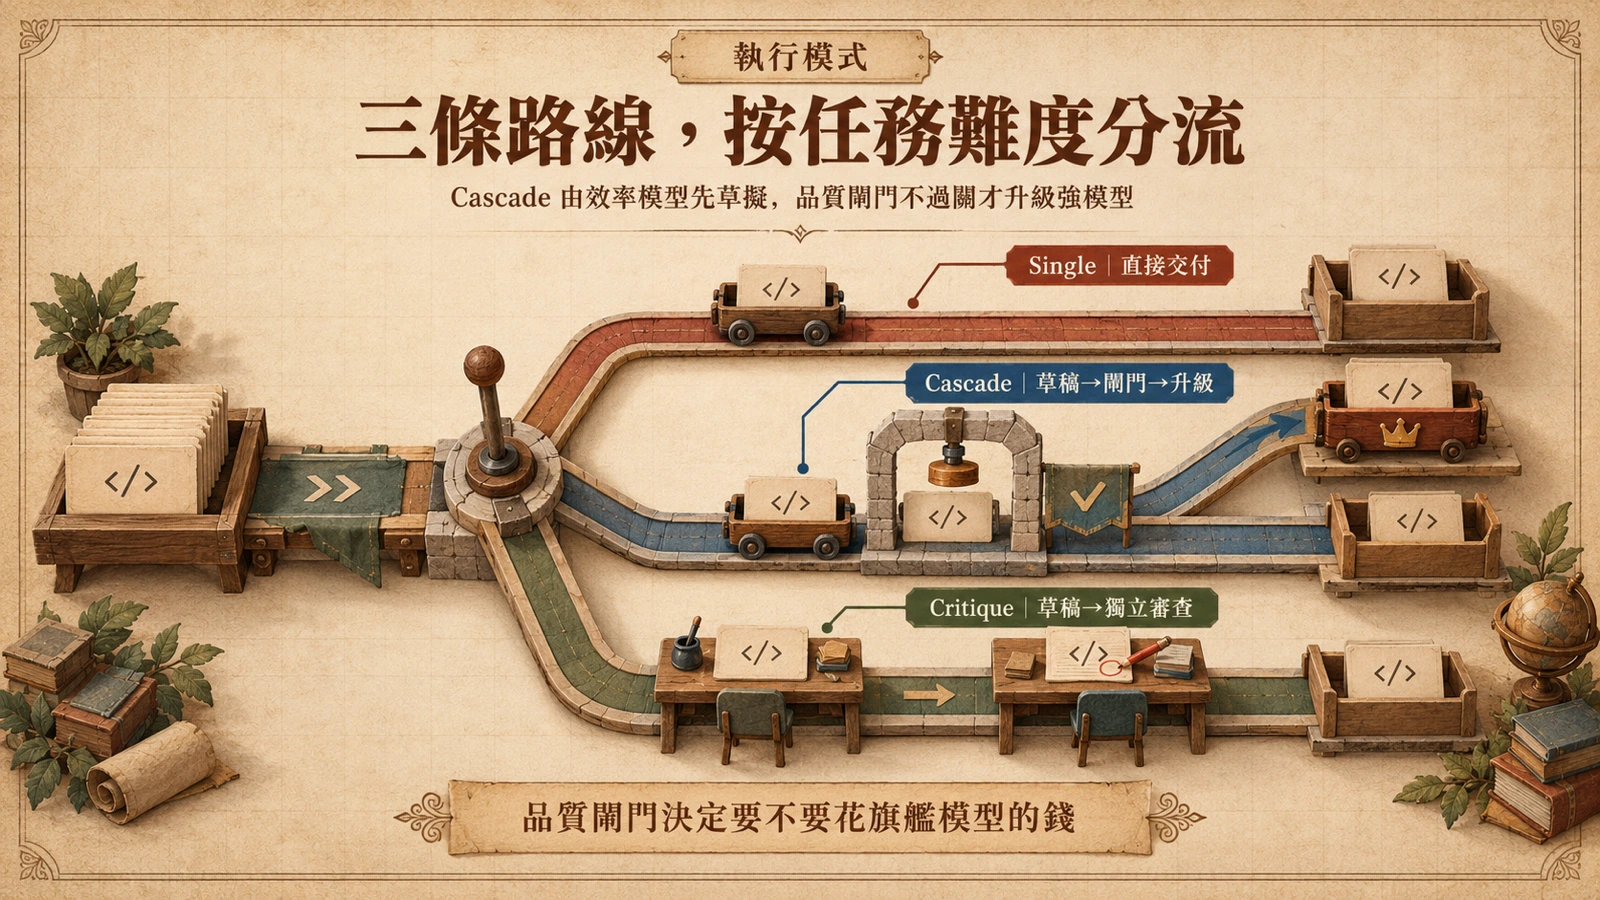
HydraFusion 的重點不是又一個新模型,而是三種執行模式的調度器。依官方說明,它為每個編碼任務建立工作流,在三種模式之間取捨。
第一種是 Single。任務夠單純、或已經知道哪個模型最擅長這類問題時,直接交給單一模型完成,不繞路。
第二種是 Cascade(級聯)。公告對它的定義是:效率模型先草擬解法,一道品質閘門決定要接受它、還是把任務升級給更強的模型。這是成本控制的關鍵設計:大多數日常編碼任務的難度,其實用不到旗艦模型的智力;讓便宜模型先試、閘門把關,只有真的過不了才花大錢。整體成本因此向「任務實際需要的模型」靠攏,而不是向「你選定的模型」靠攏。
第三種是 Critique(互評)。一個模型產起草稿,另一個模型獨立審查並修改。這對應「產出要可靠」的場景:草稿模型拚速度,審查模型把關正確性,兩道視角疊加,降低單一模型自我盲點造成的錯誤。
三種模式共用同一個前提:模型的強弱是「每個任務」的屬性,不是「每個工作階段」的屬性。這也是這類執行期編排與一般模型路由服務的微妙差異——常見的路由是在請求進來時做一次性分類,而 HydraFusion 的工作流可以在任務執行中動態展開:草稿、閘門、升級、審查,每一步都是執行中的決策,不是事前的猜測。
官方成績單:TerminalBench 2.1 勝出,成本全面下降
GitHub 在公告中給出的主要對照組是 Claude Opus 5。最亮眼的數字是:在 TerminalBench 2.1 上,HydraFusion 的驗證任務品質比 Claude Opus 5 高出 4.9 個百分點,估計成本低 67%。TerminalBench 2.1 是以終端機環境中代理任務為主的基準;所謂 verified task quality(驗證任務品質),強調的是分數只計經驗證確認的任務成果,而非模型自行宣告的完成。
但整份成績單要完整讀。GitHub 同場測了三項代理編碼基準,VentureBeat 檢視同一批數據後的結論是:成本在每項基準都下降,品質卻只在三項中的一項站得住。換句話說,「成本最多省 67%」全面成立,「更強」只在 TerminalBench 2.1 一項成立,另外兩項是持平到小幅落後。
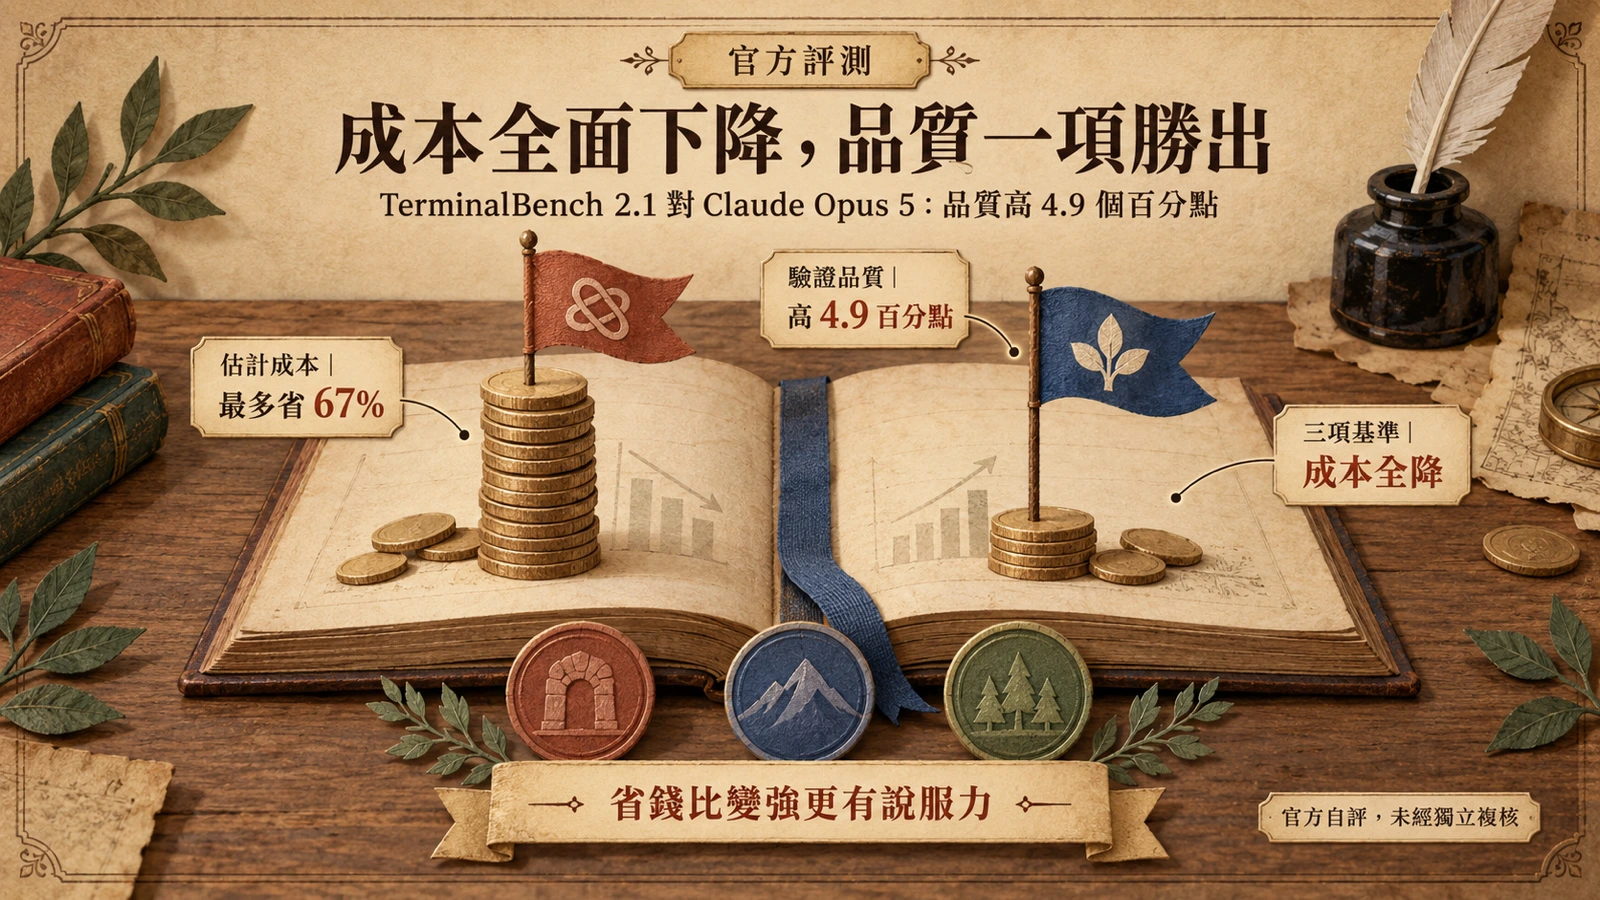
這個結果結構其實比單一數字誠實。編排層的價值本來就不是「打敗最強模型」,而是「用低得多的成本拿到接近最強模型的品質」:如果你的基準線本來就是 Claude Opus 5,那麼品質大致持平、成本明顯下降,在採購上已經是很有意義的改變。至於 Opus 5 與 GPT-5.6 Sol 兩款前緣模型各自的路數與價格,我們先前在模型比較專文整理過。
為什麼此刻出現:從選模型到編排模型
HydraFusion 出現的時機,有三層背景可以拆。
第一層是經濟模型。Copilot 的用量以 token 計算,這代表 GitHub 自己就站在成本槓桿上:代理式編碼讓每個任務消耗的 token 遠高於過去的補全場景,若每個任務都由最貴的旗艦模型處理,成本結構會被快速推高。編排層讓「大部分任務用便宜模型」成為系統預設,而不是要求使用者自己節制。
第二層是模型供給。Copilot 旗下可呼叫的模型家族持續增加,Microsoft 自家 MAI 系列也已進駐 Copilot 與 Excel 等場景——我們先前報導過 MAI 模型以更少 token 追平 GPT-5.6 的成績。當可調度的模型變多,靜態的選單注定失效,動態編排是自然的下一步。
第三層是產業方向。「選模型」的痛點人人都有:挑太強的浪費錢,挑太弱的做不好。模型路由、請求分類、快取重複請求,整個生態都在把模型的消費從手工挑選推向系統調度。GitHub 的特殊位置在於它同時握有代理框架與計費體系,能把編排做進產品的執行路徑裡,而不是留給使用者自己拼裝。
對開發者與企業採購的實際影響
對個人開發者,門檻很低:所有 Copilot 方案都能用,把 Copilot CLI 更新到最新版後以 /experimental 開啟即可試用。由於是研究預覽,行為與計費細節仍可能調整,適合先在非正式專案上觀察它對實際用量的影響,再決定要不要放進日常流程。
對團隊與企業,HydraFusion 回答的是採購上最難的對帳問題:AI 編碼預算與產出的關係。過去要控制成本,得自己架路由層、寫分類規則,或硬性規定只能用某個模型;現在品質閘門與升級邏輯由平台提供,團隊可以退回到監看用量與驗收成果。對以美元計價訂閱 Copilot 的台灣團隊,功能隨全球版同步開放,真正要管理的是用量面板上的 token 消耗。
還有一個容易被忽略的影響:模型選用的抽象化。當編排層決定用哪個模型,團隊對「底層是誰」的依賴下降——模型供應商的版本更迭與價格調整,大多被編排層吸收。對要把 AI 編碼納入正式流程、需要穩定成本結構的組織來說,這是降風險,多於炫技。
分數之外的三個但書:自評、延遲與可預測性
第一個但書是自評。三項基準的評測由 GitHub 自己執行,對照組、任務集與成本估計方式都由發布方選定,尚未有獨立第三方複核。4.9 個百分點與 67% 是「官方數據」該有的份量,不是定論。
第二個但書是品質的完整解讀。如前述,三項基準中只有一項品質勝出。實際的讀法應該是:編排層在多數場景用便宜模型換來逼近旗艦的品質,它是成本優化,不是能力升級;若你的任務剛好落在必須升級的難度帶,節省會縮水,延遲還會增加。
第三個但書是延遲與可預測性。Cascade 的閘門與 Critique 的審查都是額外的執行步驟:每一次升級是一次重新往返,每一次審查是多一輪模型呼叫。token 成本下降的同時,牆上時鐘的時間可能變長,而且同類任務的完成時間會因為路由結果不同而更難預測。對把代理掛進 CI/CD 的團隊,這是比單價更實際的變數。
後續觀察指標
三個訊號值得追。其一,HydraFusion 何時從研究預覽轉為正式功能、是否從 CLI 擴及 Copilot 的其他入口——這反映 GitHub 對編排層的信心程度。其二,獨立評測或社群複現,能否驗證 67% 的成本降幅在真實工作負載上成立。其三,競品反應:如果更多 AI 編碼工具跟進執行期編排,多模型調度就會從一家公司的實驗,變成整個品類的標準配備。
在那之前,合理的態度是把 HydraFusion 當成一個可以低成本試用的方向驗證。它對「模型該怎麼被消費」給出的答案——不是更大的模型,而是更聰明的調度——比任何單一基準分數都更值得記住。