一個網路同時聽與說
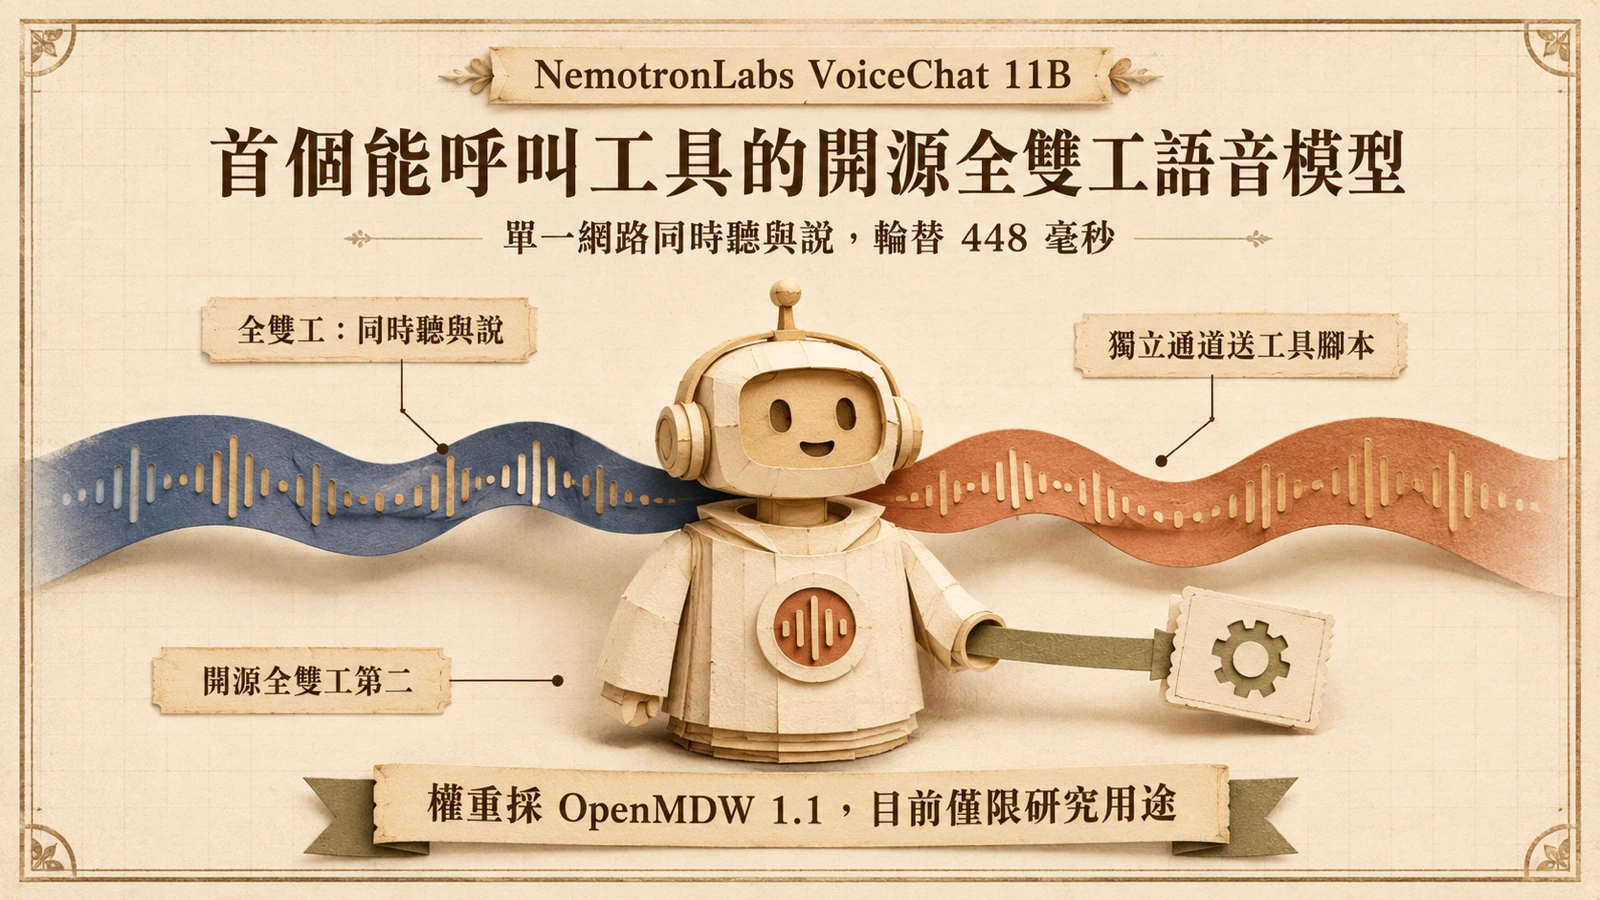
NVIDIA 在 8 月 3 日於 HuggingFace 釋出 NemotronLabs VoiceChat 11B 的開源權重,把即時語音對話收進單一神經網路。官方模型卡定位它為「11B 端到端、即時語音全雙工模型,在同一網路中聯合執行串流語音理解與語音生成」。
關鍵詞是「全雙工」(full duplex)。傳統語音助手是一條串接管線:先由 ASR 把語音轉成文字、再交給 LLM 生成回覆、最後用 TTS 合成語音,使用者與機器輪流獨白,像在用對講機。NGC 目錄頁對 VoiceChat 的說明指出,它「不同於傳統的串接式堆疊(ASR → LLM → TTS),在單一架構內達成全雙工、即時、無縫的語音互動」。也就是說,模型可以同時聽與說、被中途打斷、與使用者的語音重疊,貼近真人對話的節奏,而不是單向收發。
把理解、推理與合成壓進同一網路,代價是工程複雜度與算力需求同步上升,這也是後續「為什麼需要資料中心級 GPU」的伏筆。但好處是少了管線之間的逐站緩衝,輪替延遲才有可能壓到次秒級。
邊對話邊呼叫工具
真正讓這次發布與眾不同的,是工具呼叫(tool calling)。模型卡明載:「NemotronLabs VoiceChat 是首個支援工具呼叫的開源全雙工模型,並能在工具執行期間維持自然的對話流程。」
關鍵在它如何避免冷場。模型卡說明,VoiceChat 用一條獨立的輸出通道來預測工具呼叫腳本,並「可以為每個工具定義一段特定的『保留』訊息;當 LLM 生成會觸發工具呼叫的文字時,代理就會立刻說出這段話」。換言之,在後端 API 還在執行查詢、下單或檢索的那幾秒,代理不會陷入沉默,而是先說出預設的墊檔話術把對話接住,等結果回來再繼續。
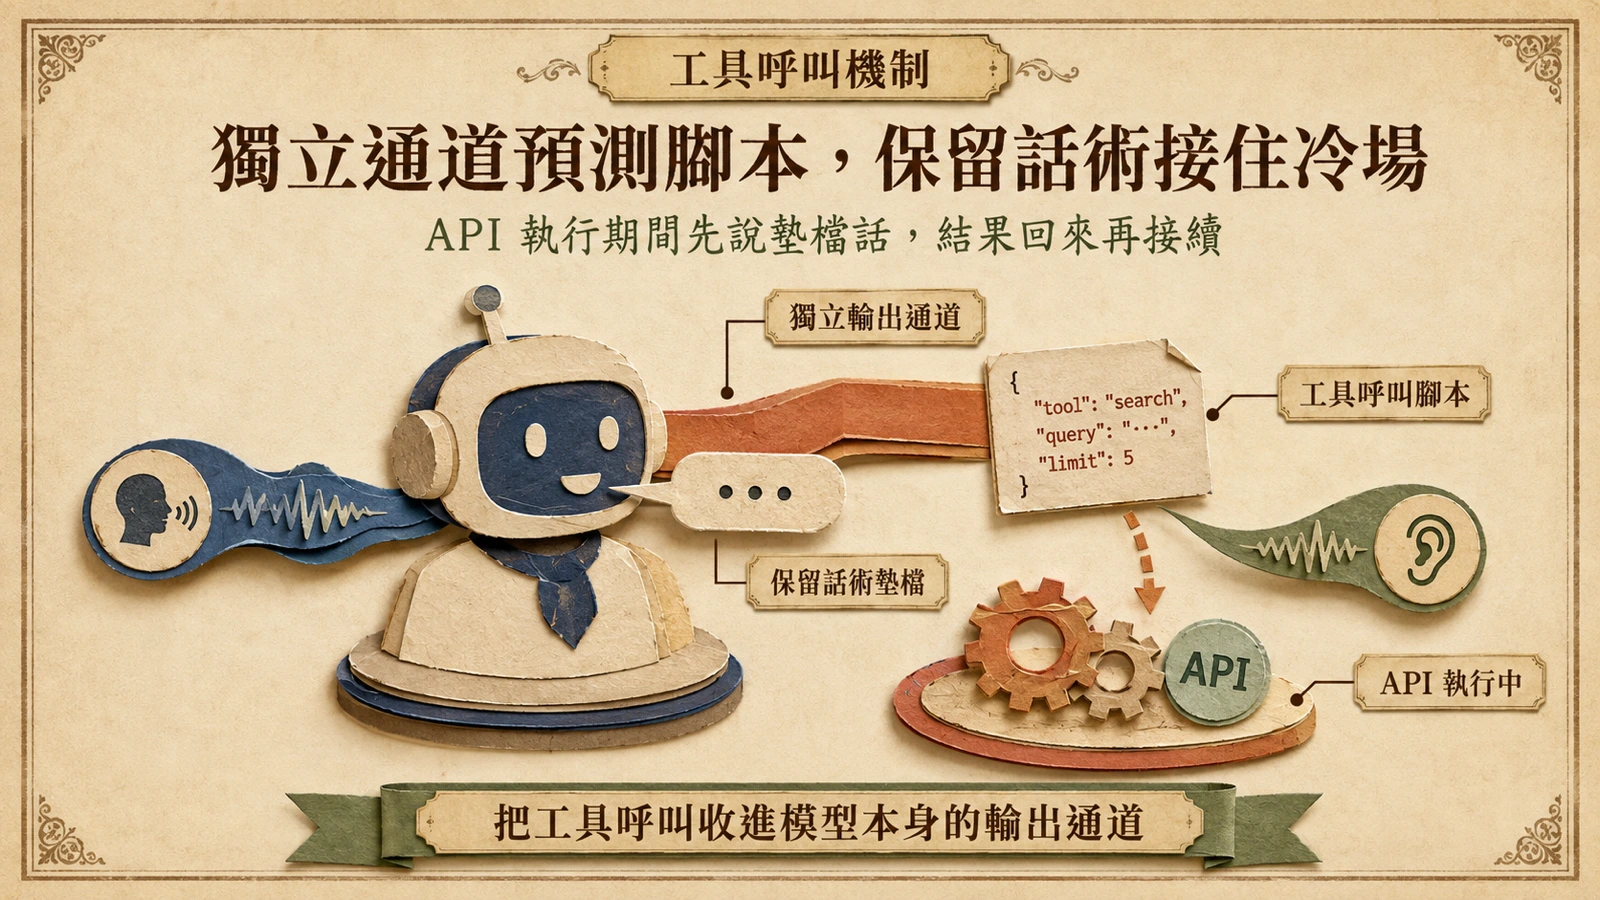
這是讓語音代理從「能聊天」走向「能辦事」的工程前提。過去要讓語音助手在對話中查資料、查訂單、觸發動作,多半得在外層手動接駁 ASR 與函式呼叫,中間的靜音與等待很難處理得自然;把工具呼叫收進全雙工模型的輸出通道,等於把這層膠水內化進模型本身,商用對照見〈Claude 語音模式〉。
448 毫秒輪替,開源全雙工第二
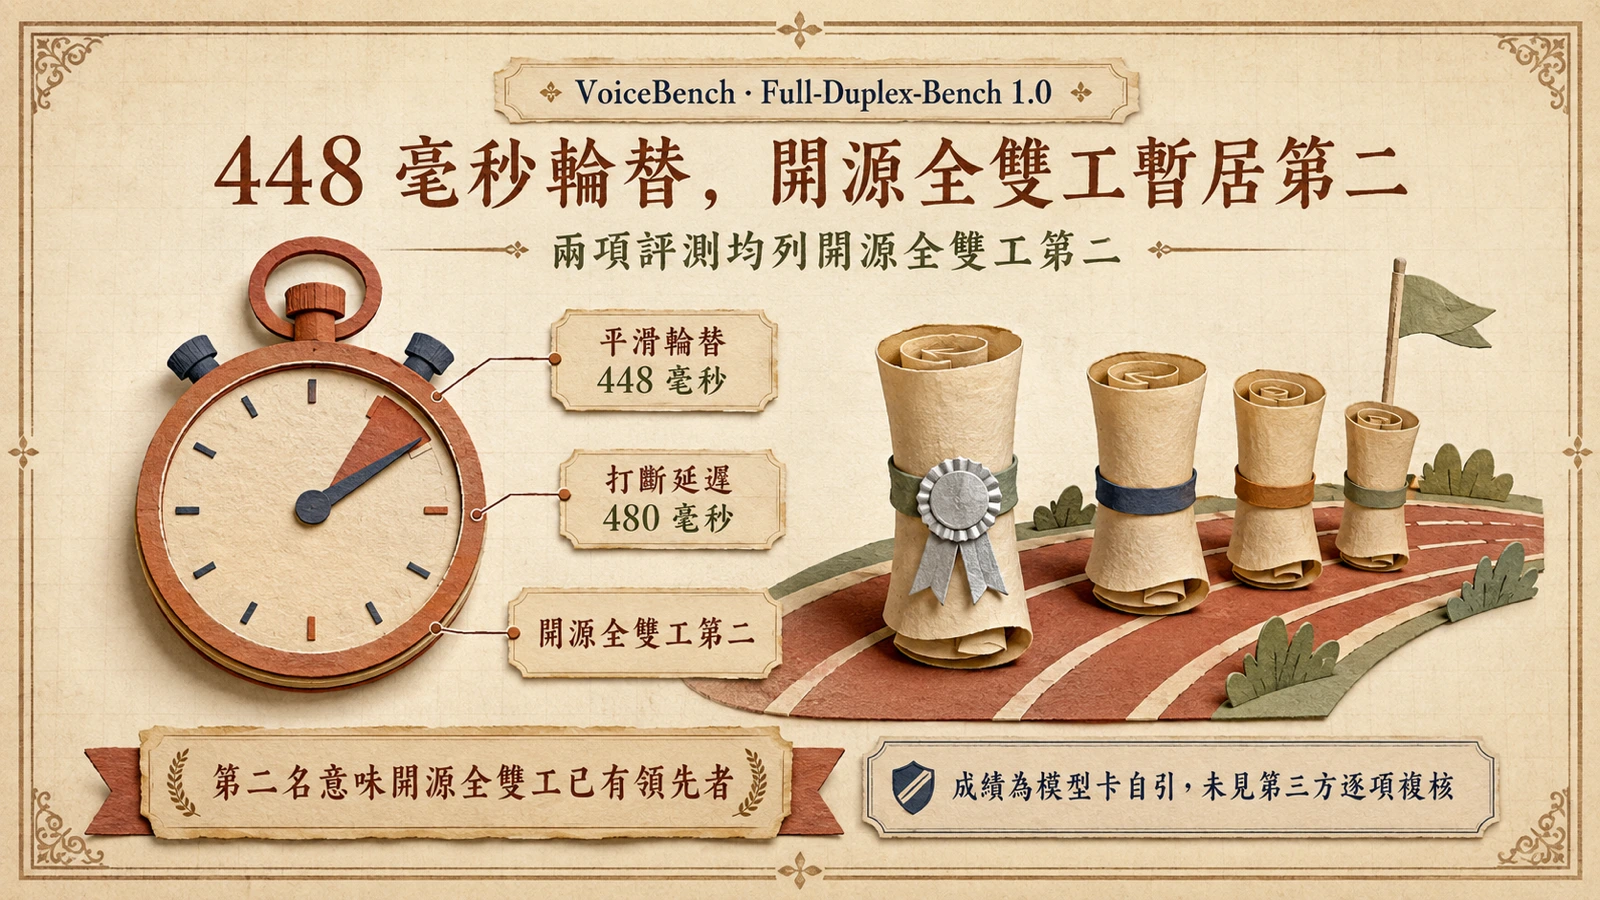
速度上,模型卡列出平滑輪替延遲 448 毫秒、使用者打斷延遲 480 毫秒(摘要另以約 450 毫秒概稱輪替延遲)。對語音代理而言,輪替延遲決定對話是否「卡」——人類自然對話的回合切換落在數百毫秒,448 毫秒落在可接受的即時區間,但與頂尖商用系統追求的更低延遲仍有差距。
在開源陣營裡,它的位置相當靠前。模型卡指出,VoiceChat 在 VoiceBench 與 Full-Duplex-Bench 1.0 兩個評測都「名列所有開源全雙工模型第二」。需留意兩點:這兩項成績由模型卡自行引用,未見獨立第三方逐項複核;而「第二」也意味著開源全雙工賽道已經有人領先。
另一個容易混淆的地方:這裡衡量的是「即時對話」的全雙工能力,與單向語音合成的品質排行是不同軸。若關注的是合成音質與擬真度,可參考 Qwen-Audio-3.0-TTS 在 Speech Arena 盲測的排行,那是另一套評估標準。
開源但僅限研究
取得方式上,權重以 OpenMDW 1.1 授權釋出,但模型卡聲明「本模型僅就緒供研究用途使用」。NGC 目錄另提供可部署容器(容器適用 NVIDIA 的軟體與模型評估授權),讓團隊自行拉取、託管。
門檻在硬體。模型卡列出的支援 GPU 包括 A100、H100、H200、B100、B200 與 RTX-6000,皆屬資料中心與高階工作站級距,不靠一張高階顯卡跑不動。目前 NVIDIA 並未提供公開的託管推論 API,僅對合格開發者開放早期體驗計畫;想實際跑通,基本等於自備 GPU、自己拉容器部署。對研究與原型開發者,這是少數能在本地端實作「全雙工加工具呼叫」語音代理的開源選項;對想直接上線產品者,現階段仍得等待託管服務,或自行承擔部署與授權成本。