Iris 是什麼:兩個開放權重搜尋代理
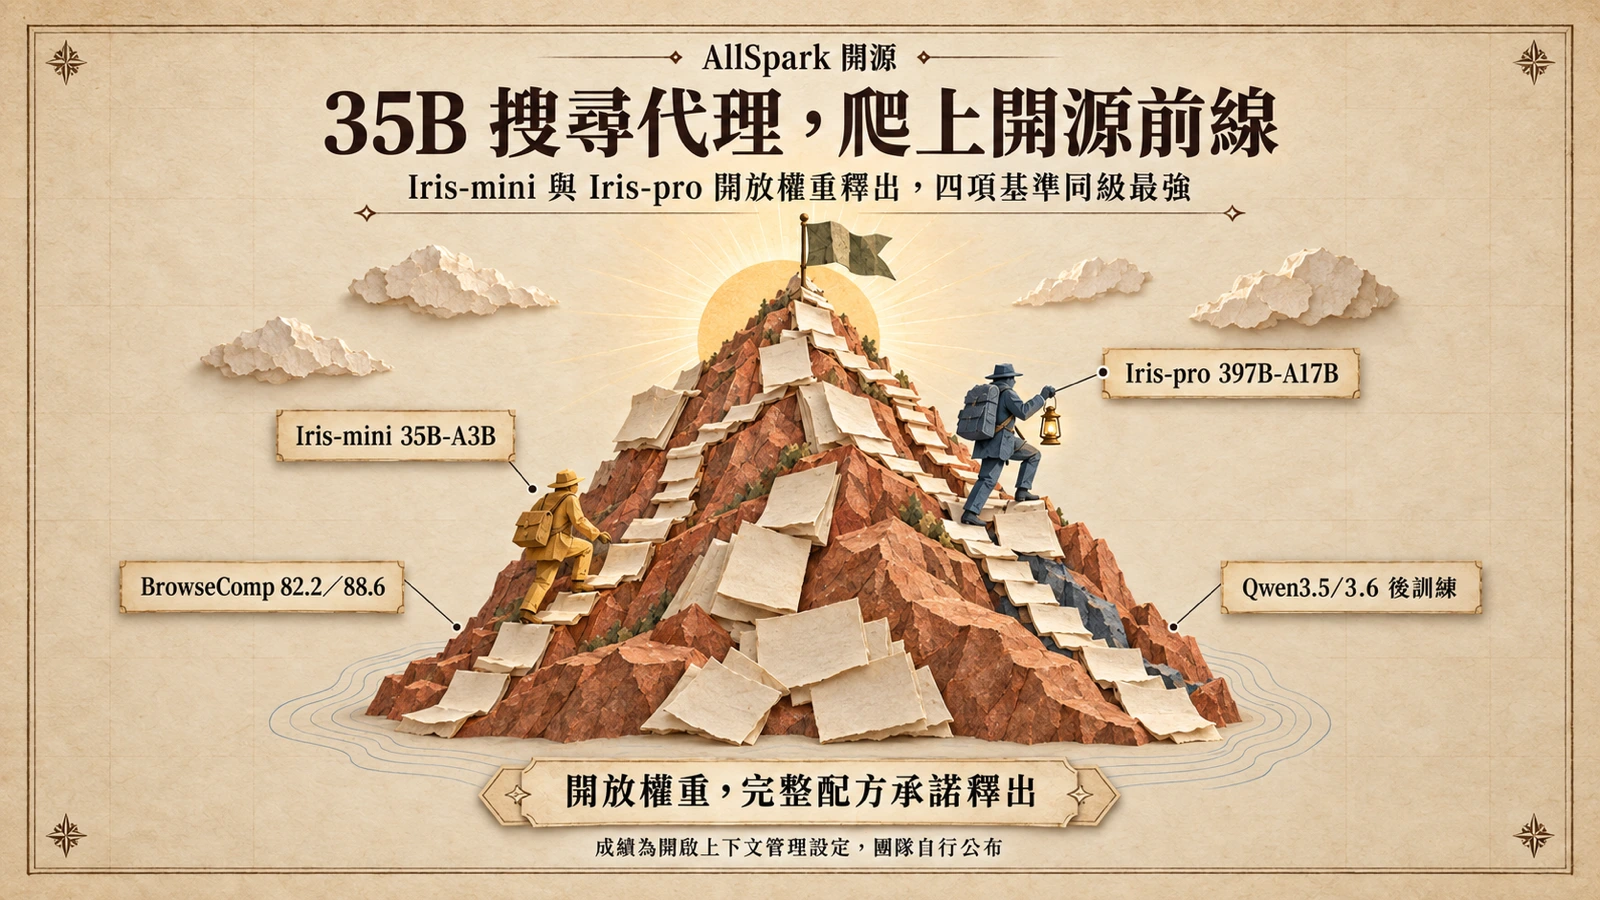
AllSpark 團隊發表論文《Iris: Climbing to the Search Frontier》,並同步開源兩個搜尋代理模型:Iris-mini 與 Iris-pro。GitHub 儲存庫的說明開宗明義:兩者是以 Qwen3.5/3.6 系列後訓練的開放權重搜尋代理,規模分別為 35B-A3B 與 397B-A17B。A3B、A17B 指的是混合專家(MoE)架構下每個 token 實際激活的參數量——Iris-mini 總參數 350 億、每次推理激活約 30 億;Iris-pro 總參數 3,970 億、激活約 170 億。
搜尋代理與一般聊天模型的差別,在於查證流程要由模型自己走完:決定搜尋什麼、怎麼解讀搜回來的內容、證據不夠時要不要繼續往下挖、什麼時候才算足夠回答。這四個判斷正是 Iris 訓練的主角,也是它有別於「模型加上檢索外掛」的根本——策略被訓進權重裡,而不是每次推理時臨時拼裝。
arXiv 論文頁顯示論文於 9 月上旬掛網(編號 2609.04304);Hugging Face 論文頁記錄它在 9 月 3 日出版、曾列 Paper of the day 第三名、至查證時累積 68 個 upvote,作者共九人,以 AllSpark Research 名義發表。
成績單:四項基準、同級開源的具體數字
數字先看清楚。依論文摘要,在開啟推論時上下文管理的設定下,兩個模型在四項基準的成績為:
| 基準 | Iris-mini(35B-A3B) | Iris-pro(397B-A17B) |
|---|---|---|
| BrowseComp | 82.2 | 88.6 |
| BrowseComp-ZH | 84.8 | 85.1 |
| DeepSearchQA | 86.9 | 92.9 |
| HLE | 52.3 | 56.4 |
論文的原話是,這是各參數區間開源搜尋代理中最強的整體結果。四項基準的定位不同:BrowseComp 與其中文版 BrowseComp-ZH 測的是需要多步瀏覽、跨頁拼湊才能解出的深度檢索題;DeepSearchQA 針對深度搜尋問答;HLE(Humanity’s Last Exam)以跨學科高難度題目著稱,兩個模型在它上面的分數明顯低於另外三項,成績裡內建的難度梯度一目了然。
「多跳」值得展開一下,因為它正是這類基準與一般問答的分水嶺:答案不存在於任何單一頁面上,問題可能要求先找到某個實體,再順著它找到第二個實體的關聯事實,中間每一步都依賴上一步的搜尋結果。這種任務型態同時讓兩種投機解法失效——字面匹配找不到答案,單次檢索取回的區塊也拼不出答案。
值得注意的是差距的結構:在 BrowseComp 上 pro 領先 mini 6.4 分,但在 BrowseComp-ZH 上只差 0.3 分——中文深度檢索任務上,35B 版幾乎追平 397B 版。對硬體預算有限的團隊,這個數字比旗艦版的 88.6 更有現實意義。
資料從超連結反推:讓字面匹配徹底失效
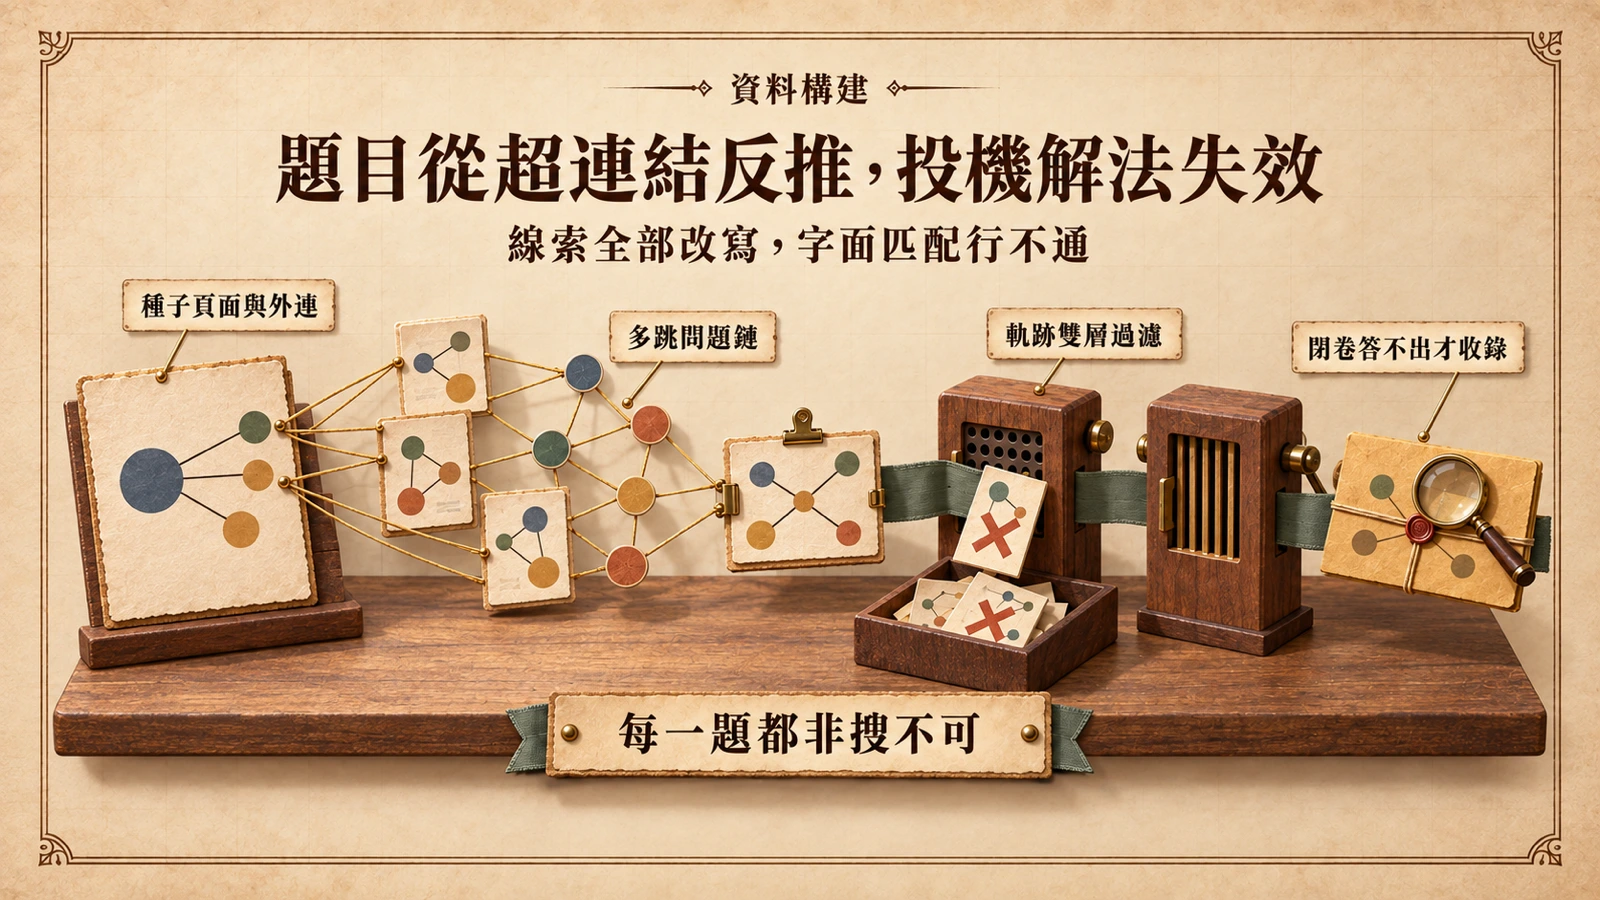
Iris 的第一個賣點不是模型,是出題方法。訓練任務不是人工手寫,而是從網頁語料的超連結結構反推:先取一個種子頁面,把它與外連頁面蒸餾成一張實體圖,再在圖上鋪設多跳問題鏈。接著是最關鍵的一步——把題目裡所有非答案的實體,全部改寫成描述性的指涉,確保沒有任何線索能靠字面匹配解開。白話地說,題目不直接寫出可搜尋的專名,而以一段描述代替,模型必須先弄清楚描述指的是誰,才談得上往下找。換句話說,模型無法從題目文字裡抄到答案的影子,必須真的發動搜尋。
收題還有一道難度閘門:只有「參考模型閉卷答不出、但給了支持證據後就答得出」的題目才被採用。這個雙重條件同時排除兩種壞題——太簡單的(閉卷就會,訓不出搜尋行為)與太刁鑽的(給了證據也不會,獎勵訊號沒有意義)。通過的題目接著被轉成完整軌跡,在軌跡層與輪次層雙重過濾後,才進入監督微調。
訓練機制:SFT-RL climbing 怎麼爬
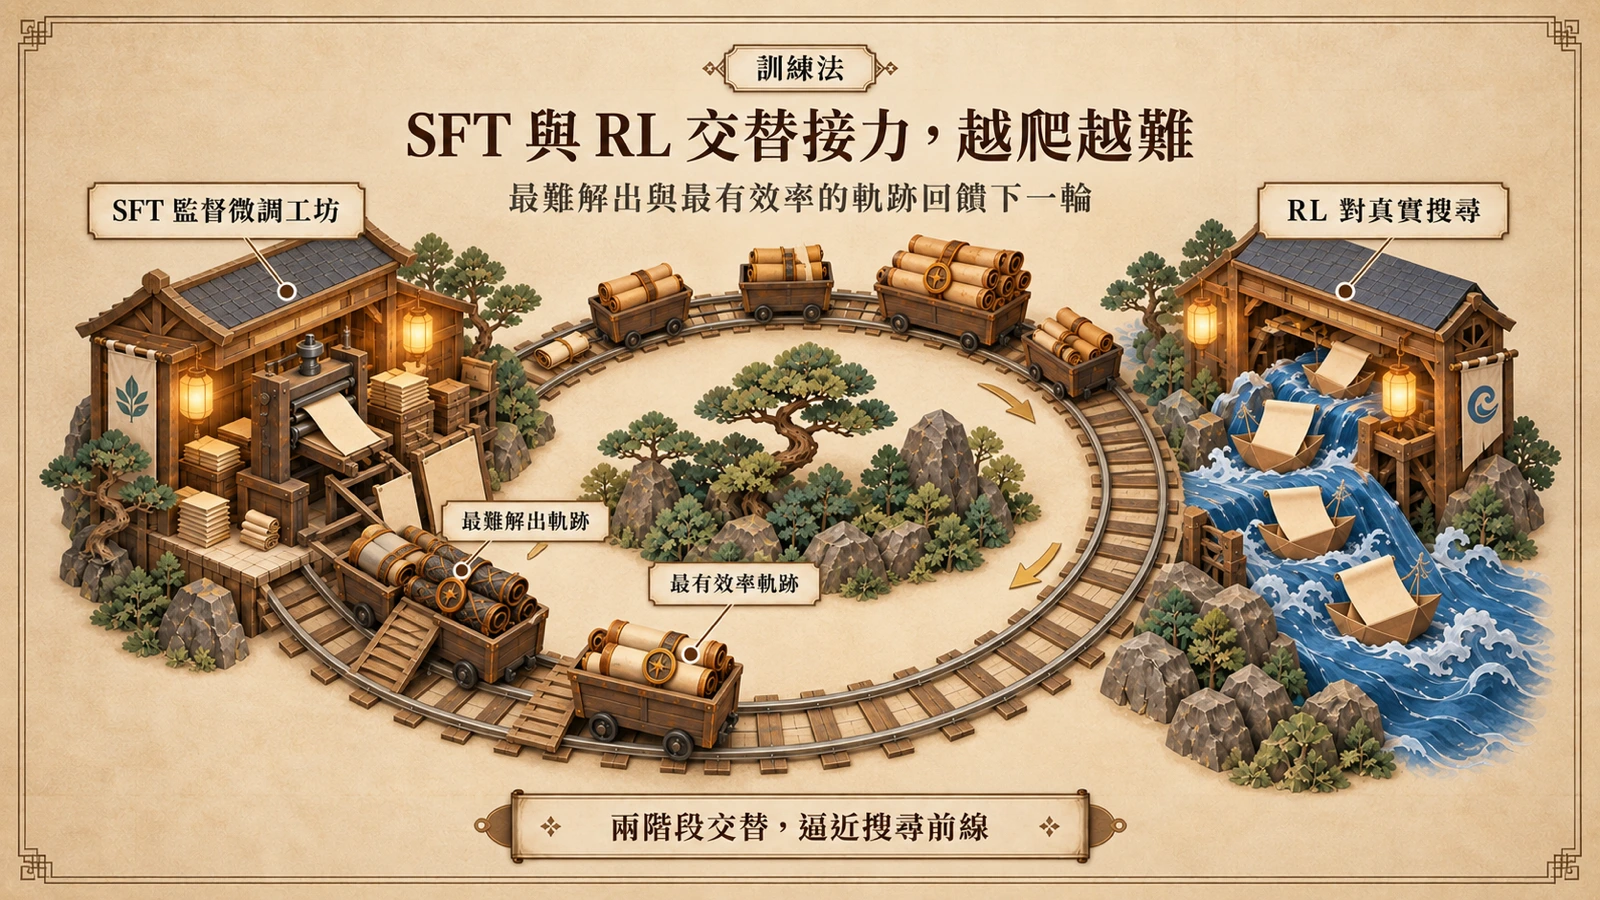
第二個賣點是訓練迴圈的形狀。強化學習階段不是對著離線模擬環境,而是直接對真實搜尋進行——模型在訓練中呼叫真正的搜尋,獎勵評審與觀察摘要器都部署在訓練叢集內,把延遲與不確定性壓在可控範圍。過長的推演軌跡會在請求層被中斷,下一步從已提交的前綴恢復,避免少數超長軌跡把訓練回合拖垮。
整個流程被命名為 SFT-RL climbing:監督微調與強化學習兩階段交替,每一輪強化學習中最難解出與最有效率的軌跡,被送回下一輪監督微調當教材。這個設計的直覺像爬岩壁:強化學習負責探索新路線,監督微調負責把成功路線固化成基本動作,兩者輪流把模型推向更難的任務——論文標題裡的 climbing 說的就是這件事。
單一 ReAct 代理,以及被低估的上下文管理
第三個賣點是評測態度。所有成績都來自單一 ReAct 代理:沒有子代理分工、沒有測試時驗證器。在多代理編排成為顯學的當下,這是個反潮流的選擇,含義也很直接——成績不是靠系統工程堆出來的,比較時不需要猜「背後掛了幾個代理」。
更值得產業注意的是論文的這個觀察:推論時的上下文管理,在這些基準上的影響比多數已發表的系統間差距更大。所謂上下文管理,是指在代理循環中對搜尋觀察內容的整理與壓縮——哪些原文保留、哪些摘要、哪些丟棄;訓練時團隊把觀察摘要器架在訓練叢集內,推論階段則把同一類問題變成評測設定上的顯性變數。因此團隊對每個基準都提供開啟與關閉上下文管理兩種設定的成績,並固定工具組、上下文上限與評審,讓比較條件一致。這等於提醒所有看榜的人:兩個模型相差三分,可能不如同一個模型有沒有做好搜尋結果的整理與壓縮。採購前先問一句——分數是在什麼上下文管理設定下跑出來的。
模型層對上工具層:與 Mistral Agentic Search 的差別
把 Iris 放回產業版圖,它走的是權重層路線:把搜尋策略訓進模型本身。一個現成的對照組是 Mistral 8 月底發布的 Agentic Search——那是工具層路線,用 search、open、navigate、read、grep 五個工具讓任何模型都能在長文件內多步檢索與驗證,官方數據在 FinanceBench 上把正確率從 26.7% 拉到 86%。
兩者不是競爭關係,而是互補:工具層定義動作空間(可以翻頁、可以定位),權重層定義策略(什麼時候翻頁、什麼時候停)。對自建深度搜尋產品的團隊,這代表兩個決策可以分開評估——用開放權重的 Iris 系列承擔策略,或用熟悉的模型搭配工具層快速上線,兩條路都有可回查的官方數字支撐。
對開發者與企業的實際影響
最直接的受益者,是需要在本地或私有環境跑深度搜尋的團隊。Iris-mini 的激活參數只有約 3B,推論計算量接近小型模型,但需要載入的完整權重仍有 350 億參數,屬於多卡工作站到單機多 GPU 伺服器的量級;Iris-pro 則是資料中心等級。開放權重,加上儲存庫內名為 Iris-Harness 的代理執行環境目錄,讓「自己跑一個深度研究代理」從閉源 API 的替代品,變成可以審視、可以微調的起點。
想驗證的團隊,方法可以很具體:挑十個自家最難的多跳查證題,固定同一組工具與上下文上限,分別跑現有檢索管線與 Iris 的推論設定,對比正確率與軌跡長度。論文提供的開啟/關閉上下文管理對照,本身就是一個現成的消融實驗模板,直接搬到自家場景就能用。
限制與值得追蹤的後續
誠實面對邊界。第一,所有評測數字都是團隊自行公布,AIDM 未獨立實測,第三方覆核也尚未出現;「同級開源最強」是論文自述,比較範圍與基線設定得到論文內文逐一核對。第二,權重已開放,但論文承諾的完整配方——資料構建、訓練與評測的細節——是計畫釋出,實際釋出進度與授權條款要以儲存庫與模型卡為準。第三,四項基準以英文為主、加一項中文瀏覽基準,繁體中文場景的表現需要自行驗證。第四,AllSpark 的論文與儲存庫都以團隊名義發表,第一方文件未說明隸屬機構與資金背景,關注治理的採購方應自行查證。
後續追蹤三件事:資料與訓練配方何時完整釋出、中文社群與第三方的獨立覆核何時出現,以及上下文管理元件是否被單獨開源——若釋出,它對既有檢索管線的增益可能不亞於模型本身。另一個可量化的觀察點是 BrowseComp-ZH:中文基準上 35B 與 397B 只差 0.3 分,若第三方覆核重現這個現象,對中文場景的模型選型會是很實用的訊號。