事情發生了什麼:美國政府站到 OpenAI 那一邊
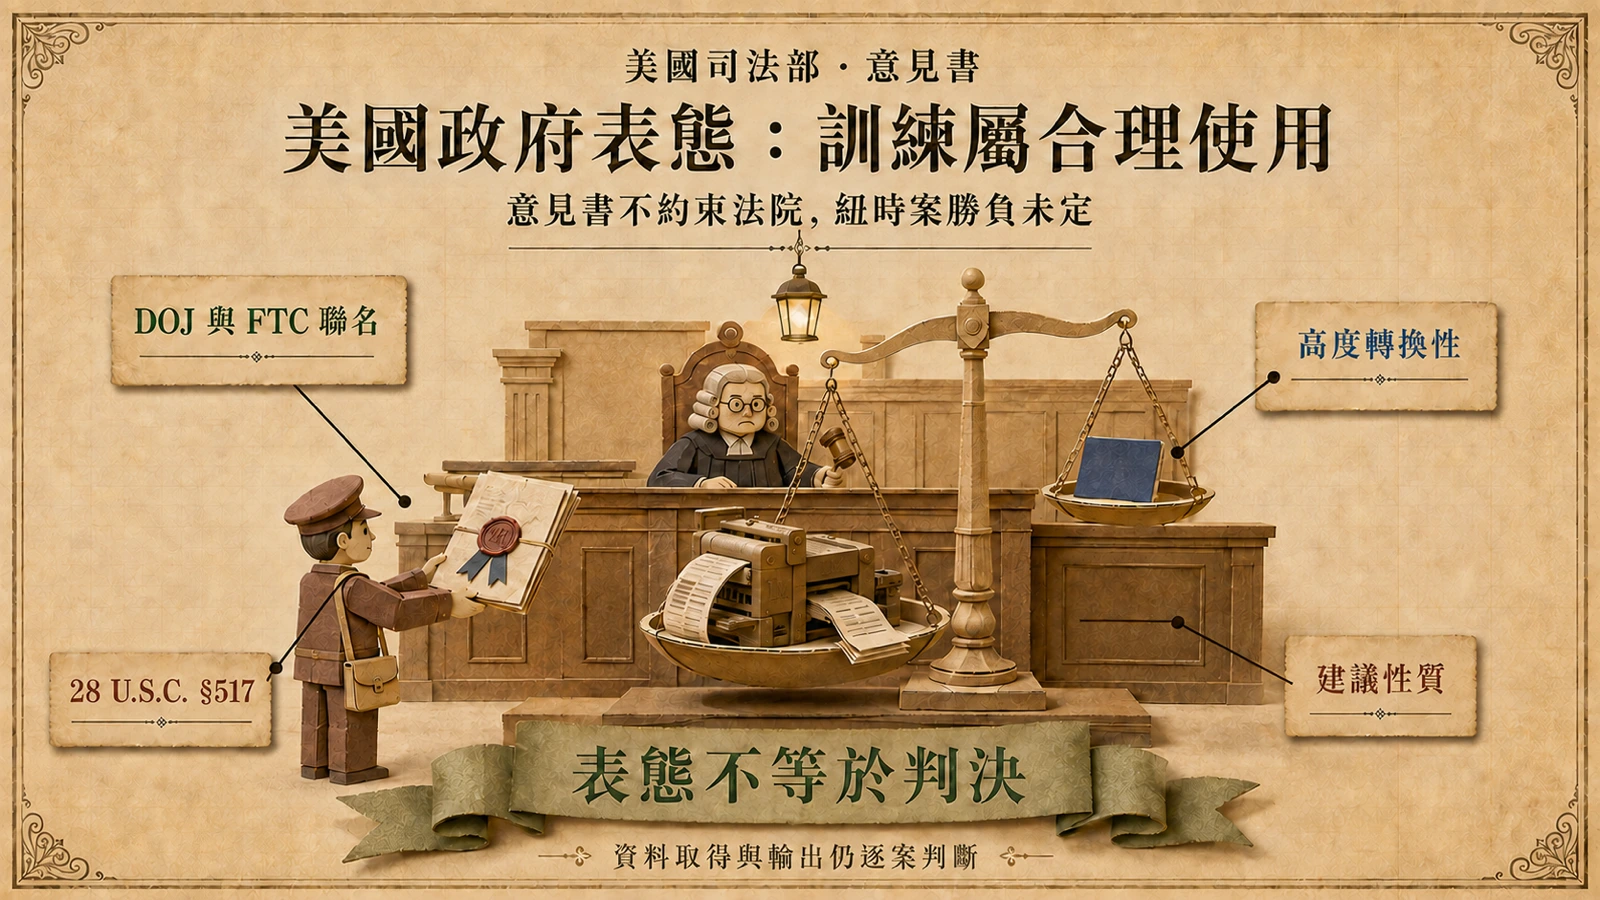
美國時間 9 月 1 日,司法部(DOJ)與聯邦貿易委員會(FTC)聯名向紐約南區聯邦地區法院提交《美國利益聲明》,正式介入《紐約時報》等出版機構與作者對 OpenAI、微軟的合併版權訴訟。據媒體報導,這是美國政府第一次在版權人集體起訴 AI 企業的訴訟中,就「用版權作品訓練大型語言模型是否侵權」向法院表態,文件由副司法部長 Stanley Woodward Jr. 等人簽署,他稱之為「具有歷史意義的利益聲明」。
這樁訴訟的原告陣容過去三年不斷擴大。《紐約時報》於 2023 年 12 月起訴 OpenAI 與微軟,指控兩家公司非法使用其數百萬篇受版權保護的新聞文章訓練 AI 系統,並求償「數十億美元」;此後《紐約每日新聞》、《芝加哥論壇報》等新聞機構與大批暢銷書作者陸續加入,案件合併為紐約南區聯邦法院的多區訴訟,由法官 Sidney Stein 審理。OpenAI 與微軟均否認侵權,主張其使用屬合理使用。
司法部在意見書中的立場毫不迂迴:據報導,美國在「法院駁回訓練侵權論點」這件事上具有強烈利益——用白話說,政府強烈希望法院拒絕任何「以版權文本訓練 LLM 違反版權法」的主張。換句話說,政府在一樁私人訴訟中選邊站了,而且站的是被告那邊。
意見書的核心主張:訓練具有轉換性
意見書的法律論證主軸,是美國版權法裡的「合理使用」(fair use)與「轉換性」(transformative use)概念。司法部主張:訓練階段雖然會完整複製作品,但複製的目的不是把原文提供給公眾,而是把文本轉化為數位資訊,讓模型分析詞語、語法、知識與表達之間的統計關係。原作品的目的是向讀者傳遞特定內容,訓練的目的則是建立一個能理解與生成語言的通用工具——用途上的這段差距,就是司法部所稱的「高度轉換性」,據報導文件並以「訓練帶來的創造可能與公共利益,遠超過任何競爭損害」作總結。
在法律論證之上,政府疊加了政策論證。意見書從國家安全角度出發,主張任何顯著增加「在美國建立強大 AI 產業」難度的法律規則,都會威脅國家安全、讓不受此束縛的外國對手取得競爭優勢;文件並引用關於「消除美國在 AI 領域領導地位障礙」的行政命令,稱 AI 主導地位事關國家安全、繁榮與經濟流動性。若《紐約時報》的主張獲法院全面支持,將「阻礙創造性與科學進步,同時妨礙美國的繁榮」。
這套論證的效果,是把一樁私人侵權訴訟重新框成國家競爭力的問題——版權不再只是創作者與使用者之間的分配爭議,而被放進大國競爭的天平。
利益聲明是什麼:能影響法官、不能決定判決
必須先釐清這份文件的性質:它不是判決,也不改變任何一方的舉證責任。依對本件的程序分析,司法部是依美國法典第 28 編第 517 條提交「利益聲明」——該條授權司法部長等官員在待決訴訟中出席並陳述美國政府的利益。這類文件可以影響法官的判斷,但對法院沒有當然拘束力;《紐約時報》訴 OpenAI 案也沒有因此產生任何結果。
更關鍵的是,司法部自己劃清了界線:政府並未授權、同意或認可本案所指控的任何具體行為。OpenAI 是否在資料取得、模型訓練與內容輸出的具體環節構成侵權,仍要由法院根據證據逐一判斷。政府支持的「訓練原則上屬合理使用」是個抽象命題,不是為 OpenAI 的每一項作為背書。
對讀者而言,這是理解整起事件最重要的一道防線:表態不等於勝訴,框架不等於結論。意見書改變的是政治與政策氛圍,而非法律上的勝負。
三階段拆解:取得、訓練、輸出分開判斷
意見書在方法論上最值得注意的,是把大模型的開發拆成三個可能各自產生不同版權問題的環節:第一,取得與儲存資料;第二,複製作品用於訓練;第三,依使用者指令生成輸出。三個環節各自獨立檢驗,不能因為某個環節出現問題,就當然否定其他環節。
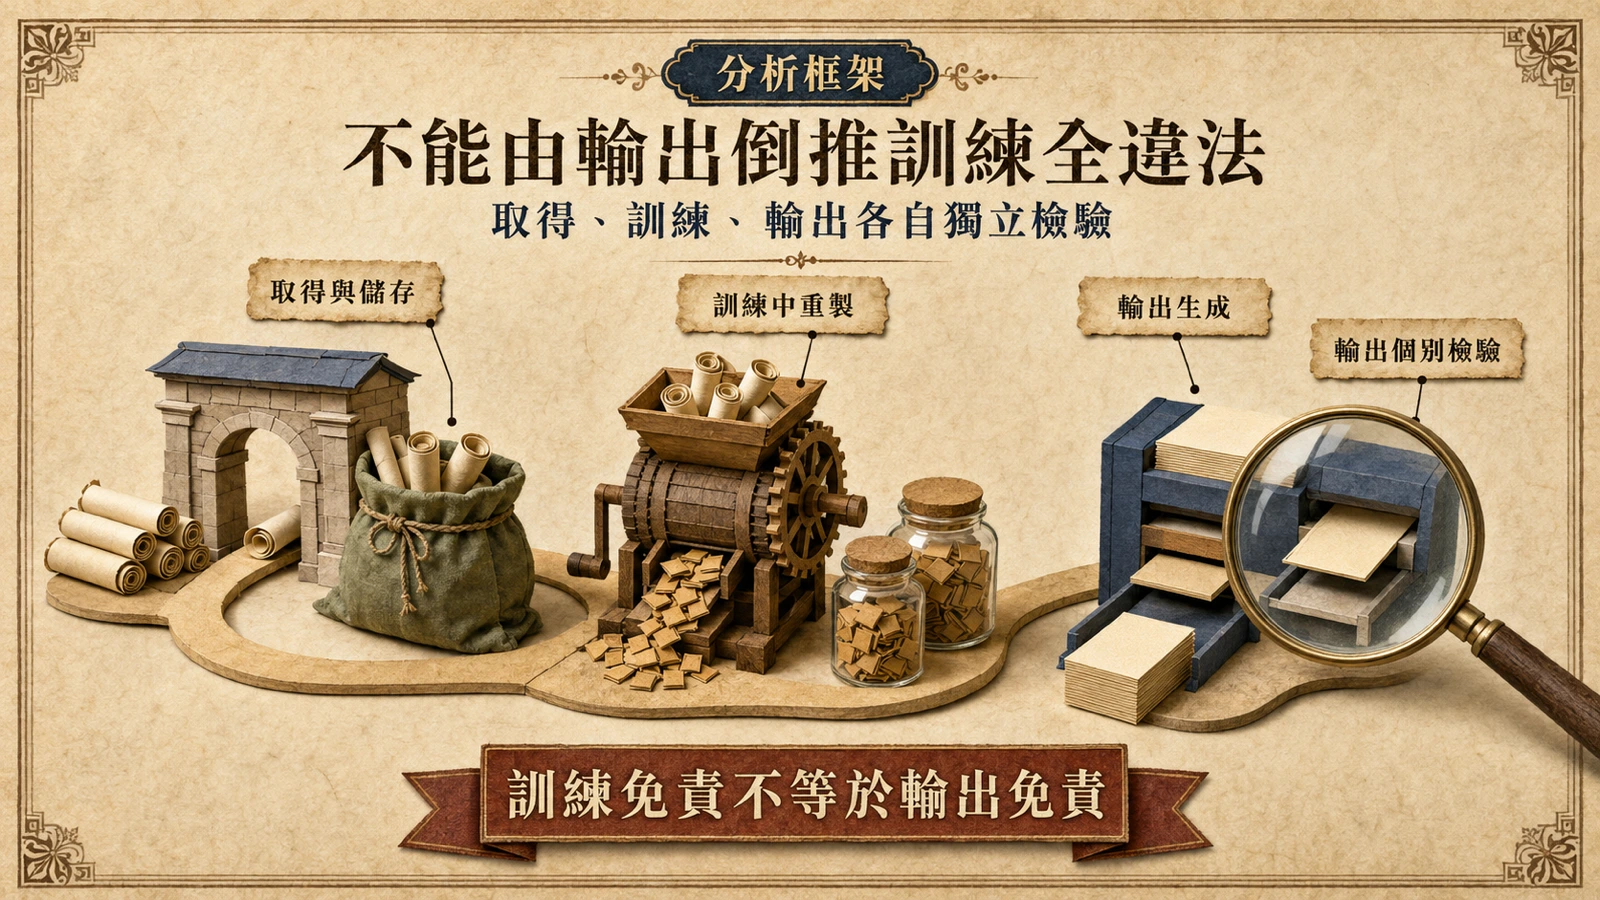
這個框架的用意,是切斷「輸出有問題、訓練就全部違法」的推論鏈。司法部承認訓練階段可能複製完整作品,但主張這些作品不是以文章、小說或圖片的形態提供給公眾;即使模型在極少數情況下產生記憶性輸出、重現原文段落,也應針對具體輸出個別判斷,而不是以少量異常輸出否定整個訓練過程。合理使用看的不是「複製了多少」,而是「為什麼複製、以及最終向公眾提供了什麼」——若最終提供給公眾的不是完整作品、也未實質替代原作,完整複製本身不必然排除合理使用。
同一條界線的反面同樣清楚:版權控制的是作品表達的複製與傳播,不是事實、知識與語言規律。模型可以學習知識,不等於可以交付原作——若模型能重現文章的重要段落,或讓使用者不必造訪原始媒體就能取得實質相同的內容,問題的性質就變了。據報導,意見書同時批評原告方賴以主張市場損害的「稀釋」理論,認為此一論證有根本缺陷。
脈絡:版權局報告、Anthropic 和解與跨國判準分歧
政府的這一步並非憑空落下。美國版權局 2025 年 5 月發布《版權與人工智慧》第三部報告,主題正是生成式 AI 訓練;版權局官方頁面說明,最終版將在不改變分析與結論的前提下於日後發布。該報告對合理使用的判斷高度依賴個案事實——訓練用途、資料來源與輸出形態都會影響結論,並未給出「訓練一律免責」的一刀切答案。司法部的意見書沿著同一條「分環節判斷」的路走,但在政策天平上明顯更往產業傾斜。
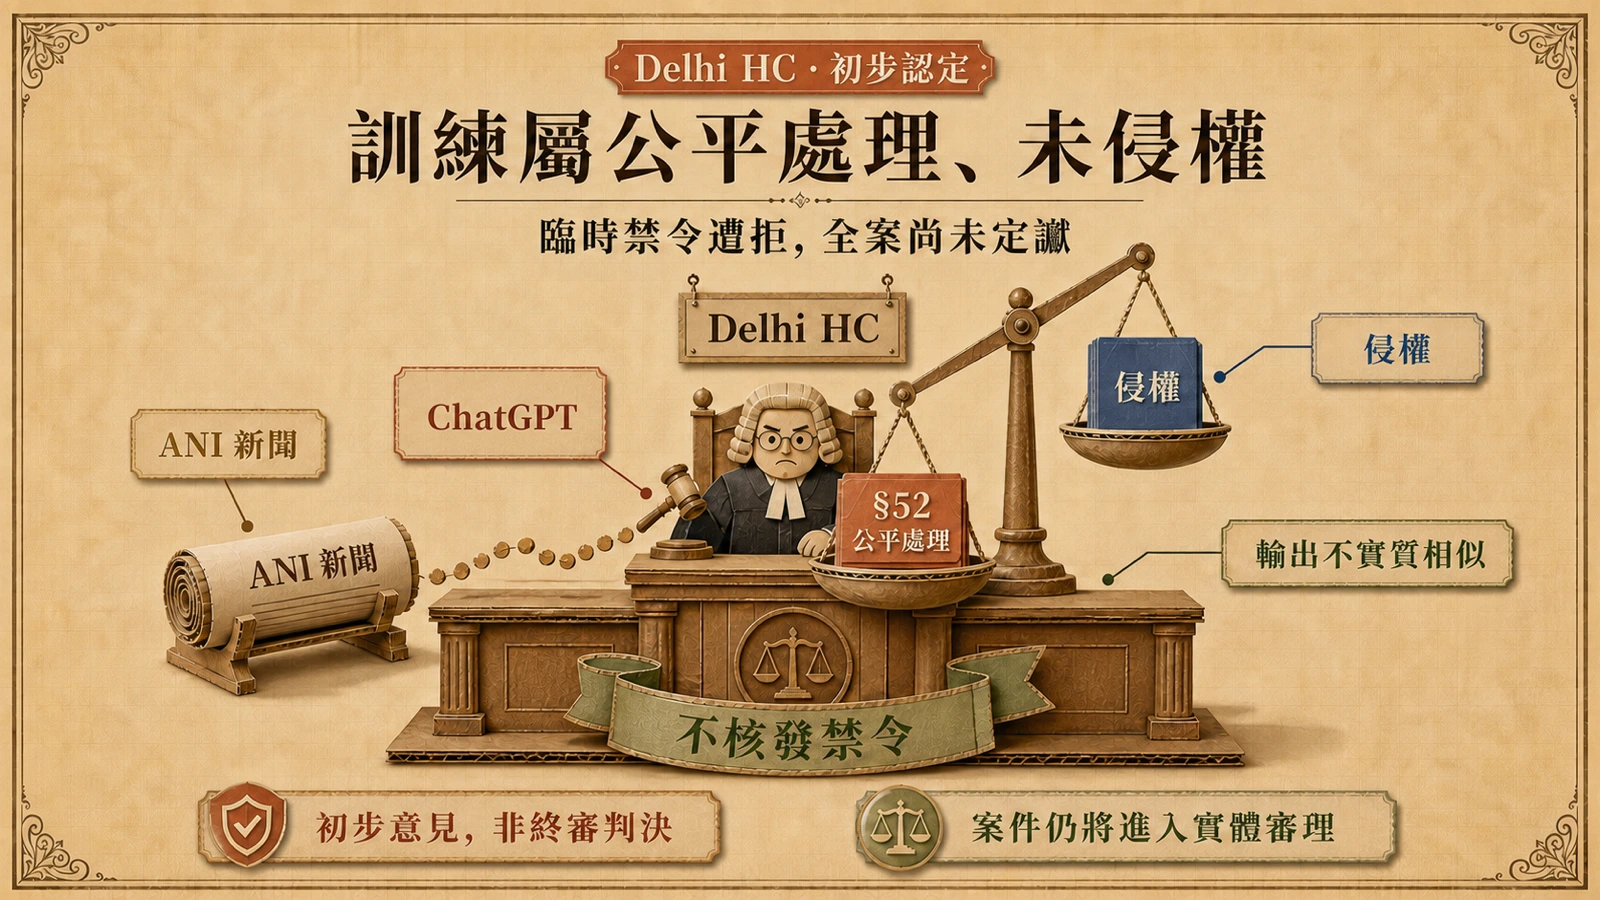
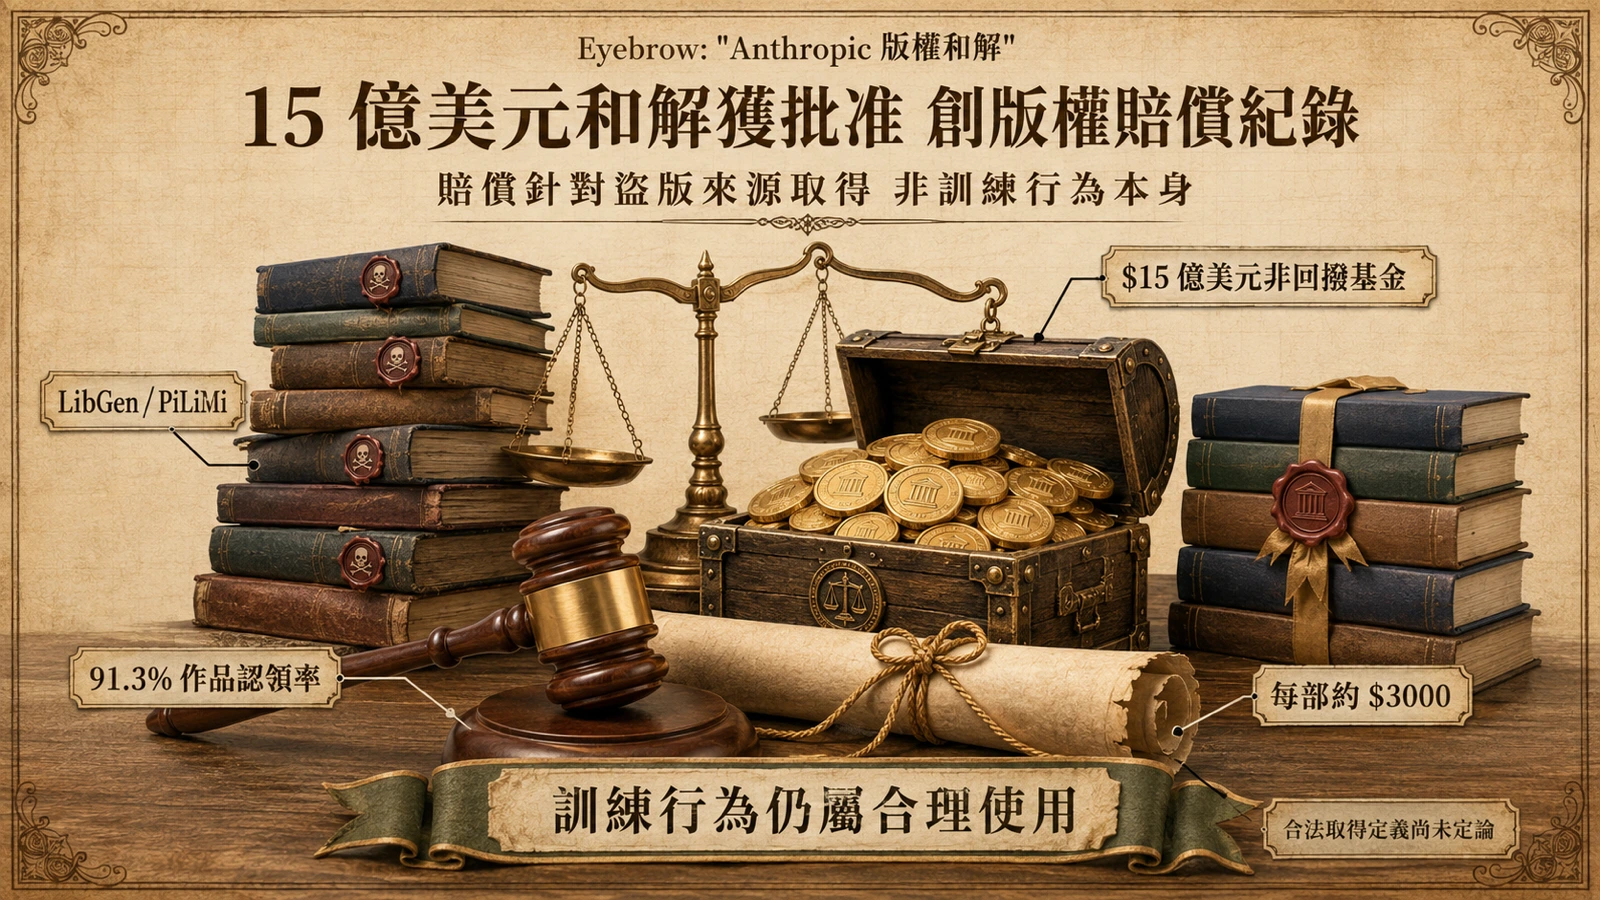
司法體系也已有先例可循。本站先前報導的Anthropic 15 億美元版權和解顯示,加州北區聯邦法院在圖書作者案中區分了「取得方式」與「訓練行為」:自盜版資料庫取得書籍須賠,合法取得的書籍用於訓練則被認定屬合理使用。大洋另一端,德里高等法院在 ANI 案的初步意見則落在輸出端:因 ChatGPT 產出與原文不實質相似,初步認定訓練屬公平處理。不同法域各自選擇了不同的切入軸,共同點是把「訓練」從鐵板一塊拆成可分析的部分。
司法部的意見書,是把美國行政部門的重量壓上了其中一側——它不僅重述了「分階段」的分析路徑,還首次為這條路徑加上國家安全與產業政策的背書。
影響:授權市場不會消失,但談判籌碼正在移動
對 AI 開發者而言,這份意見書是明確的風向訊號:行政部門不希望法院作出「未經授權訓練普遍侵權」的廣泛判決。但對內容產業而言,文件中最刺耳的可能不是合理使用論,而是接下來這段:司法部認為,不能僅因版權人「願意出售授權」,就推定法律必須承認這個市場——否則只要對一項原本可能屬於合理使用的行為開價,就能用「沒收到授權費」證明市場損害,再以市場損害反過來否定合理使用,形成循環論證。
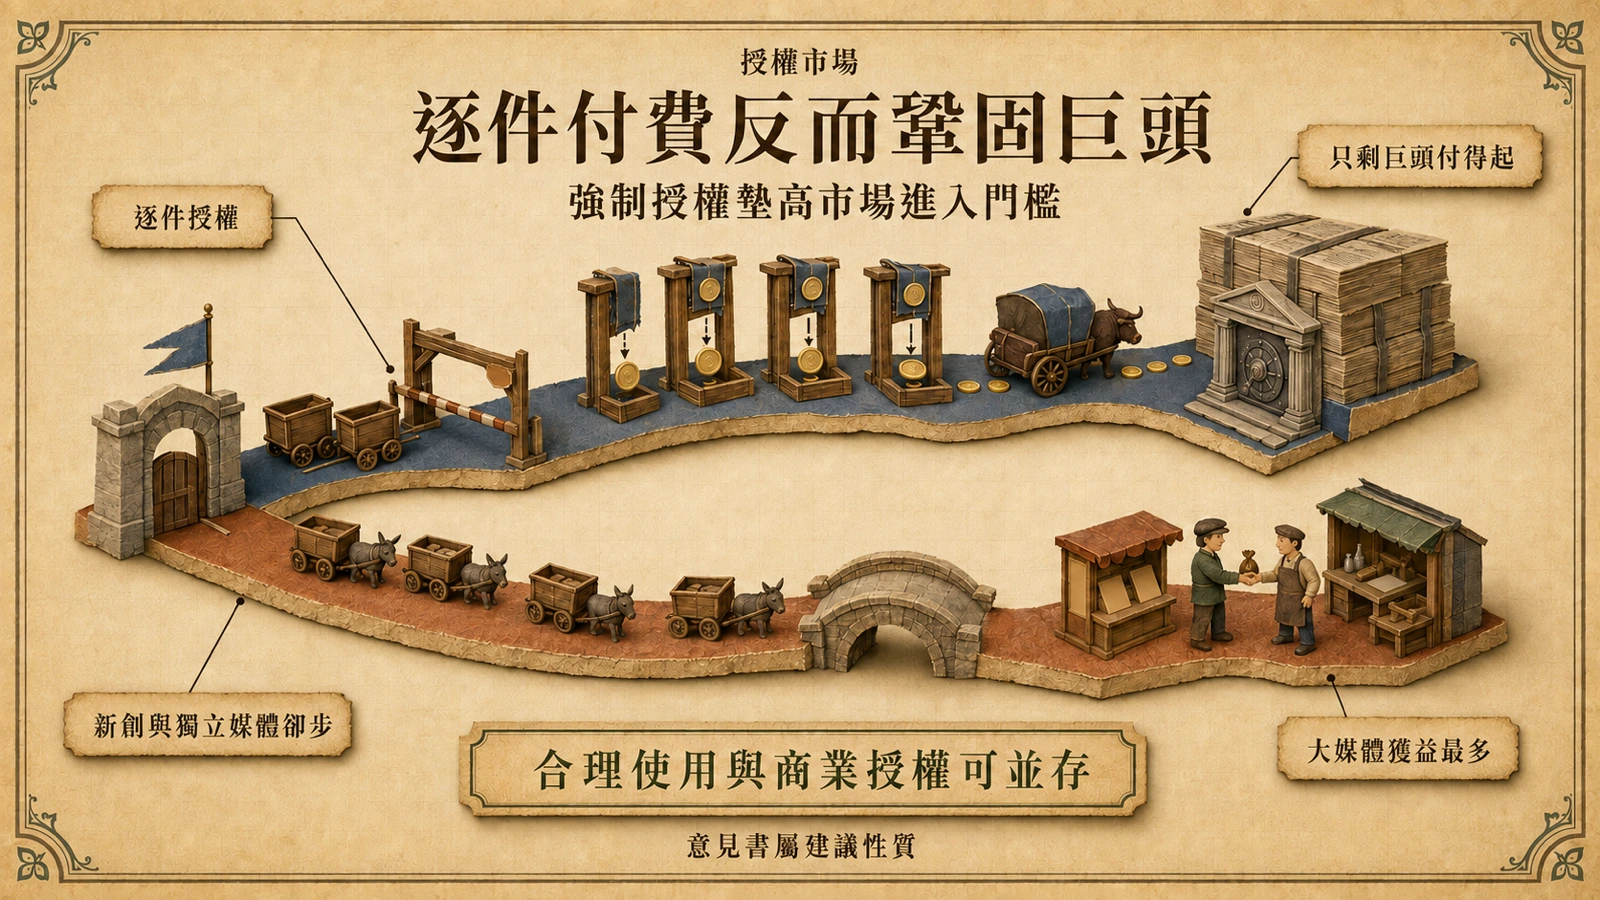
針對意見書授權市場結構的分析進一步指出其產業政策轉向:若所有訓練資料都必須逐件付費,只有資金最雄厚的科技企業負擔得起,反而鞏固大型 AI 公司的優勢、阻止中小模型業者進入市場;同時擁有海量歷史內容的大型傳統媒體將取得最多授權收益,獨立媒體與新創作者未必能公平參與分配。過去 AI 企業主要從技術層面辯護「訓練不是複製作品、而是學習規律」,現在政府再疊上產業競爭結構的論證——版權從此不只衡量創作者報酬,也被放進市場集中度的天平。
但授權市場不會因此消失。意見書本身承認,無論訓練是否屬合理使用,AI 企業仍可與媒體及內容機構簽署商業授權,取得即時內容、付費牆內容與專業資料庫等高品質資訊。《紐約時報》發言人 Graham James 的回應則針鋒相對:政府站在少數幾家市值萬億美元的 AI 公司那一邊,犧牲了無數作品被取用的美國創作者;AI 公司只需按版權法的要求,為造就其產品的內容公平付費。《紐約每日新聞》首席律師 Steven Lieberman 更批評,政府的立場無視美國憲法的版權條款,且與版權局先前表達的觀點相矛盾。
對台灣與華文內容產業的意義
美國的判決與意見書都不直接適用於台灣。我國著作權法第 65 條的四項合理使用判準——利用之目的及性質、著作之性質、所利用之質量及其在整個著作所占之比例、利用結果對著作潛在市場與現在價值之影響——與美國 fair use 架構同源但各自獨立運作,國內迄今也沒有針對 LLM 訓練的權威判決。
間接影響則相當實際。台灣與華文媒體、出版業者若與美國 AI 公司洽談內容授權,對方的談判底線與法律風險評估會直接參照美國訴訟走向:若法院最終傾向「訓練屬合理使用」,權利人能主張的就不再是「非授權不可」,而是授權所能換取的即時性、內容品質與技術整合等差異價值——議價重心從法律義務移向商業實益。反之,若簡易判決階段法院展現不同意見,授權談判的天平會立刻回擺。對以內容授權為業的機構而言,現在比起押注單一結果,更值得做的是把授權條款的時效、範圍與輸出限制談清楚。
不確定性與接下來的觀察指標
這份意見書留下至少三個未決問題。其一,法官 Sidney Stein 已要求雙方最遲於 9 月 4 日(週五)提交簡易判決動議,法院如何回應政府的框架——採納、忽略或部分採納——將是第一個訊號。其二,意見書刻意保留的資料取得問題(爬取方式、盜版來源、合約限制)在實體審理中如何處理,決定了「訓練免責」的實際邊界有多窄。其三,輸出端的記憶與重現爭議,仍是原告最有機會得分的主戰場。
值得追蹤的後續指標包括:簡易判決動議與裁決時程、其他聯邦法院對同類案件是否跟進政府的分析框架、版權局最終版報告與國會修法動向,以及大型媒體與 AI 公司之間新簽授權協議的條件變化。對依賴美國模型的開發者與企業而言,這些指標比意見書本身更值得放進追蹤清單——表態已經揭曉,判決還沒有。