開源的不是編輯模型,是生產編輯資料的產線
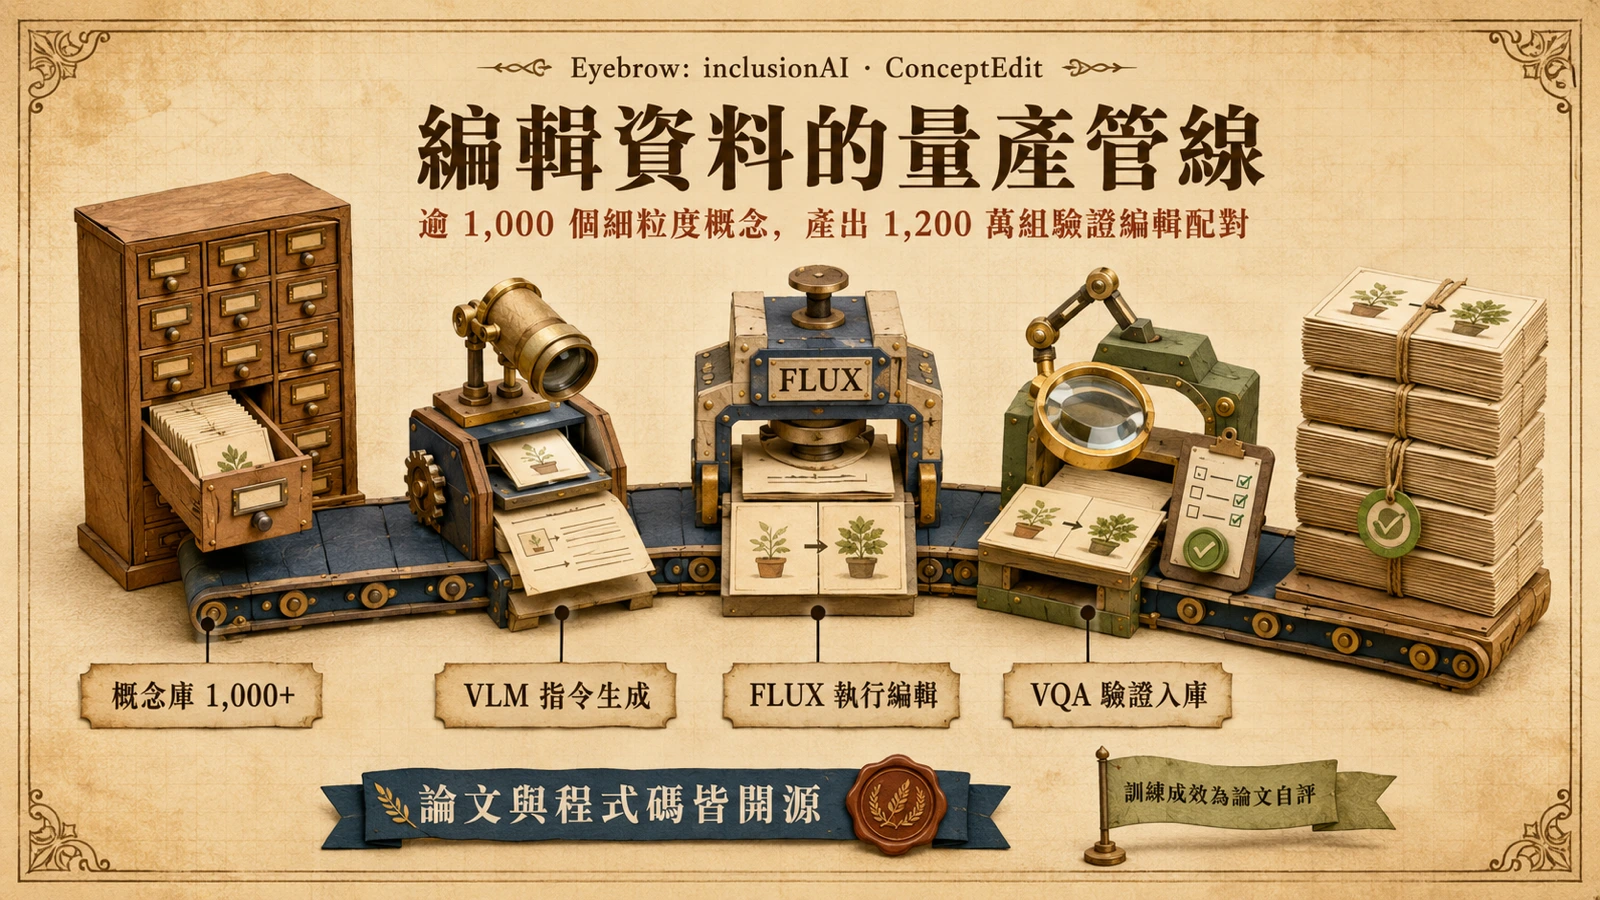
螞蟻集團的開源組織 inclusionAI 在 GitHub 釋出 ConceptEdit,同名論文《Unlocking the Potential of Image Editing via Concept Scaling and Dense Supervision》則於 2026 年 8 月掛上 arXiv(編號 2608.16812)。這次開源的主體需要先講清楚:它不是一款會改圖的模型,而是一條大量製造「圖像編輯訓練資料」的管線,連同產出的資料集與評測基準一起公開。
論文全文對成果的載明很直接:產出 ConceptEdit-12M——一個包含 1,200 萬組「經驗證、高品質」圖像編輯配對的大型資料集,且資料集與評測基準覆蓋超過 1,000 個細粒度分類。名稱裡的兩個關鍵詞——概念擴編(concept scaling)與密集監督(dense supervision)——正是它與既有編輯資料做法的兩條分岔線,後面會分別拆開來講。
對關注 inclusionAI 的讀者來說,這個組織並不陌生:螞蟻 Ling 系列混合推理模型正是同一個開源品牌的作品,只是先前的主角是語言模型,這次轉向視覺編輯的資料工程。
三階段產線:概念庫、指令生成、編輯執行
管線的骨架在論文裡拆成三個階段。第一階段是概念庫構建(Library Construction),藉助 LLM 的世界知識,把「可以對一張圖做什麼編輯」展開成階層式的概念清單——這是概念擴編的源頭:與其讓資料集的編輯類型隨機長出來,不如先系統性地把概念空間鋪滿。第二階段是語意匹配與指令生成(Semantic Matching and Instruction Generation),為概念找到合適的圖像、生成對應的編輯指令,而且過程中會一併建立 VQA 檢核表。第三階段才是編輯執行(Edit Execution),把指令真正套用到圖片上,產出編輯前後的配對。
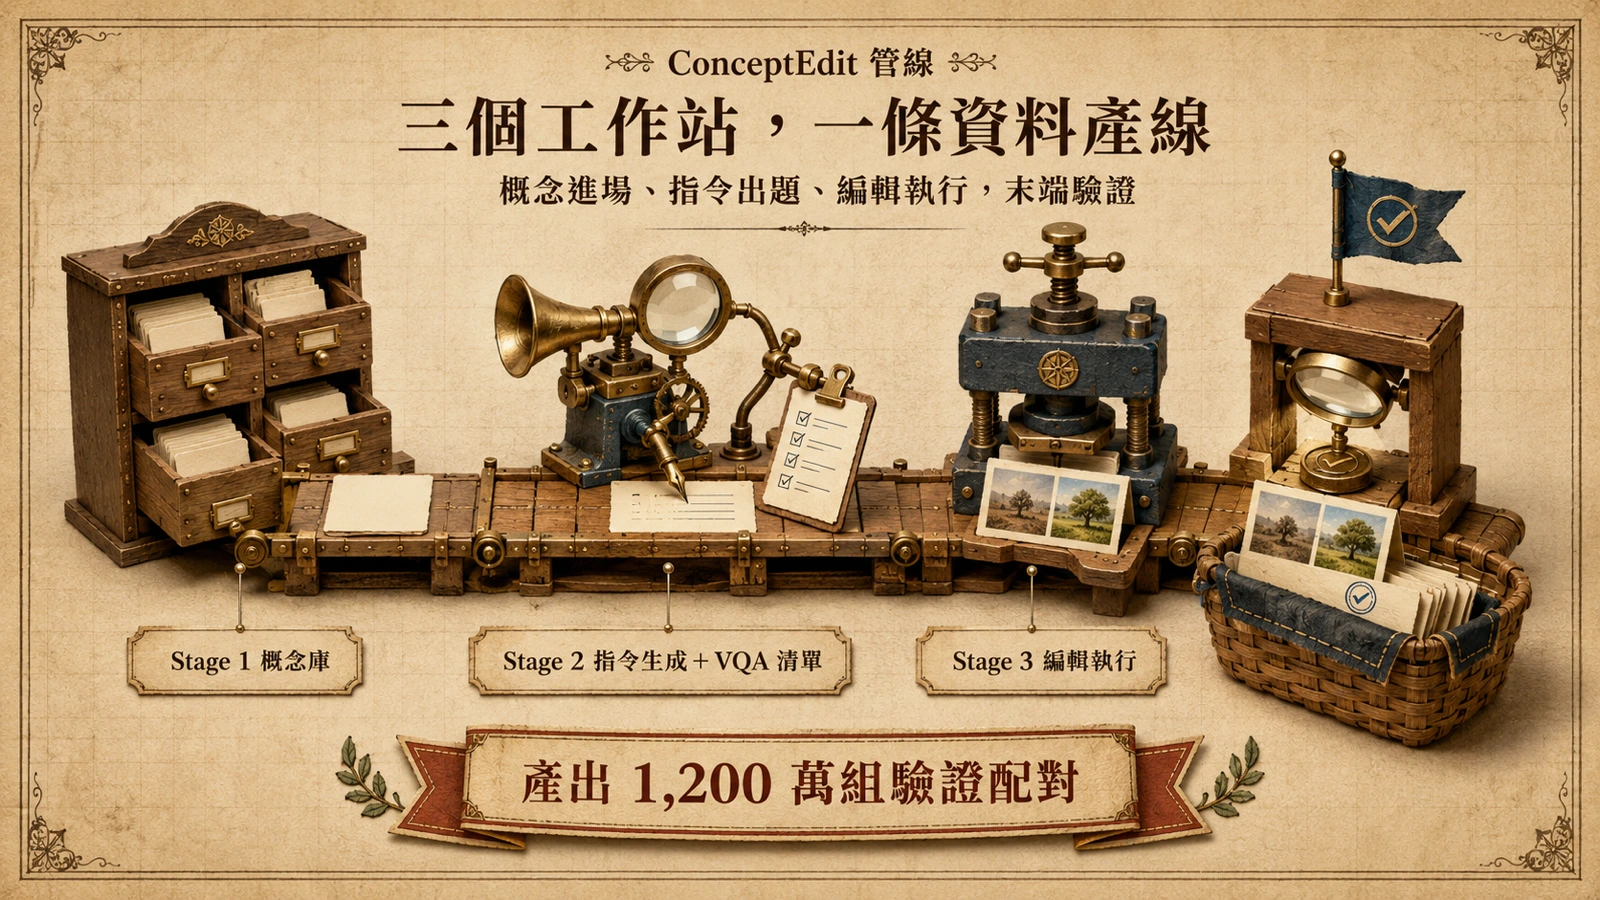
實際要跑這條產線,官方儲存庫的 Setup 說明開出的條件是:一個 OpenAI 相容的 VLM 端點(例如以 vLLM 或 SGLang 服務的視覺語言模型)負責指令生成與評估,加上一個在本機載入的 FLUX 模型負責執行編輯。換句話說,整條管線的分工是「VLM 出題與改考卷、FLUX 動手改圖」。FLUX 是 Black Forest Labs 的影像生成模型家族,該家族今年已把路線推進到多模態影音生成;在 ConceptEdit 裡,它被放在編輯執行器的位置,而不是論文的主角。
逐例 VQA 過濾:把幻覺擋在資料進訓練集之前
合成編輯資料最怕的不是量不夠,而是「看起來對、其實錯」的配對混進訓練集。ConceptEdit 的回答是逐例(instance-specific)VQA 過濾:不是套用一套通用的「這圖改對了嗎」標準,而是針對每一個編輯實例,用前一階段建立的 VQA 檢核表,逐項驗證編輯結果是否真的達成指令要求。論文明確將這種逐例過濾與通用 VLM 驗證做對照,結論是前者能確保高保真對齊、抑制幻覺,錯誤率也低於通用驗證。
這個設計值得注意的是它承認了一件事:VLM 自己就會出錯,所以驗證不能靠模型自由心證,而是把驗證條件在指令生成的當下就具體化成可逐項檢查的問題。對任何想自製合成訓練資料的團隊,這個「出題時就同步產生考卷」的模式,比任何單點的品質分數都更容易複製,也更容易除錯——壞樣本被擋下來時,你會知道它是敗在哪一個檢核項目。
密集監督:一個樣本乘載多個編輯概念
第二條軸線密集監督,處理的是訓練效率。論文提出的訓練方法,是把多個不互相干擾的編輯概念組合進同一組編輯配對,讓每個訓練樣本提供更豐富的監督訊號,並以此提升訓練效率。白話地講:如果一組配對只教「把貓換成狗」,模型每次只從一個孤立的樣本學一個概念;若同一組配對同時包含背景、光線、物件屬性等多個互不衝突的編輯,同一筆資料就能一次教會模型多個概念如何協同作用。
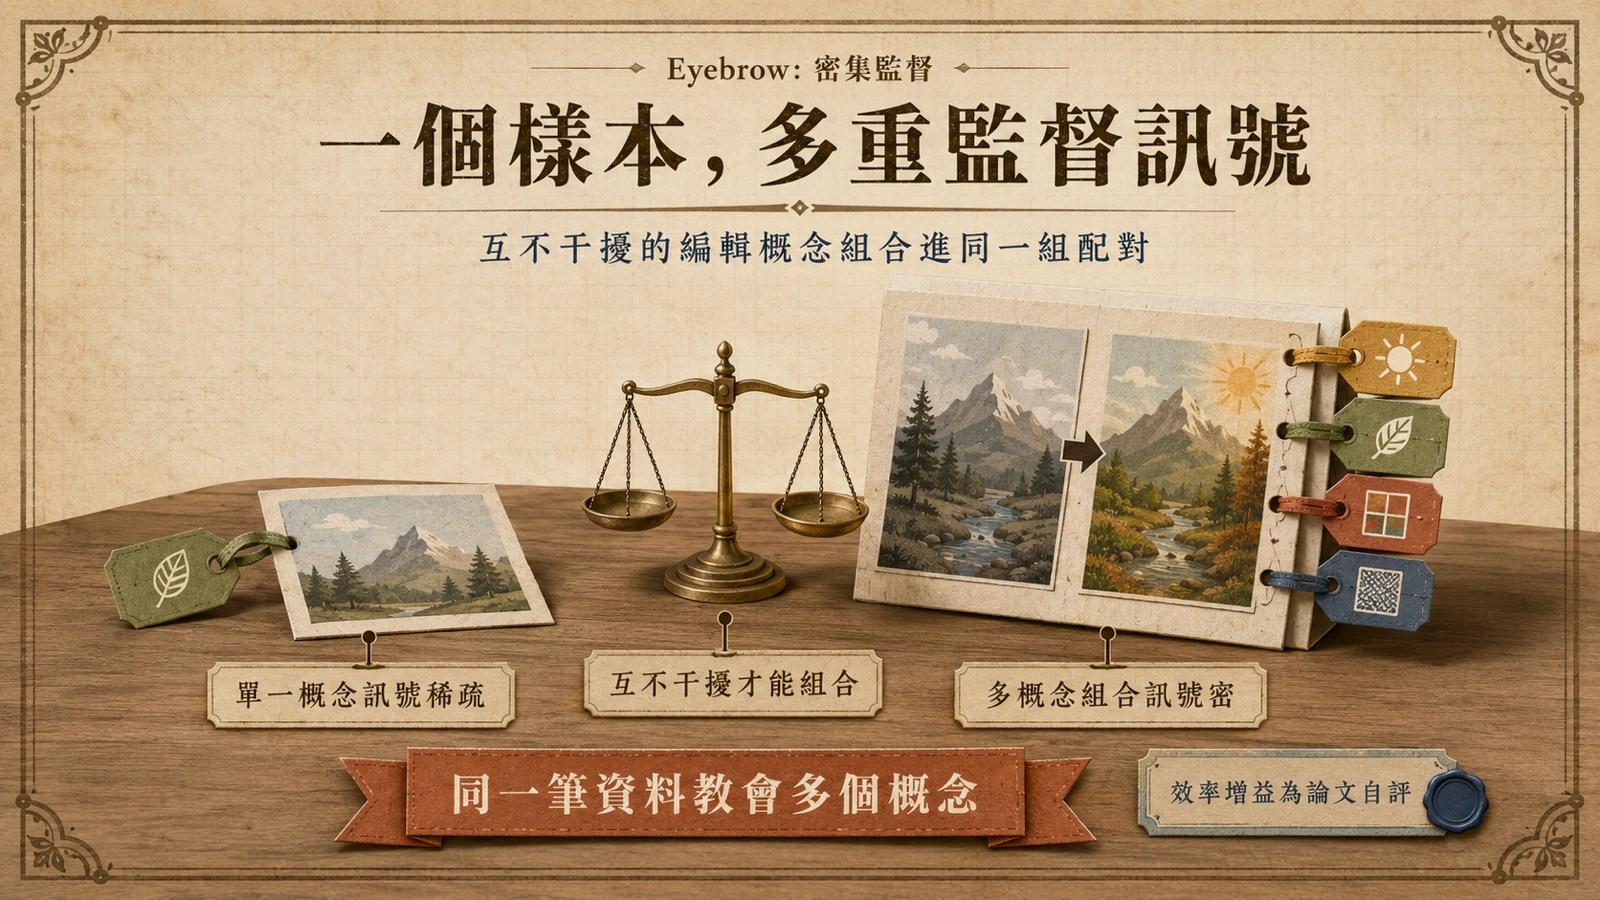
這與概念擴編是同一枚硬幣的兩面:概念清單鋪得夠廣,才有素材可以安全組合;組合得當,擴編出來的每一個概念才不會淪為資料集裡的稀疏長尾。「1,200 萬組」的規模數字,就是在這兩個設計疊加之後跑出來的。
為什麼編輯資料是瓶頸
論文開頭就點出動機:既有的圖像編輯框架,大多沿用文生圖擴散模型的訓練範式。這句話背後的產業現實是:編輯模型的能力上限,往往不是卡在架構,而是卡在「有沒有足夠多、夠多樣、標註正確的編輯配對」。應用端對編輯精度的要求正在快速拉高——xAI Imagine Image 2.0 強調點選區域、其餘不動的精準編輯,就是同一個方向的產品化縮影——而這類能力的每一分推進,上游都要有人把對應的編輯資料做出來。
ConceptEdit 把這件上游苦工變成一條可重跑的開源產線。定位上,它與其說是對某一款編輯模型的挑戰,不如說是對「每個想訓練編輯模型的團隊都要自己摸索資料配方」這個現狀的挑戰:資料工程的門檻降下來之後,競爭焦點會更集中在概念設計與領域知識,而不是誰有錢標註更多圖。
對訓練團隊的實際意義
最直接的受眾,是需要垂直領域編輯能力的團隊。電商情境的背景替換與材質調整、設計情境的局部改色與風格遷移、內容情境的文字置換——這些概念在通用資料集裡要不是覆蓋稀薄,就是根本缺席。管線開源之後,團隊可以把自家領域概念餵進概念庫,讓 VLM 與 FLUX 按同一套流程量產配對,再靠逐例 VQA 把關品質,而不是從零標註。
第二層意義是成本結構。以 vLLM 或 SGLang 自架 VLM 端點、FLUX 在本機執行,整條管線不綁定任何單一廠商的付費 API。對需要反覆迭代資料配方的訓練場景,這種可自持的堆疊比單次呼叫的便利性更重要——資料配方改一版就重跑整條產線,若每次都按 API 呼叫計費,迭代成本會隨概念數量線性膨脹。
限制與值得追蹤的指標
三個但書需要放在桌上。第一,訓練增益是論文自評:全文宣稱密集監督能提升訓練效率,但對應的具體基準分數與對照組幅度,本文未從第一方來源取得逐項數字,採用前應回到論文查證。第二,合成資料的迴圈風險:編輯結果由 FLUX 產生,用這些配對訓練的模型可能繼承 FLUX 的偏見與錯誤;逐例 VQA 過濾能降低錯誤,但不能清零。第三,ConceptEdit-Bench 由同一批作者設計,模型在自家基準上的表現如何,需要等待第三方重現。
值得追蹤的後續指標有三個:ConceptEdit-12M 資料集是否在 Hugging Face 等平台開放下載、獨立團隊用該資料訓練的模型能否重現論文宣稱的效率增益,以及這條管線換上其他編輯執行器(不限 FLUX)之後的表現。資料管線的真正考驗從來不在發布當天,而在第一批陌生人跑完之後還願不願意留下來。