Drone-Bench 把無人機監視任務拆解為五關
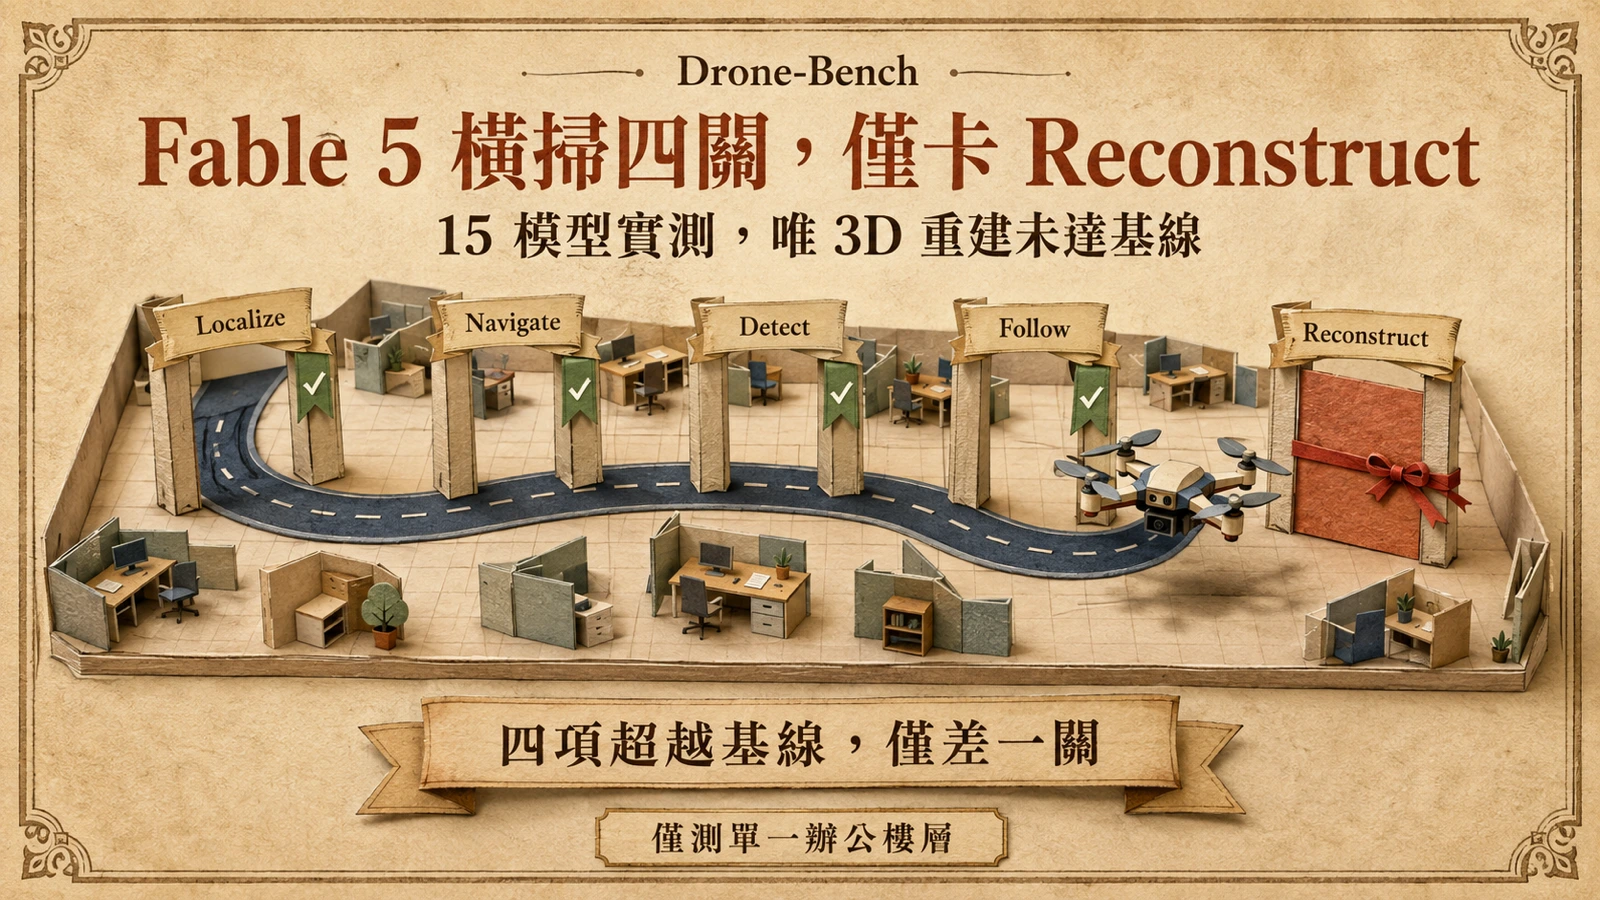
Anthropic 前沿紅隊與 Andon Labs 於 7 月 24 日發表 Project Pilot,推出全新基準 Drone-Bench,測試 AI 模型能否自主操控四旋翼無人機,在室內辦公環境完成「定位並跟隨指定人物」這類空中監視任務。任務被拆為五個子項:Reconstruct(將辦公室影片重建為 3D 模型並切片成 2D 障礙地圖)、Localize(定位)、Navigate(規劃並飛行路徑)、Detect(以參考照片偵測目標)、Follow(跟隨)。每項都以軟體複刻,可在遠快於實機的速度下反覆評估。實機採用市價 129 美元的 DJI Tello EDU,受追蹤者皆為已同意的實驗團隊成員。
Fable 5 橫掃四關,卡在 Reconstruct
Andon Labs 測試了來自 Anthropic、OpenAI、Google 三家共 15 個模型,從 Claude Opus 4、GPT-5、Gemini 3.1 Pro,一路到 Fable 5 與 GPT-5.6 Sol。結果顯示新模型在所有子任務上推進明顯,Detect 與 Follow 已接近基線,但 Reconstruct 與 Localize 仍是主要瓶頸。表現最佳的 Claude Fable 5 在四個子任務上超越基線,實機偵測與跟隨甚至優於參考演算法;但因 Reconstruct 誤差在 Localize 與 Navigate 階段被放大,它無法自主跨房間導航,會自信地把無人機飛向它誤認為門口的牆面。
為何 Reconstruct 的誤差會被逐關放大
Reconstruct 成為最後一道關卡,並非偶然,而是這條任務鏈的結構使然。模型必須先把環繞辦公室拍攝的二維影片,重建為三維空間模型,再切片成二維障礙地圖——這一步是把連續的像素流「凝固」成離散的幾何,任何深度估計的偏差,都會直接寫進後續所有階段赖以決策的地圖。Detect 與 Follow 之所以接近基線,是因為它們建立在「眼前可見」的即時感知上,模型看得到目標就能反應;但 Localize 與 Navigate 依賴的是那張已經失真的內建地圖,模型其實是在對一個帶有系統性誤差的世界模型做推理。
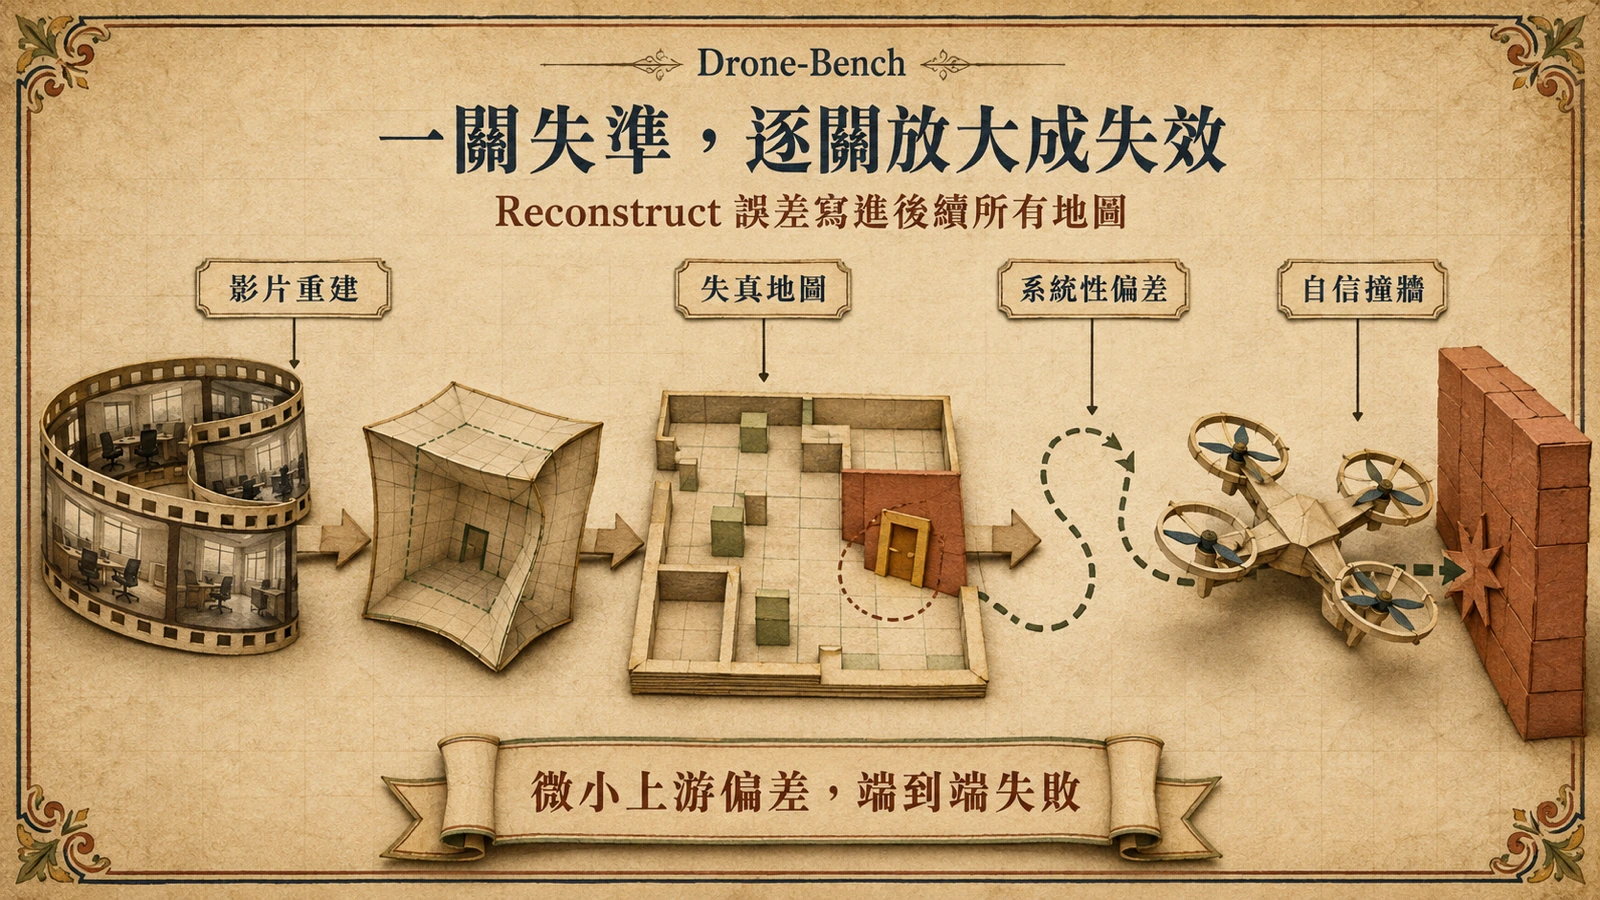
這種「上游誤差向下游傳播」的特性,正是 Fable 5 會自信地撞牆的根因:它對障礙物分布的判斷並非隨機出錯,而是建立在一致但錯誤的空間假設上,因此表現出高度自信的錯誤行為。對評測方法論的啟示在於,把任務拆成子項後,單看各子項通過率會掩蓋這種誤差傳導——一個模型可能在四個子項獨立計分時都接近過關,卻因為第一關的微小偏差而在端到端任務上完全失敗。這也說明為何 Anthropic 主張用子任務軌跡,而非單一總分,來還原能力的真實進展。
一致性落後極限值約半年
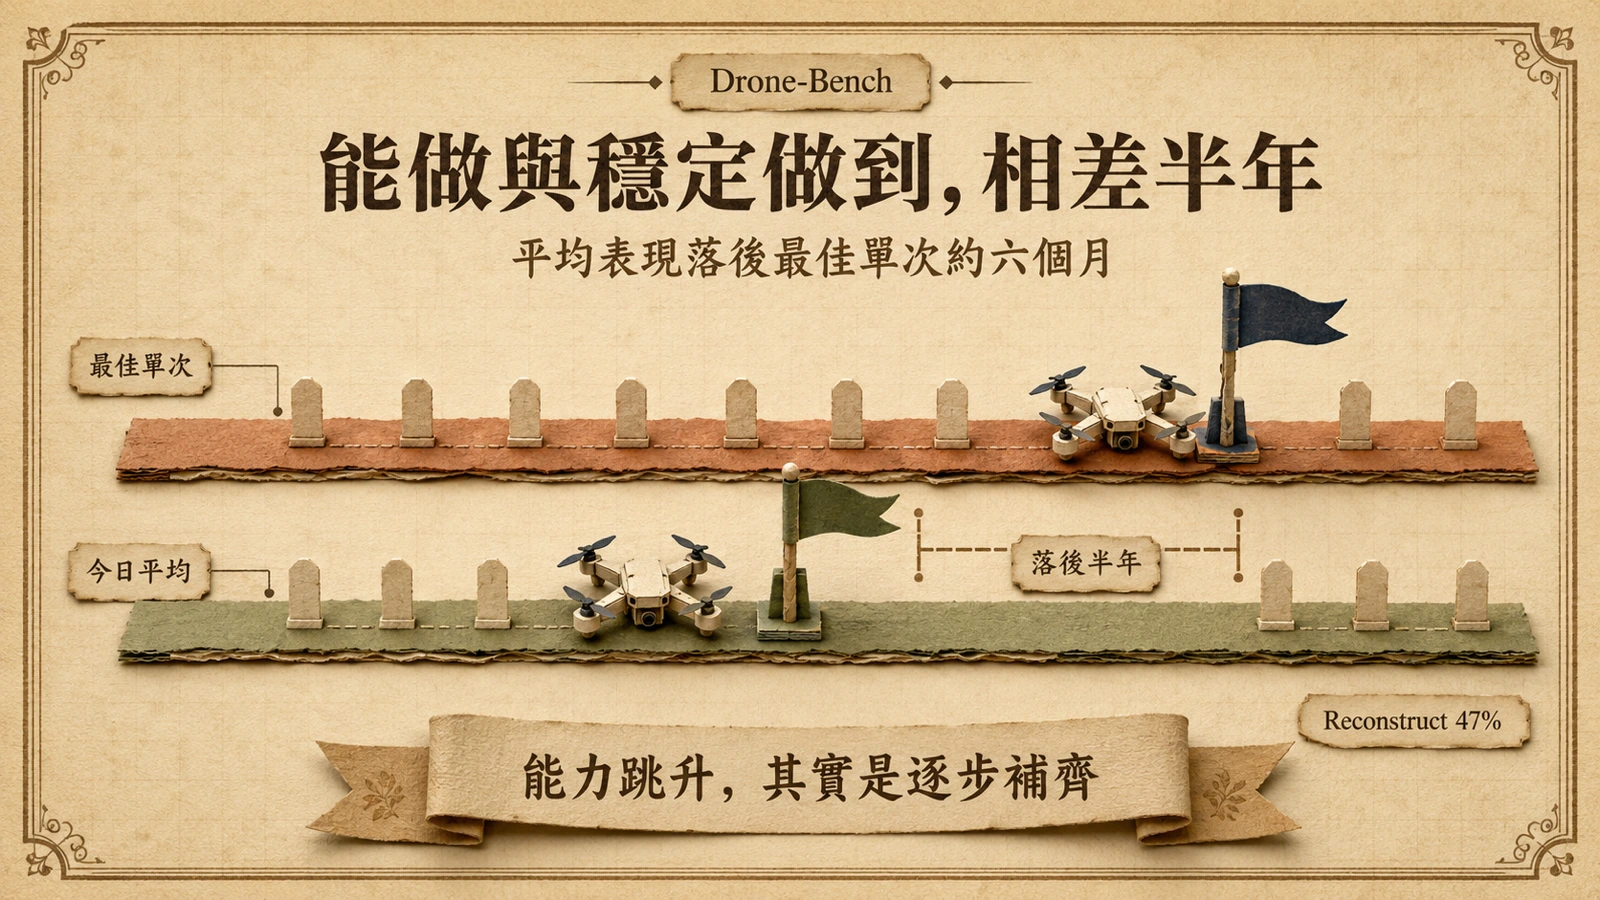
Anthropic 強調,「能不能」與「穩不穩定」是兩件事。在 10 次模擬中,模型能在四個任務的「至少一次」達到人機協作基線;但即使是目前的 Fable 5,平均也只穩定通過五項中的三項。報告指出,模型「平均表現」約比「最佳單次表現」落後六個月——Fable 5 今日的平均水準,相當於 2026 年初舊模型的單次極限。目前 Reconstruct 子任務只達基線約 47%,是唯一尚未跨越的關卡。Anthropic 認為,把評估拆解成子任務,能把看起來像「突然跳升」的能力,還原成「逐步補齊」的軌跡。
雙用途壓力:治理需跑在能力前面
Anthropic 將無人機定位為「易取得、雙用途」的硬體,可用於農業增產與救災,也可用於戰場瞄準或個人監控。報告示警,當模型跨過能力與可靠度門檻,企業會出現「把人類監督當成本而非保障」的壓力,特別在涉及物理安全與隱私的場域,效率不應是唯一考量。研究亦坦承侷限:無人機速度慢、僅測單一辦公樓層、未在戶外或人群中實測,要評估實戰能力仍須更大規模、更多元的實驗。若要比較遊戲世界中的長程、多跳探索,可對照MineExplorer 的 813 個 Minecraft 任務;從研究基準走到有人監督的軍用實機,則可續讀〈DARPA 與美國空軍的 AI F-16 VENOM 試飛〉。三者共同凸顯「單次能力」與「可被信任的持續控制」之間仍有落差。