柏克萊團隊發布 Vero:把形式驗證考題推到倉庫級
2026 年 8 月底,一篇題為《Vero: Can AI Agents Build Formally Verified Software Repositories?》的論文掛上 arXiv,編號 2608.13522。研究出自 UC Berkeley 的 sunblaze-ucb 實驗室,第一作者為 Zhe Ye,共同作者含 Hantao Lou、Yuechun Sun、Peiyang Song、Zhengxu Yan 等人,Dawn Song 也在 X 上宣布了這次釋出。論文要回答的問題就寫在標題裡:AI 智能體能不能做出「整個倉庫都通過形式化驗證」的軟體?
研究團隊在柏克萊 RDI 的部落格文章裡給出定位:Vero 是第一個要求智能體在倉庫級同時撰寫實作與證明的基準。這句話有兩個關鍵詞。其一是「倉庫級」——過去絕大多數形式驗證導向的評測,考的是單一函式或單一模組,Vero 直接把考場換成多檔案、多模組的完整專案。其二是「同時」——智能體不只要寫出能跑的程式,還要為每個 API 附上機器可檢查的形式證明,缺一邊就不算數。整個基準的程式碼與評測框架都已開源,任何人都可以重跑整場考試。
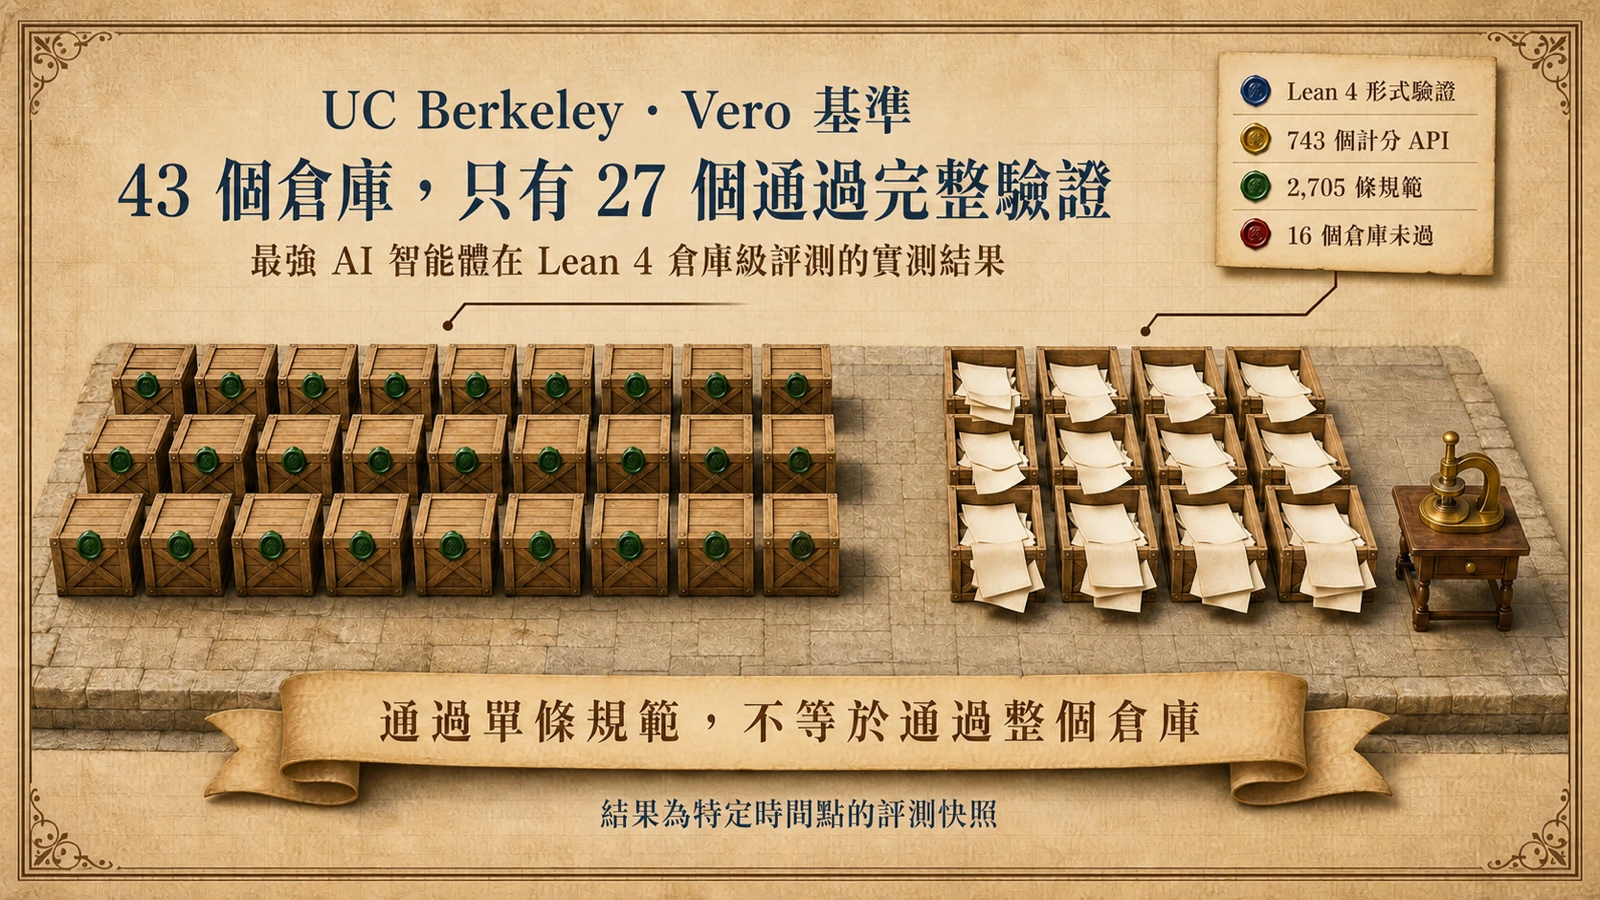
Vero 在考什麼:43 個倉庫、743 個 API、2,705 條規範
Vero 的考題不是憑空設計的。43 個實例都改編自真實世界的既有專案——來源橫跨 Python、Dafny、Verus 與 Coq 四種語言的倉庫,再移植成多模組的 Lean 4 專案。換句話說,題目背後是已經存在、有人認真寫過並維護過的程式,而不是研究員為了考倒模型新編的習題。
依論文的統計,43 個倉庫共包含 743 個計分 API 與 2,705 條形式規範,對應數以千計的驗證義務。這裡的「規範」值得展開:每一個 API 都伴隨一份用 Lean 4 寫下的形式規範,明確定義這個函式必須滿足的性質——輸入要符合什麼前置條件、輸出必須滿足什麼後置條件、邊界情形如何處理。智能體的工作,是寫出實作並附上證明,說服 Lean 的核心:這份實作在所有合法輸入下都滿足規範。
這與一般靠測試的評測有本質差異。測試再多,也只能顯示「被測到的案例沒問題」;形式證明一旦被 Lean 核心接受,保證的是性質對所有輸入成立。計分也因此有了層次:一個倉庫可以部分過關,分數看的是智能體究竟關掉了多少條規範,而不是全有全無。
兩種考法:proof-only 與 code-and-proof
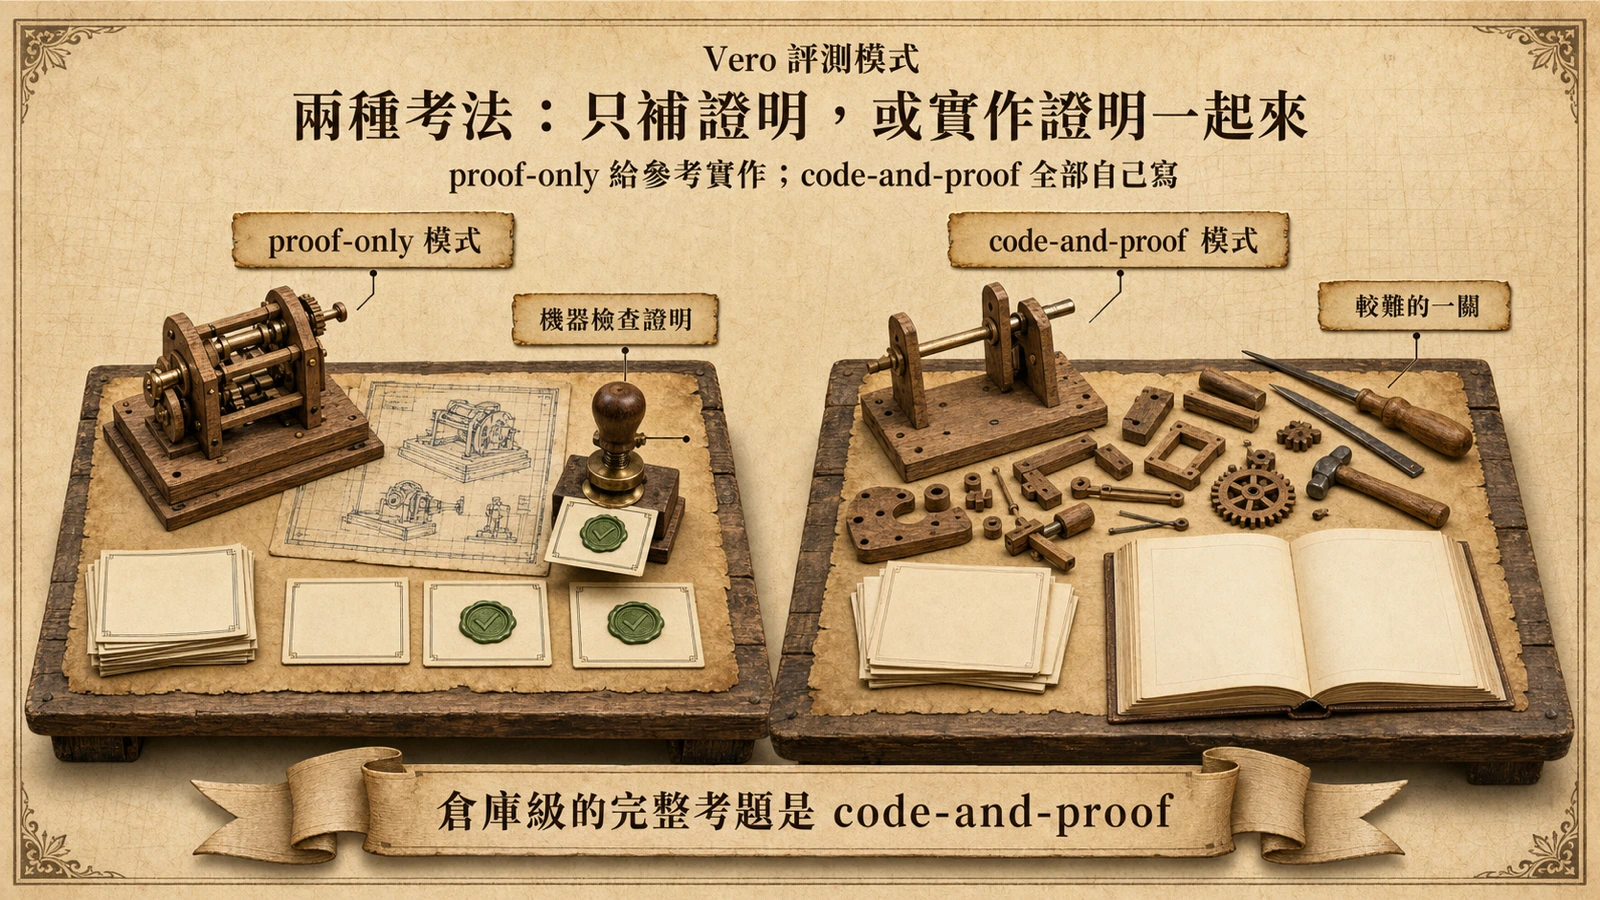
Vero 對同一批倉庫提供兩種模式。研究團隊的說明寫得直接:在 proof-only 模式裡,智能體拿到參考實作,任務是為每條規範補上機器可檢查的證明;在 code-and-proof 模式裡,智能體要自己寫出每個實作,並同時關掉所有證明義務。
兩種模式考的是不同能力。proof-only 測的是「讀懂別人的程式,並為它的正確性背書」——比較接近現實中工程師為既有程式碼補規格與證明的場景。code-and-proof 則困難得多:智能體必須從規範長出整個倉庫,實作與證明互相牽動,改動一個資料結構,依賴它的定理可能全部要重寫。論文評測也印證了難度並不對稱:同一個最強配置在 code-and-proof 模式完整解出 27 個倉庫,在 proof-only 模式反而是 25 個——為既定的參考實作補證明,未必比從規範自己寫起容易,參考實作的具體寫法可能讓證明更難對上規範。
防呆設計:智能體可以「證明題目有錯」
基準測試最怕的不是模型考不好,而是題目本身有錯。如果某條規範在數學上根本無法滿足,或參考實作其實不符合規範,那麼所有分數都是失真的。Vero 對此的解法很有形式驗證的精神:讓智能體也能舉證。倉庫文件描述了這個 audit 機制——智能體可以提交一份形式證明,主張某條給定的規範是不可滿足的,或參考程式碼本身有誤。
換句話說,「質疑題目」這個動作本身也被形式化了。一份被 Lean 接受的 audit,等於一份經機器查核的反例,而不是口頭申訴。對基準維護者來說,這把找錯題的成本從人工審查降到讓受測者自己舉證;對評測可信度來說,這讓分數更難被有瑕疵的題目污染。
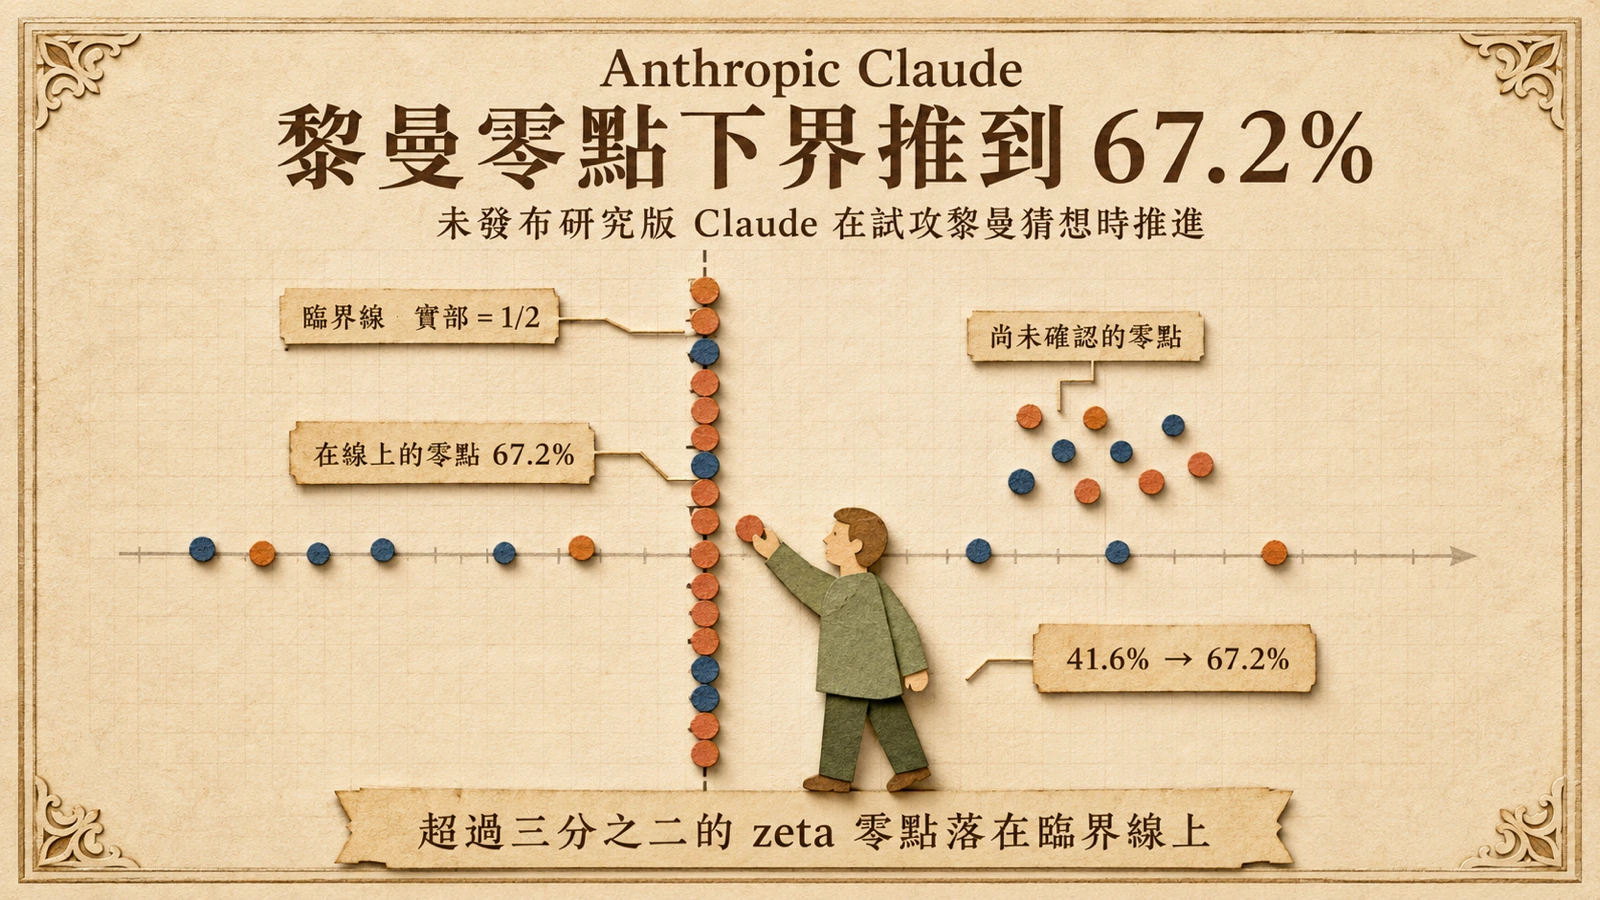
這也延續了 Lean 生態近年的角色變化:從數學圈的定理證明助手,逐漸變成 AI 產出內容的公證人。前一個引起廣泛討論的例子,是未發布研究版 Claude 把黎曼 zeta 零點下界推進到 67.2% 並以 Lean 4 形式化通過驗證;Vero 則把同樣的公證機制搬進了軟體工程。
結果:規範層近九成通過,倉庫層只剩 27/43
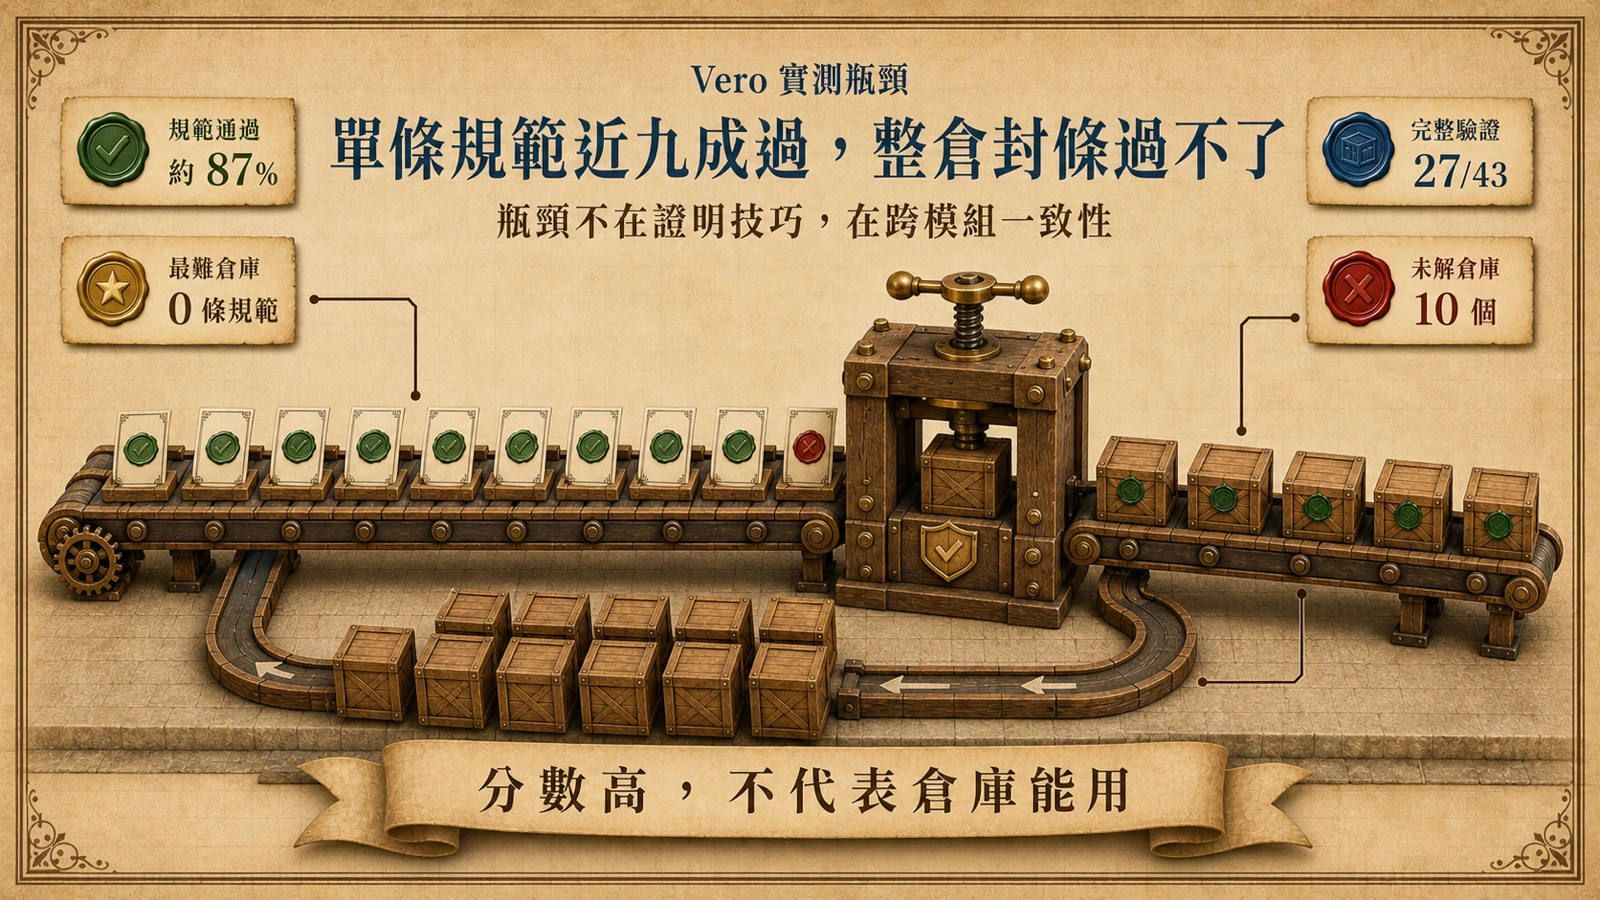
評測結果用論文摘要的一句話就能講完:最強的智能體也只能完整解出 43 個實例中的 27 個,而且「在最難的倉庫上一條規範都沒有關掉」。評測中表現最好的配置,是以 Codex 為智能體框架、推理強度開到最高的 GPT-5.5。
更有訊號意義的是兩個層次之間的落差。依論文的評測數據,表現最好的智能體在單條規範的層級通過了約 87%——將近九成;而 43 個倉庫中另有 10 個,是所有受測智能體都沒能解開的。單條規範近九成過、整倉只剩 27 個,瓶頸顯然不在「會不會寫單個證明」,而在倉庫級的一致性:跨模組的依賴要對得上、每個 API 的規範與實作要同時成立,一處矛盾就讓整個倉庫過不了最終檢查。
這個「零件都會做、組裝起來垮掉」的型態,與其他智能體評測看到的處境相互呼應——例如從市場驗證產品提煉任務的 StartupBench,最強模型也只完成約三成端到端工作流。差別在於 Vero 把「完成」的定義推到最嚴:不是看起來能跑,而是每一條性質都有機器查核的證明。
從函式級到倉庫級:與既有基準的差異
形式驗證導向的程式碼生成評測並不是新東西。同一團隊先前就推出過 Verina,以模組為單位評測程式碼、規範與證明三種生成任務;更早的 FVAPPS 則把競賽程式題庫 APPS 加上 Lean 4 定理規範。這些基準的共同限制是規模:考題多為單一函式,模組之間的依賴、整體架構的取捨,都不在考試範圍內。
Vero 補上的正是這一塊。倉庫級任務會強迫智能體處理真實軟體的核心難處——組合:某個 API 的證明可能引用另一個模組的定理,資料結構的選擇會連動影響下游所有規範的證明策略。這也是為什麼約 87% 的單條通過率換不來整倉通過:倉庫級的困難不是加法,而是乘法。
從評測方法的角度看,這個轉變還有另一層意義。函式級基準的任務邊界清楚、容易批改,但正因為題目小,模型可以靠記憶與模式匹配得分;倉庫級任務則要求智能體在長視野裡工作——先讀懂整個專案的介面與依賴、安排證明的先後順序、在自己引入的每次修改之間維持一致。這些正是「智能體」與「單次生成」最分得開的能力。把 proof-only 與 code-and-proof 分開計分因此有了診斷價值:兩個分數一起看,才分得出瓶頸究竟在證明能力,還是在工程規劃。
對開發者與高保證軟體的意義
對開發者,Vero 的價值在於給了一條可比較、可重現的量尺。整個基準與評測框架開源在 GitHub,倉庫的說明文件逐檔走過架構,一條指令(例如 vero run benchmark=bankledger agent=claude mode=proof)就能把某個倉庫從頭到尾跑一遍;排行榜網站則公開各智能體的成績。團隊可以把自家的智能體流程放上同一把尺,追蹤每次模型或流程改版帶來的實際變化。
對產業,這條量尺量的是一個越來越重要的問題:AI 寫的程式,能不能被「證明」是對的。研究團隊在部落格裡講得直白——倉庫級的驗證程式碼生成,提供了比測試更強的保證,特別適用於高保證需求的場景。密碼學實作、關鍵基礎設施、金融結算這類「錯一次代價太大」的系統,正是形式驗證的傳統腹地;如果智能體能在這類倉庫上穩定拿高分,「AI 寫、機器證、人審」的流程就有了實際的落點。
限制與值得追蹤的後續
幾個界限必須畫清楚。第一,43 個倉庫的樣本規模不大,單一實例的成敗就會讓分數明顯移動,27/43 該讀成量級訊號,而不是精確排名。第二,題目從 Python、Dafny、Verus、Coq 移植成 Lean 4,移植過程中的篩選與改寫難免帶入偏誤,「真實世界的倉庫」與「真實世界的 Lean 倉庫」仍是兩回事。第三,評測只涵蓋 Lean 4 一種證明系統,對 Dafny、Verus 等業界驗證語言上的表現不能直接類推。
第四,前沿模型迭代很快,27/43 是特定時間點的快照;這類基準真正的用處是長期追蹤落差何時收斂。值得觀察的指標有三:未解的 10 個倉庫何時首次被解開、規範層與倉庫層的通過率差距是否縮小,以及 audit 機制在社群重現中被用來抓出多少題目瑕疵。三者任一出現變化,都值得回來重看這份基準。