開源三件套:框架、資料集、模型一次釋出
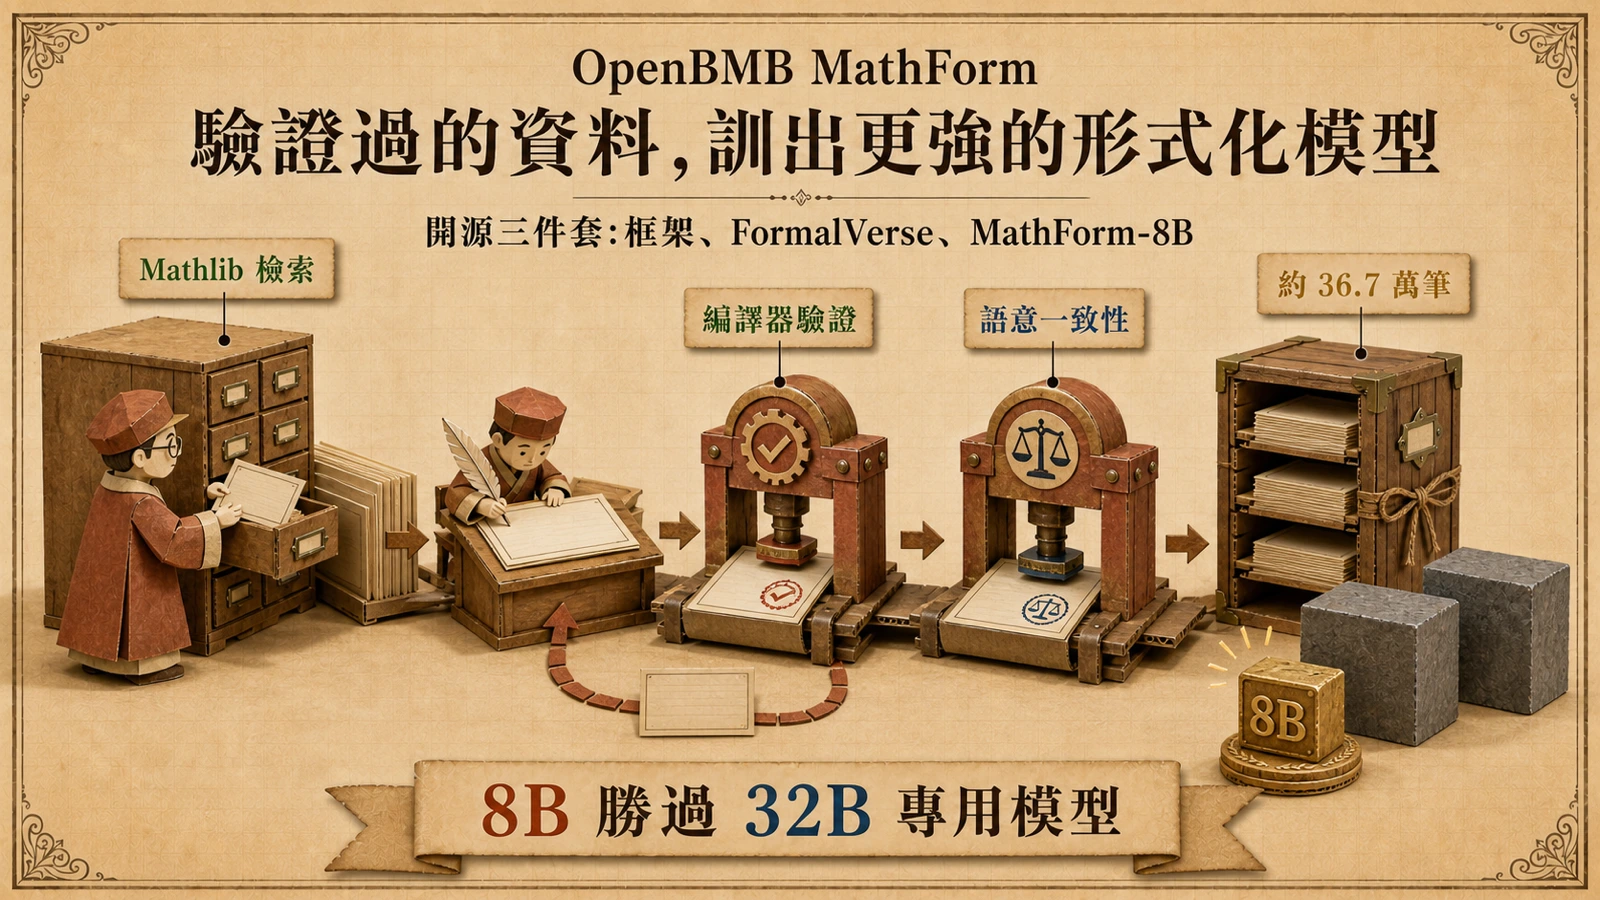
8 月 17 日,開源組織 OpenBMB(長期獲面壁智能支持、MinicPM 系列的維護社群)在 GitHub 釋出 MathForm,一次交出三件東西:一個自動形式化框架、一個名為 FormalVerse 的 Lean 4 資料集(約 36.7 萬筆已驗證範例),以及用它訓練的 MathForm-8B 模型,全部採 Apache 2.0 授權。配套的研究論文同步發布於 arXiv(編號 2608.14221,8 月 14 日提交,25 頁)。
這不是又一篇「AI 逼近數學能力」的展示,而是一套可以被任何人重跑的資料生產管線:輸入是自然語言寫的數學陳述,輸出是通過機器驗證的 Lean 4 形式化範例。論文的核心主張也相當具體——用這套管線造出來的資料訓緫一個 8B 模型,在六個基準的平均 Pass@8 達到 88.06%(語法檢查)與 72.37%(語意一致性檢查),勝過多個 32B 的專用形式化模型。
什麼是自動形式化:把定理翻成機器可驗證的 Lean 4
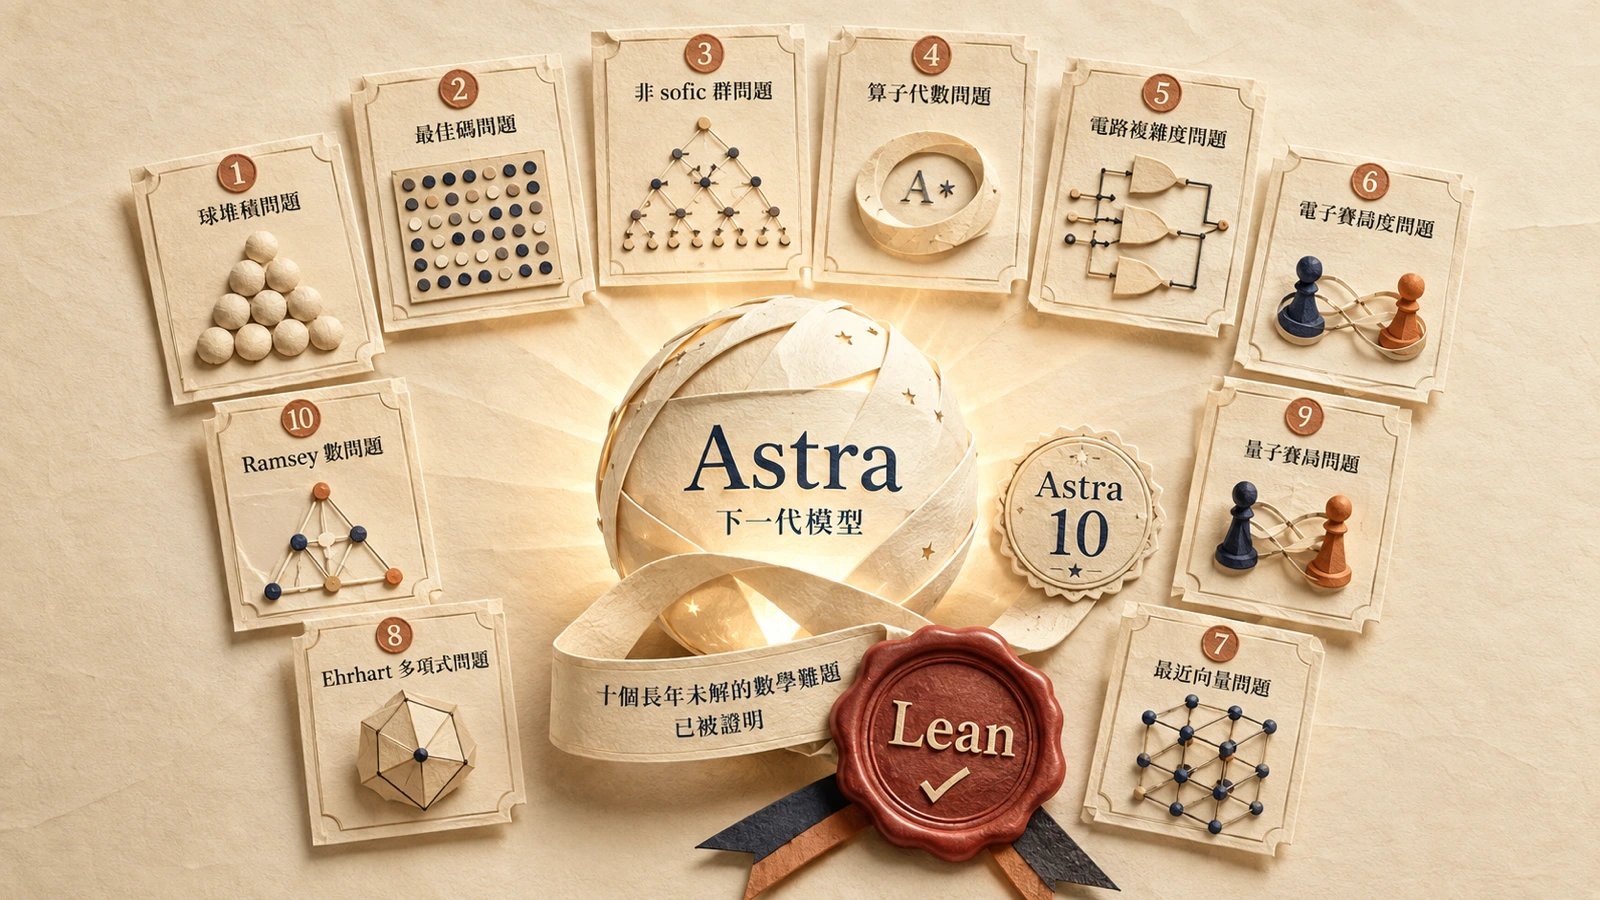
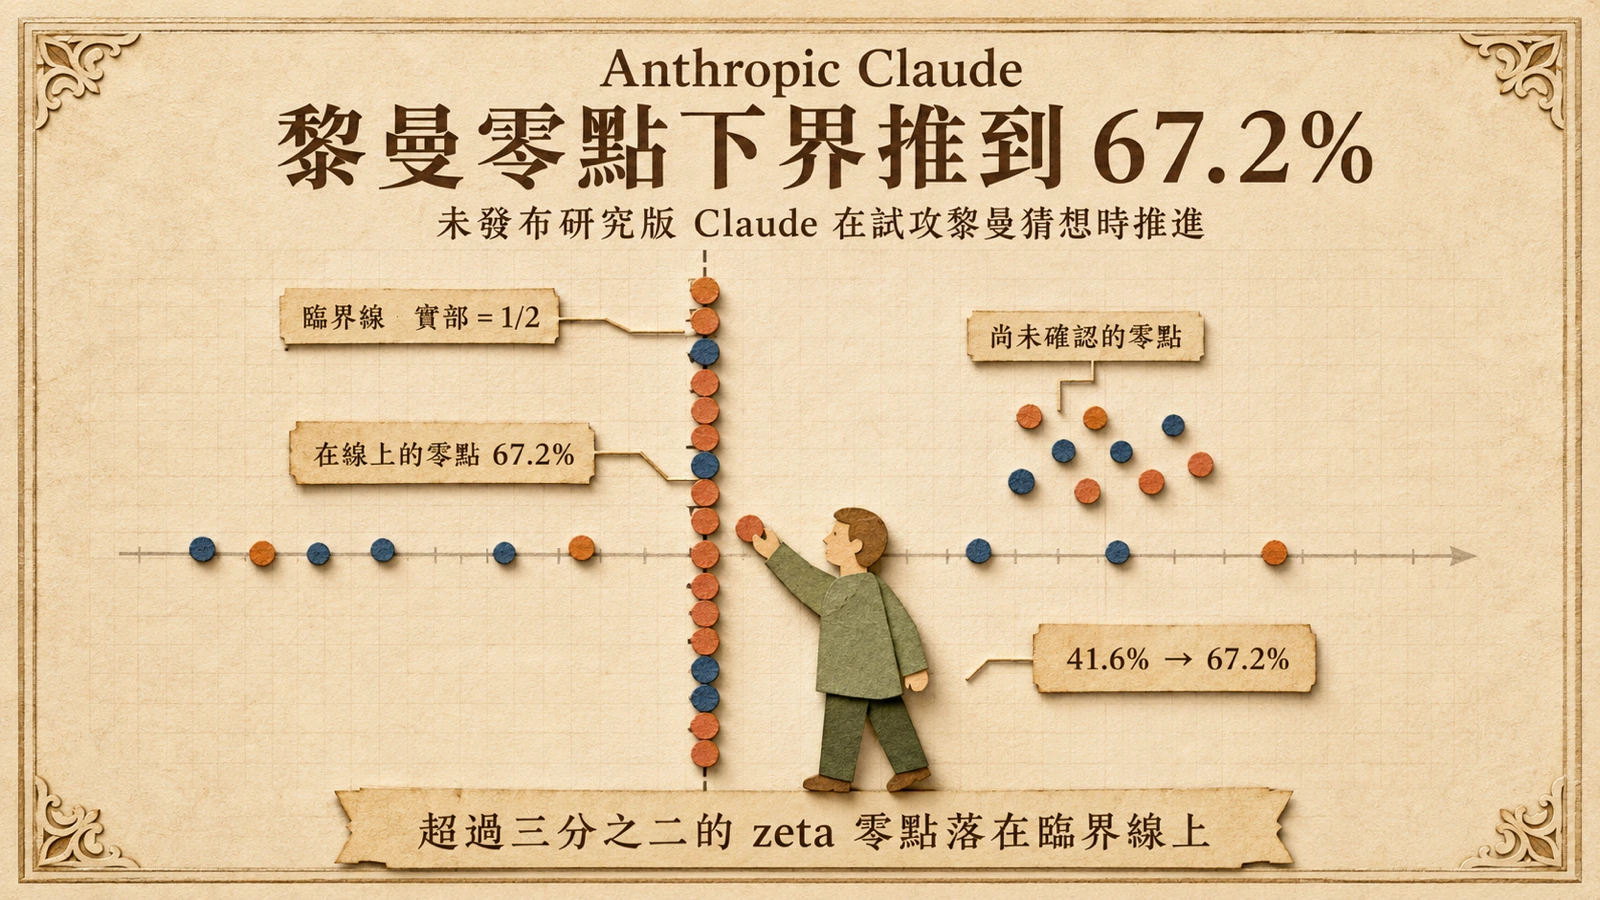
自動形式化(autoformalization)的任務,是把人類用自然語言寫的數學命題,翻譯成形式語言的陳述式——這裡是 Lean 4。翻成形式語言的價值在於可驗證:每一個步驟都可以被機器檢查,不再是「模型說它對」。這條路線近半年明顯升溫:OpenAI 的 Astra 曾以十道數學題評測模型在 Lean 中的形式化與證明能力,而 Anthropic 那篇把黎曼 zeta 零點下界推進到 67.2% 的研究,最後也是以 Lean 4 形式化通過驗證收尾——形式化正在從數學界的專業工具,變成 AI 數學結果的信任基礎設施。
但論文開頭就點出翻譯不夠:忠實的形式化要求模型把數學概念映射到 Mathlib 這類形式函式庫複雜的型別與定義階層,同時確保生成的陳述式保有原命題的意義。既有的資料建構方法多依賴模型的參數記憶去猜函式庫裡有什麼,而且通常是「單次生成再過濾」——生成了、編譯過了就收,編譯不過就丟,缺乏回饋修正的機制。
MathForm 的方法:先生產前先檢索,再用驗證迴圈修
MathForm 對這兩個弱點各給了一個設計。第一,生成前先檢索:檢索規劃器先從 Mathlib 撈出相關定義與既有形式化,帶著這些線索才開始生成——模型不必憑記憶猜函式庫內容。第二,生成後進入驗證引導的迭代修正:生成的陳述式交給編譯器,拿回診斷訊息,再交給語意一致性評估拿回回饋,據此反覆修改,直到通過。
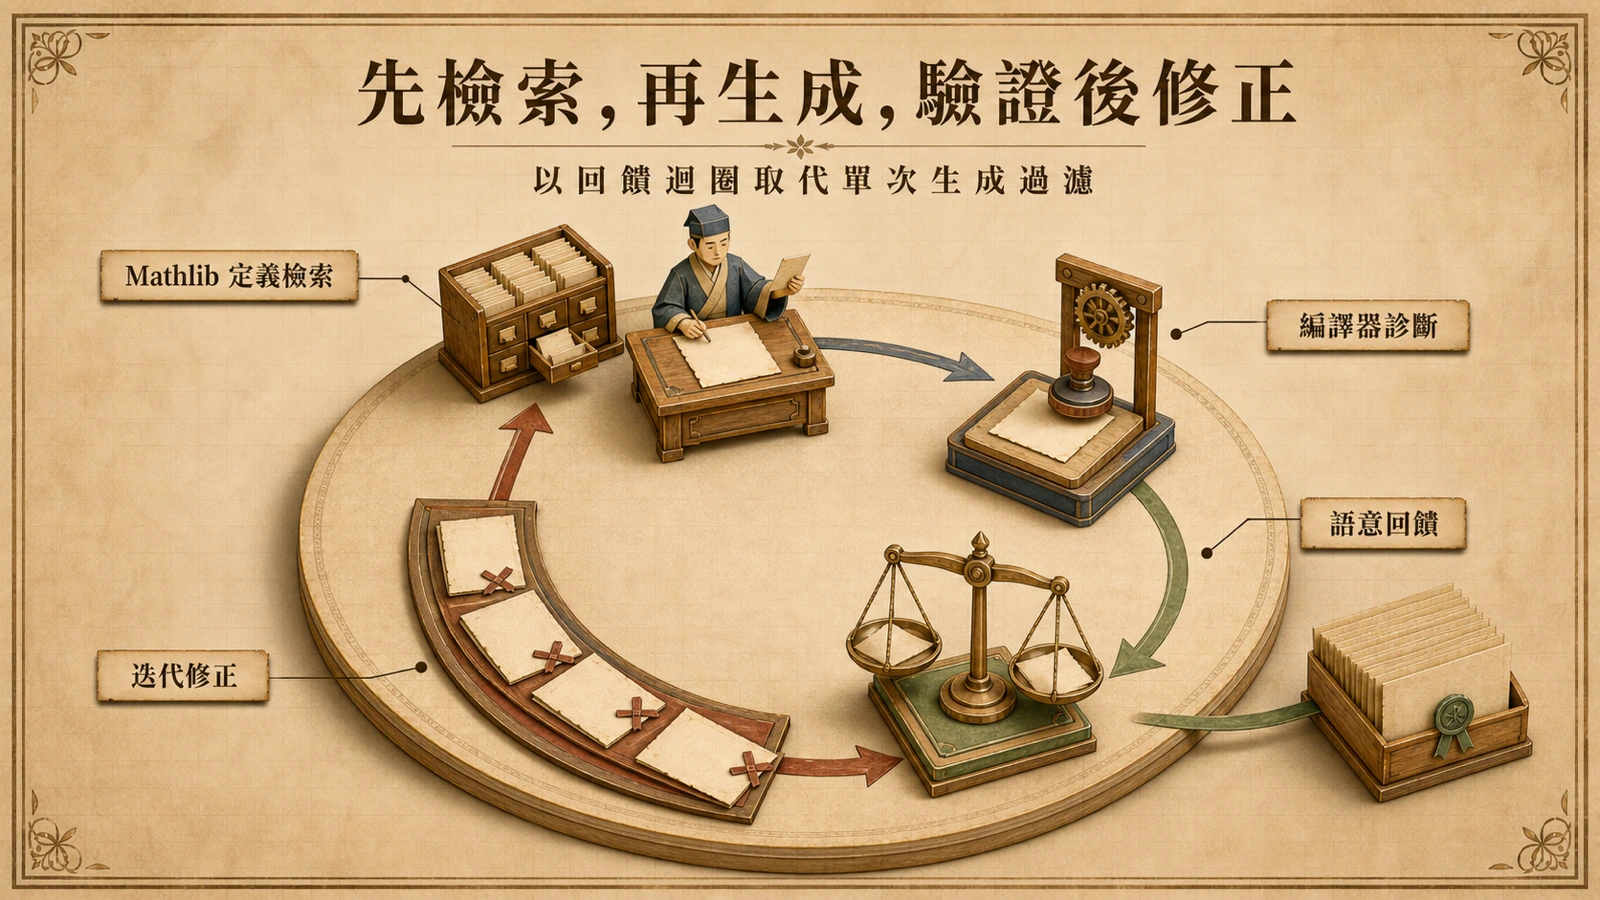
整條管線的工程基礎也一併開源:編譯檢查使用 Kimina Lean Server,檢索使用 Lean Explore,實驗環境是 Lean 4.21.0。repo 提供從 JSONL 輸入到 success/failed 輸出的完整腳本,評測端附帶 FormalMATH-Lite、ProverBench、CombiBench、FATE-M/H/X 六個基準的評測流程。
FormalVerse:36.7 萬筆驗證過的範例怎麼來
資料集的原料是七個開放題庫的非正式題目:Lean-Workbook、NuminaMath、DeepMath、DeepTheorem、AceReason-Math、OpenR1-Math、Principia-Collection。這些自然語言題目經過上述管線處理後,得到的 FormalVerse 包含約 36.7 萬筆 Lean 4 範例,橫跨多個數學領域與來源。
「已驗證」在這裡有明確定義:每筆範例都通過 Lean 編譯檢查,且通過語意一致性評估。換句話說,驗證是機器做的——編譯器負責語法與型別正確,評審模型負責「意思沒有走樣」。這不是數學家逐條人工確認,但比起單純「編譯通過就收」的資料集,多了語意這道檢查;比起人工標註,則可以規模化。
88.06% 與 72.37%:兩種 Pass@8 在量什麼
結果數字要分兩把尺讀。語法檢查(Syntax Check)量的是生成的 Lean 陳述式能否通過編譯;語意一致性檢查(Consistency Check)進一步要求陳述式保有原命題的意義——後者才是形式化的真考題。據論文摘要,MathForm-8B 在六個基準的平均 Pass@8 分別為 88.06%(SC)與 72.37%(CC),勝過多個 32B 專用形式化模型;在最難的 FATE-H 與 FATE-X 子集上,CC 通過率為 63% 與 37%,均超越最強專用基線。
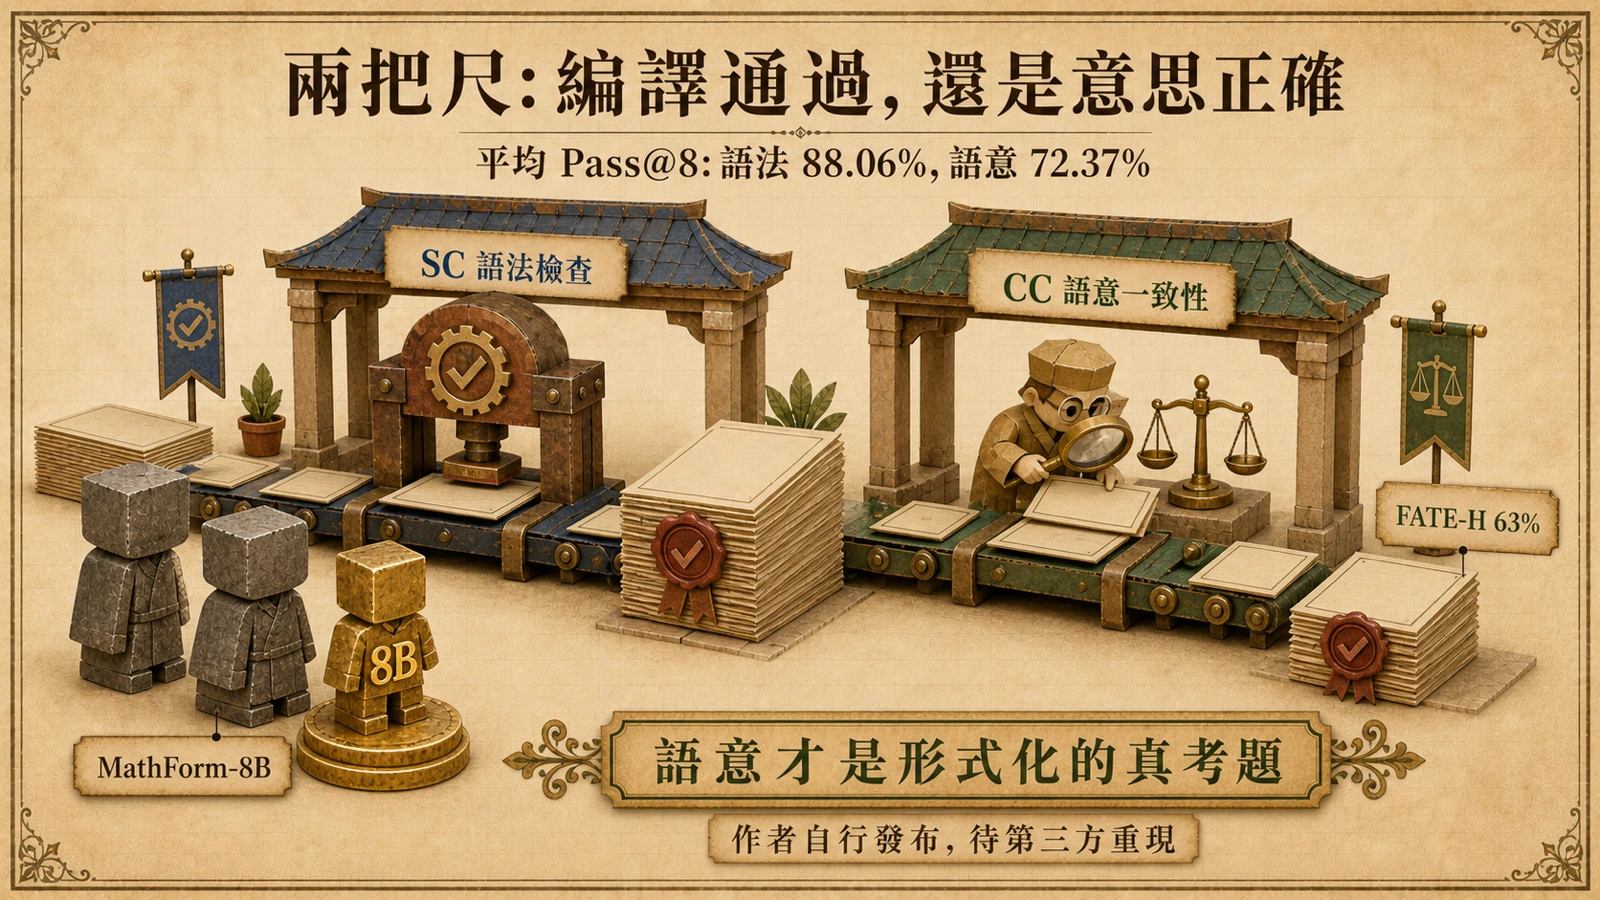
兩個讀數必須的保留:第一,這是宏觀平均,而且比較對象限於「專用形式化模型」這個類別,不是所有大模型;第二,數字由作者自行發布,基準與評測腳本雖已開源,第三方重現還需要時間。88.06% 與 72.37% 之間的落差本身也值得注意——約十六個百分點的差距,正是「編譯得動」與「意思正確」之間的距離,也是這個領域真正的難度所在。
為什麼驗證過的資料是重點
MathForm-8B 的訓練分兩階段:先監督微調,再用強化學習,而 RL 的獎勵訊號正是 Lean 編譯與語意一致性回饋——模型在訓練中拿到的不是人類打的分數,而是機器可驗證的訊號。這呼應了近期 AI 數學研究的共同轉向:當模型夠大之後,瓶頸往往不是模型,而是可信賴的訓練資料。形式化資料生產一旦管線化,「驗證」就從事后審查變成資料生成的一部分。
這也是開源三件套比單發一個模型更有分量的原因:模型會被下一版取代,但「先生產前先檢索、生成後驗證修正」的資料配方,以及一個任何人可以擴充的驗證資料集,是可以累積的公共財。對 Lean 生態而言,36.7 萬筆橫跨多領域的驗證範例,直接補上了過去最缺的原料。
誰該現在用:研究、教學與資料工程
三種讀者的切入點不同。做 AI 數學或形式化方法的研究者,最直接——FormalVerse 與 MathForm-8B 都可下載,六基準評測腳本現成,平均 Pass@8 的比較基線明確。教研單位若在教 Lean 或形式驗證,這批驗證過的範例本身就是現成的教材庫。資料工程團隊則可以把它當參考架構:任何「生成—驗證—修正」的資料管線(不限數學)都能套用同樣的骨架——檢索先於生成、回饋用於迭代,而不是單次過濾。
需要的門檻要先說清楚:直接用資料集與模型,幾乎零門檻;要重跑完整管線,得自建 Kimina Lean Server 與 Lean Explore,並固定 Lean 4.21.0 環境。後續值得追蹤的指標是第三方重現與社群擴充——FATE-H 的 63% 與 FATE-X 的 37% 說明最難的題目仍有大片空白,而空白正是這個領域下一階段的題目。