Claude 十一天完成費馬大定理首個機器檢查證明
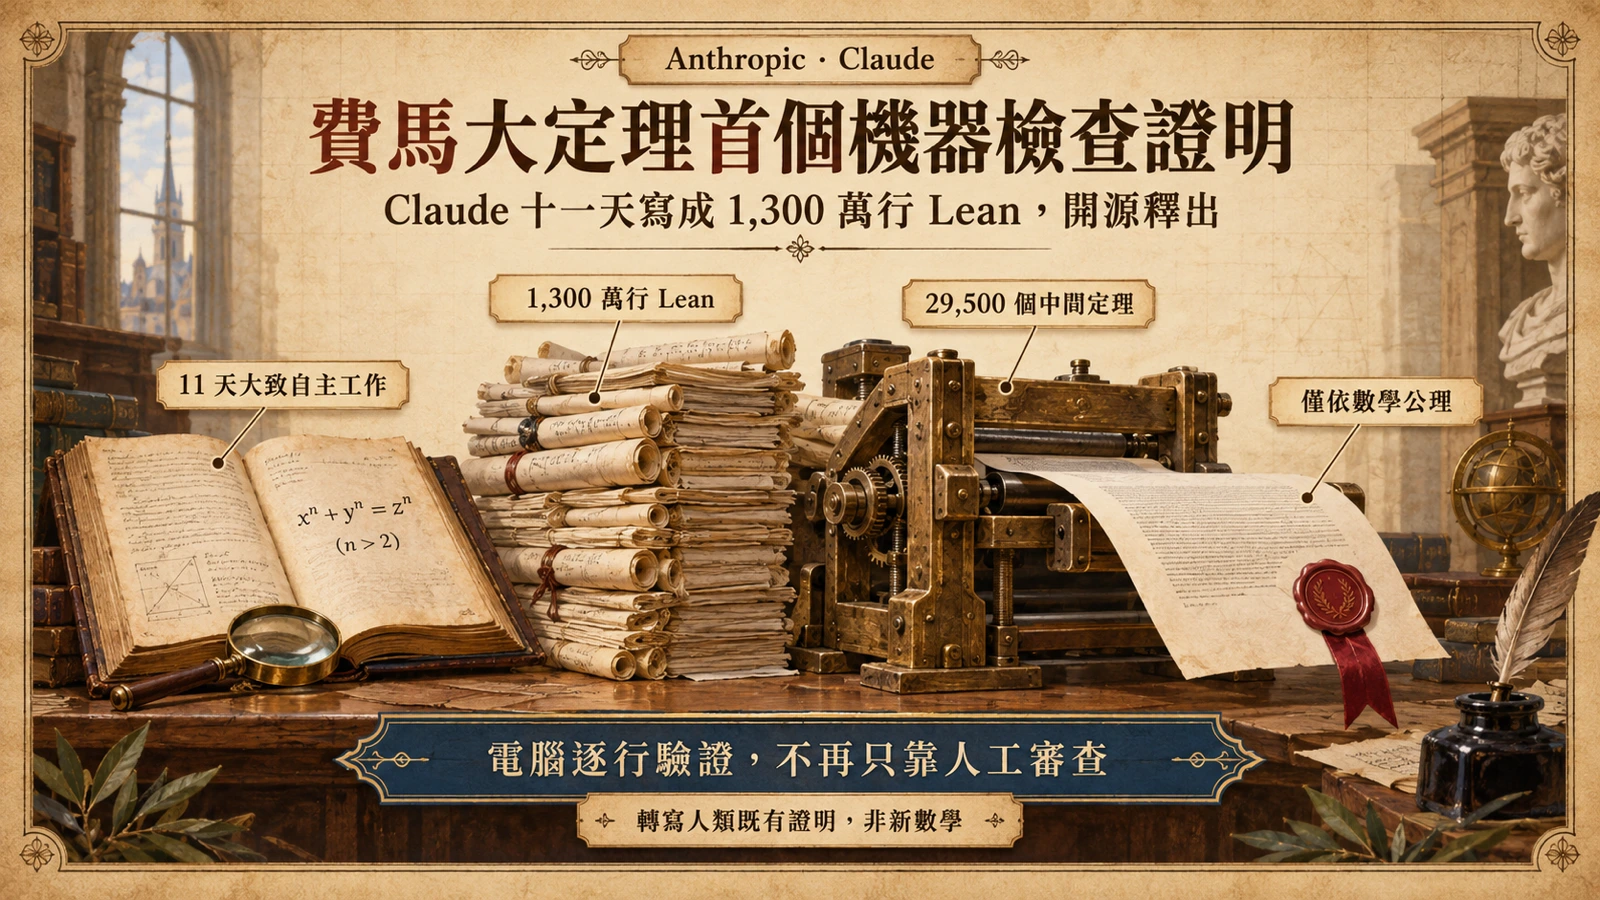
9 月 4 日,Anthropic 在研究公告中公開一項數學與 AI 交叉領域的里程碑:Claude 完成了費馬大定理(Fermat’s Last Theorem)史上第一個端到端、可由電腦完整檢查的證明。這份證明以 Lean 語言寫成,Claude 在 11 天內大致自主地工作,寫下約 1,300 萬行 Lean 程式碼、證明 29,500 個中間定理。Anthropic 形容這是一個極度耗費 token 的計畫,也是迄今建構過規模最大的 Lean 證明。
證明原始碼已開源於 GitHub:儲存庫 anthropics/fermats-last-theorem 收錄完整證明,建立在 Lean 4.33.1 與 Mathlib v4.33.0(以 commit 鎖定版本)之上,任何人都能下載、重跑檢查。整個計畫的發起者是 Anthropic 研究員 Tianyi Peng(彭天翼)——他在哥倫比亞大學的團隊專門打造 AI 形式化工具。他最初只是想測試 Claude 能在費馬大定理的形式化上推進多遠,結果遠超預期。
三百五十八年老問題,與一百二十九頁的人類證明
費馬大定理的內容短到可以寫在書頁邊:對任何大於 2 的整數 n,不存在正整數 a、b、c 滿足 aⁿ + bⁿ = cⁿ。約 1637 年,法國數學家費馬在自己那本丟番圖(Diophantus)《算術》的頁邊寫下這個主張,還留下一句「我有一個絕妙的證明,可惜頁邊太窄寫不下」。此後三個半世紀,它成為數學史上最著名的未解問題之一,無數人嘗試、無數嘗試失敗。
真正的證明直到 1995 年才由 Andrew Wiles 完成:129 頁的論文,發表前還經歷過一次審查中發現的關鍵漏洞,Wiles 花了約一年與 Richard Taylor 合作修補;即使如此,同行驗證仍耗時數個月。十年之後,荷蘭計算機科學家 Jan Bergstra 提出把 Wiles 的證明「形式化」——將數學推理轉換成電腦能自動檢查的形式。又過了約二十年,2024 年,倫敦帝國理工學院的 Kevin Buzzard 啟動一個多年的開源社群計畫,要用 Lean 證明助理完成這件事,外界普遍預期需要數年工時。
形式化在做什麼:把「給人看的證明」變成「給機器查的程式」
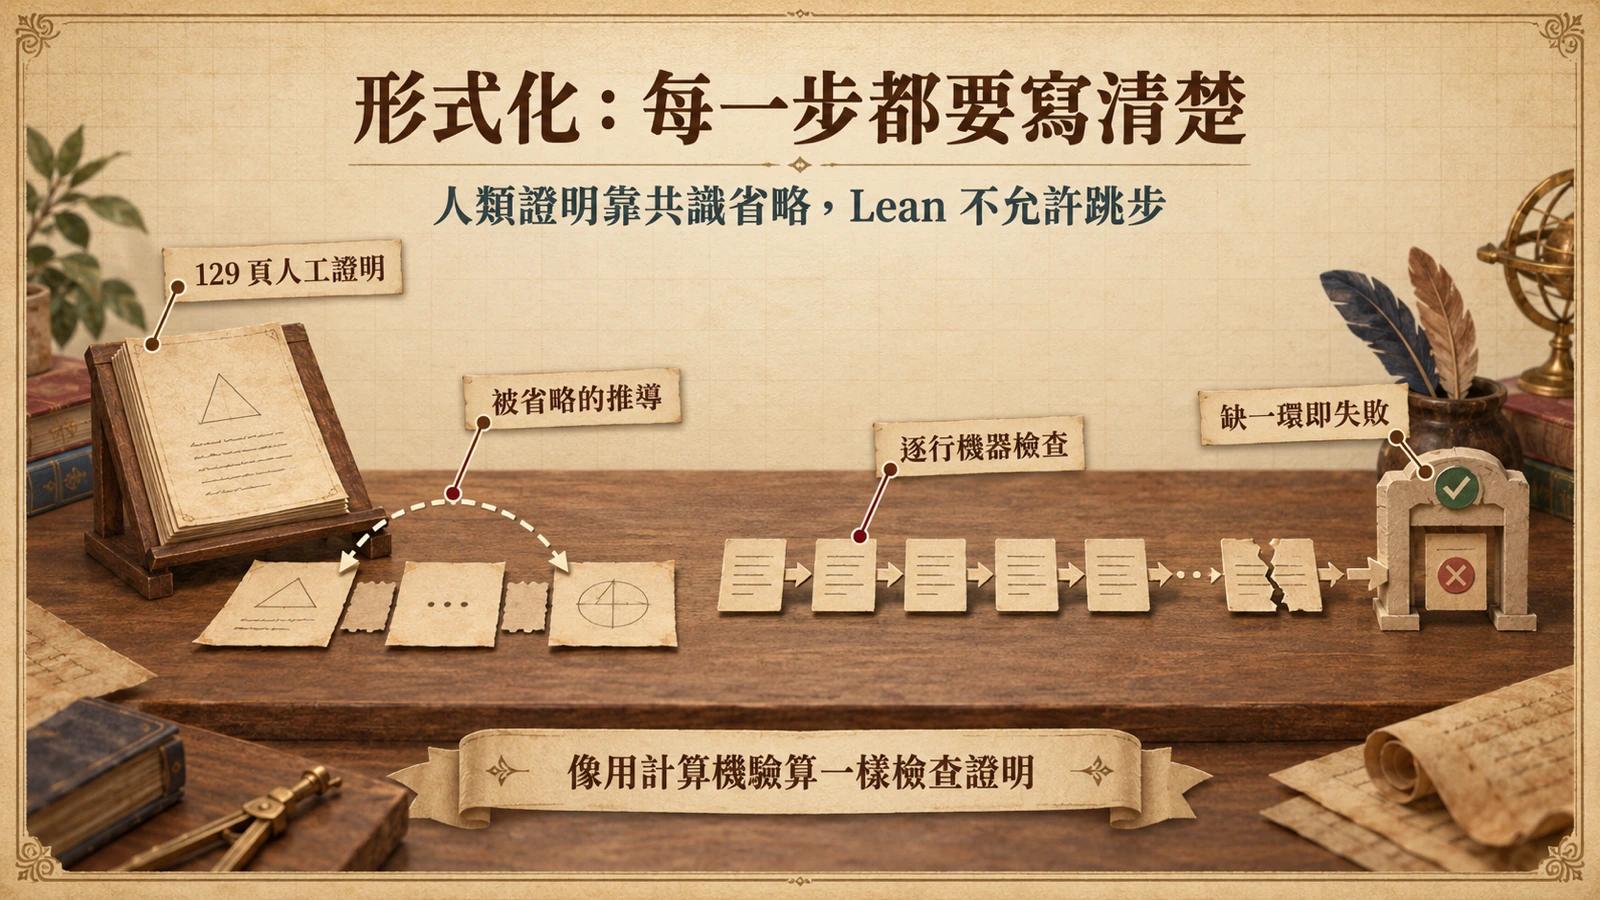
傳統數學論文是寫給同行看的:大量「顯而易見」的推導被省略,一句敘述背後可能掛著數十個定義、引理,以及幾百年累積的既有結果,讀者靠專業共識補齊缺口。Lean 這類證明助理沒有常識可用——每一個定義、每一次邏輯轉換、每一個中間結論都必須明確寫出,推理鏈上只要有一環接不起來,證明就不會被核心接受。
形式化(formalization)就是把人類的證明轉寫成這種機器可逐行檢查的程式。Anthropic 在公告裡把這次工作的定位講得很清楚:與近期在黎曼猜想方向、產生新數學的 AI 工作不同,這次的新穎之處在於「驗證」——像用計算機驗算一道計算那樣,檢查一個數學證明。這也解釋了 1,300 萬行的由來:129 頁人類證明中所有被省略的環節,都必須攤開成一個個明確的定理與推導。
十一天怎麼可能:Prove2Me 平台與數十個並行的 Claude
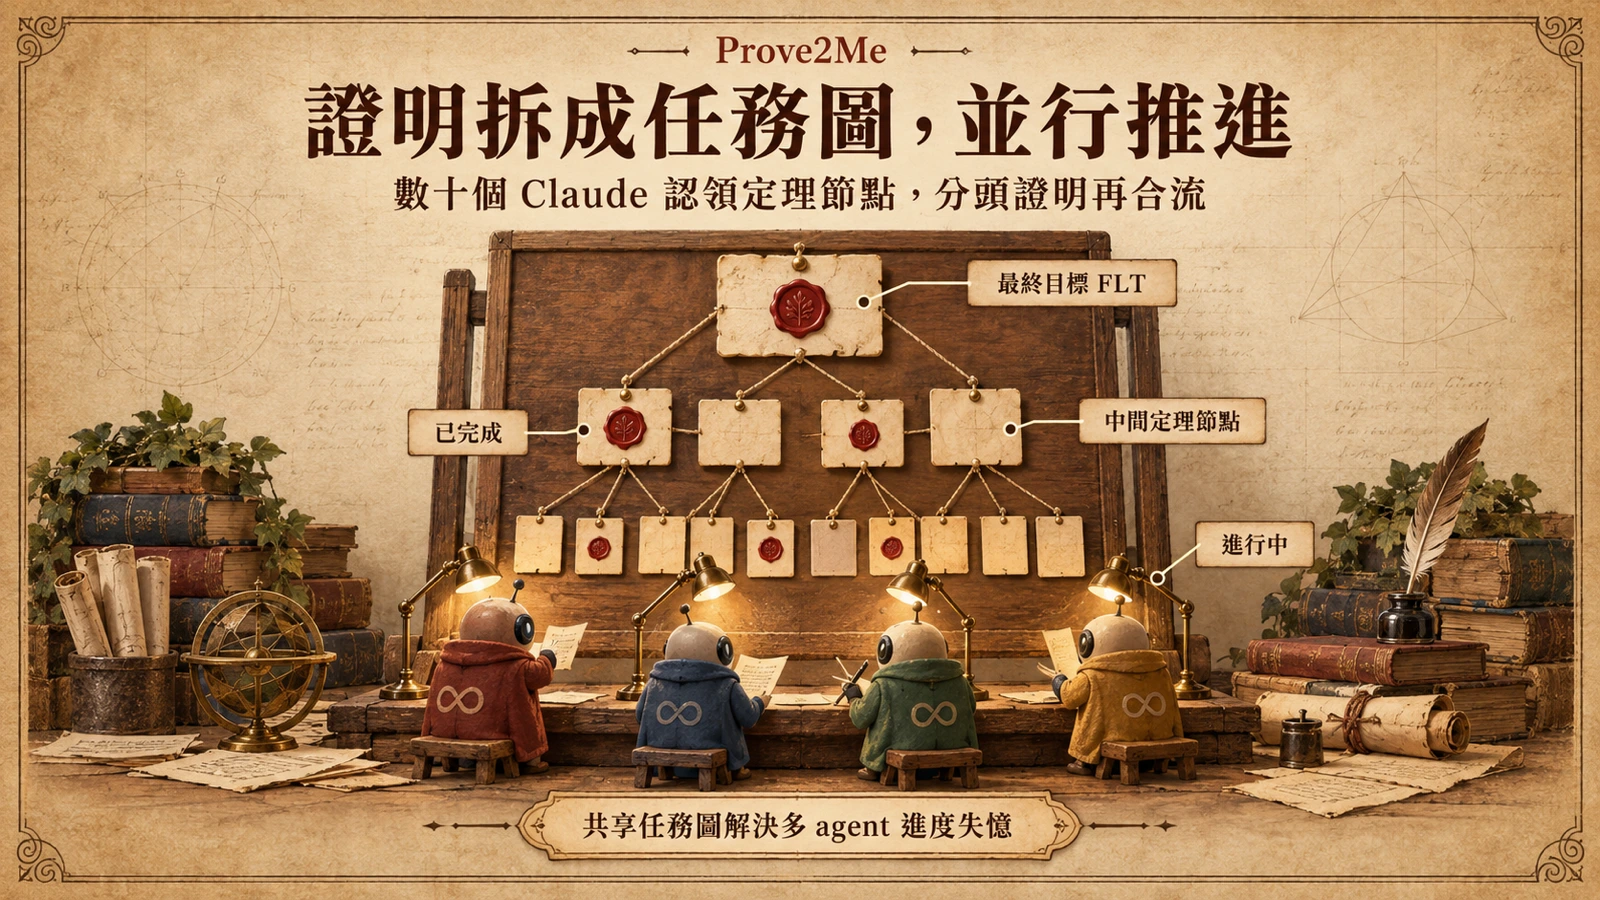
這不是一個 Claude 從頭到尾連續輸出 1,300 萬行。Anthropic 在公告中說明,這輪工作跑在 Prove2Me 與一個以 Claude Code 為基礎的多 agent harness 上;Prove2Me 本身是彭天翼(Tianyi Peng)為共同作者之一的開放形式化協作平台,其研究論文把這套設計的重點放在讓多個 agent 在大規模協作中,能直接在彼此已完成的工作上繼續建造。它把龐大的證明拆解成一張有向無環的定理任務圖:最頂層是最終要證明的費馬大定理,往下不斷拆成規模遞減的中間定理;數十個 Claude 並行認領節點,有的定義數學概念、有的證明底層引理、有的拿已完成的結果往上推進,並且能搜尋、重複使用彼此已證好的結論。
過程並非一開始就順利。多個 agent 直接協作時,很快便忘記整個工程進行到哪裡——一個 agent 不知道其他 agent 已經證明了什麼,互相跟不上進度。把共享的任務圖補上、讓每個定理的狀態變成所有人可查之後,系統才真正跑起來。同一份公告也交代了這輪的帳面規模:一組 agent 在略少於兩週的時間裡跑完全程,消耗約 60 億個輸出 token。
和黎曼猜想那次不同:這次的新東西是驗證
Anthropic 自己把這次結果與 8 月的黎曼 zeta 零點下界研究明確區隔:那次 AI 產生的是新的數學內容,這次產生的是對既有證明的完整檢查。但兩者共享同一個趨勢——AI 數學結果的信任基礎設施正在成形,從 OpenBMB 開源的 MathForm 自動形式化資料管線,到 Lean 生態本身的成熟,形式化正從數學圈的專業工具,變成 AI 產出的數學能不能被相信的驗證層。
Lean 官方網站也為費馬大定理形式化設了專頁,稱它是推進「可形式驗證邊界」的大規模挑戰。看過結果的 Kevin Buzzard 給出高度評價:這項成就在數學公理之外不做任何假設地證明了費馬大定理,而且 AI 自動形式化的產物「已穩固到可以讓人在其上繼續建造」——對一個發起多年期人類形式化計畫的人來說,這個說法本身就很有分量。
對數學界與 AI 研究的實際意義
對數學界,最直接的意義在審查負擔。一個複雜證明的同行審查可能花上數月甚至數年;當證明可以被電腦逐行檢查,驗證就從「信任一群專家的集體閱讀」變成「跑一次可重現的檢查」。Anthropic 對此的期待講得明白:希望隨著 AI 產出的證明越來越多,數學知識體系變得更容易、而不是更難被信任。
對 AI 研究,這是目前為止最強的長時程 agent 工程證據之一:協調數十個並行實例、連續工作十一天、產出上千萬行程式碼,最終還能通過邏輯上零跳步的機器檢查。它同時凸顯了平台層的關鍵——模型能力之外,任務怎麼拆解、進度怎麼共享,決定了這類工程能不能成立;第一次嘗試的失敗與導入共享任務圖後的成功,把這一點示範得非常清楚。
對開發者與研究者,下一步很具體:證明就在 GitHub 上,可以下載、重跑、拆解研究;Lean 與 Mathlib 都是開放資源,這條工具鏈的大門是敞開的。
限制與後續值得追蹤的指標
第一,這不是新的數學。Claude 沒有發現新的證明路線,它完成的是把 Wiles 的既有證明完整轉寫成機器可查的形式;價值在驗證,不在發現。第二,1,300 萬行對上 129 頁,冗餘度是公開的疑問——形式化證明能否在後續被大幅壓縮、出現更優雅的路徑,是值得追蹤的指標。第三,單點突破不等於通用數學能力:這是一個目標明確、有既成證明可依循的工程成就,與開放式的數學研究仍是兩回事。第四,人類路線沒有結束——Buzzard 在帝國理工的多年期計畫仍在進行;社群會如何看待、採用或精簡 Claude 的產出,兩條路線會合流還是並行,會是接下來最值得看的發展。