把「搜更久」換成「先驗證再補證」
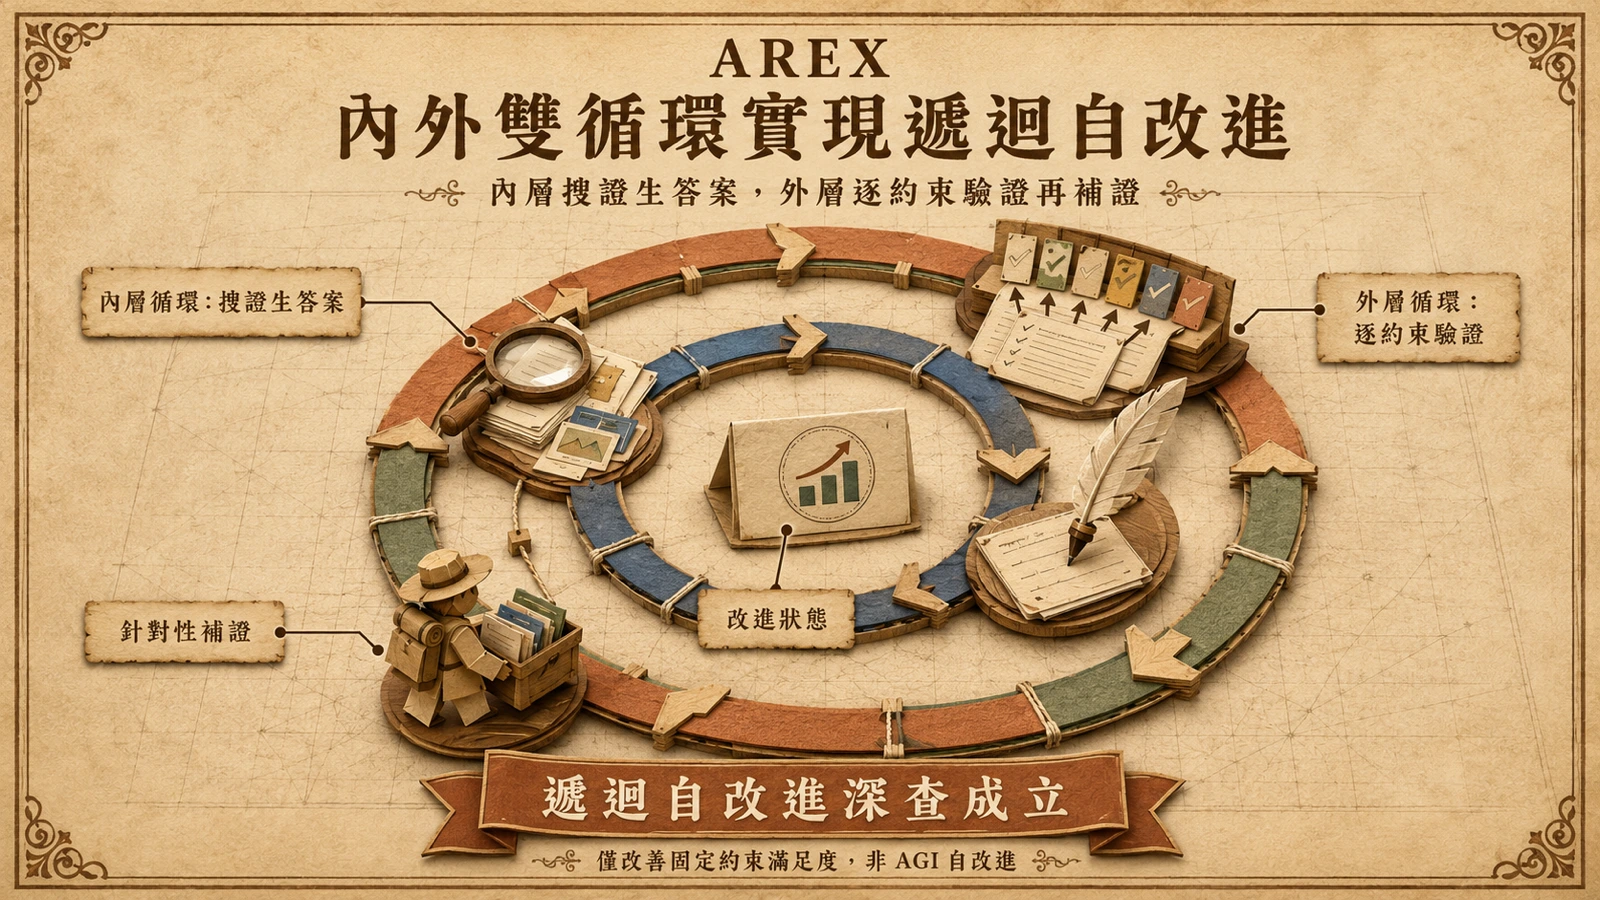
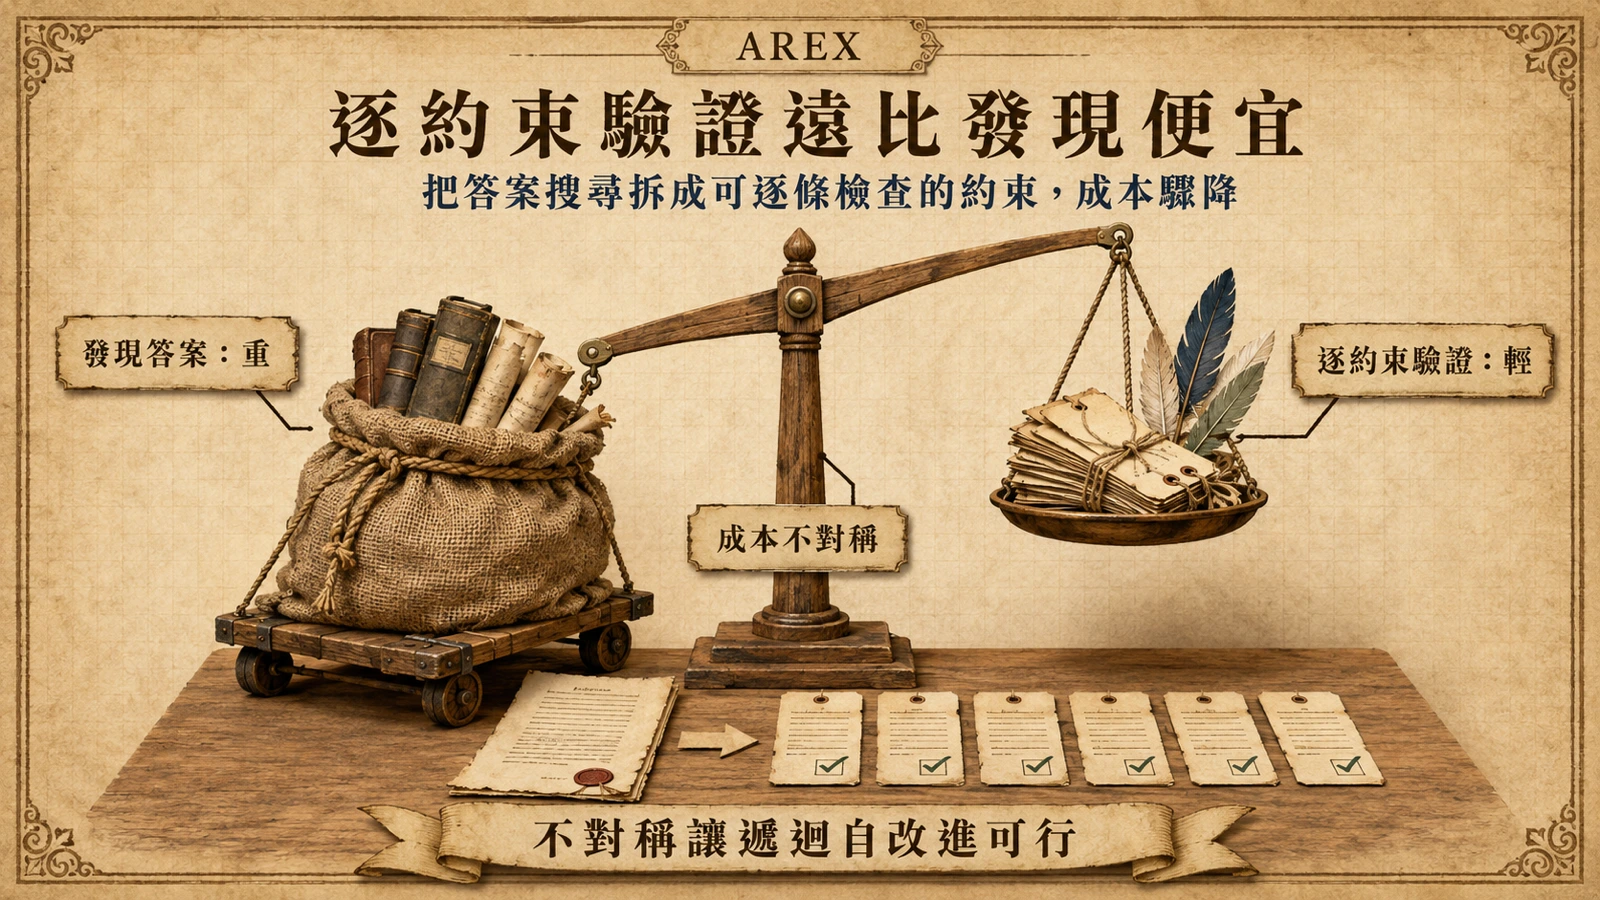
深度研究的本質,是要找到一個能同時滿足多重約束的答案。論文作者群(含 BAAI、人民大學等機構的研究者)觀察到一個不對稱性:發現答案很貴,但驗證一個候選答案往往可拆成逐條約束的檢查,相對便宜。AREX 據此把方向從「拉長搜尋時間」轉向「遞迴自改進」(Recursively Self-Improving, RSI):內層循環收集證據、產生初步答案,外層循環逐條約束審計這個答案,挑出未解的宣稱,再啟動針對性的後續研究。
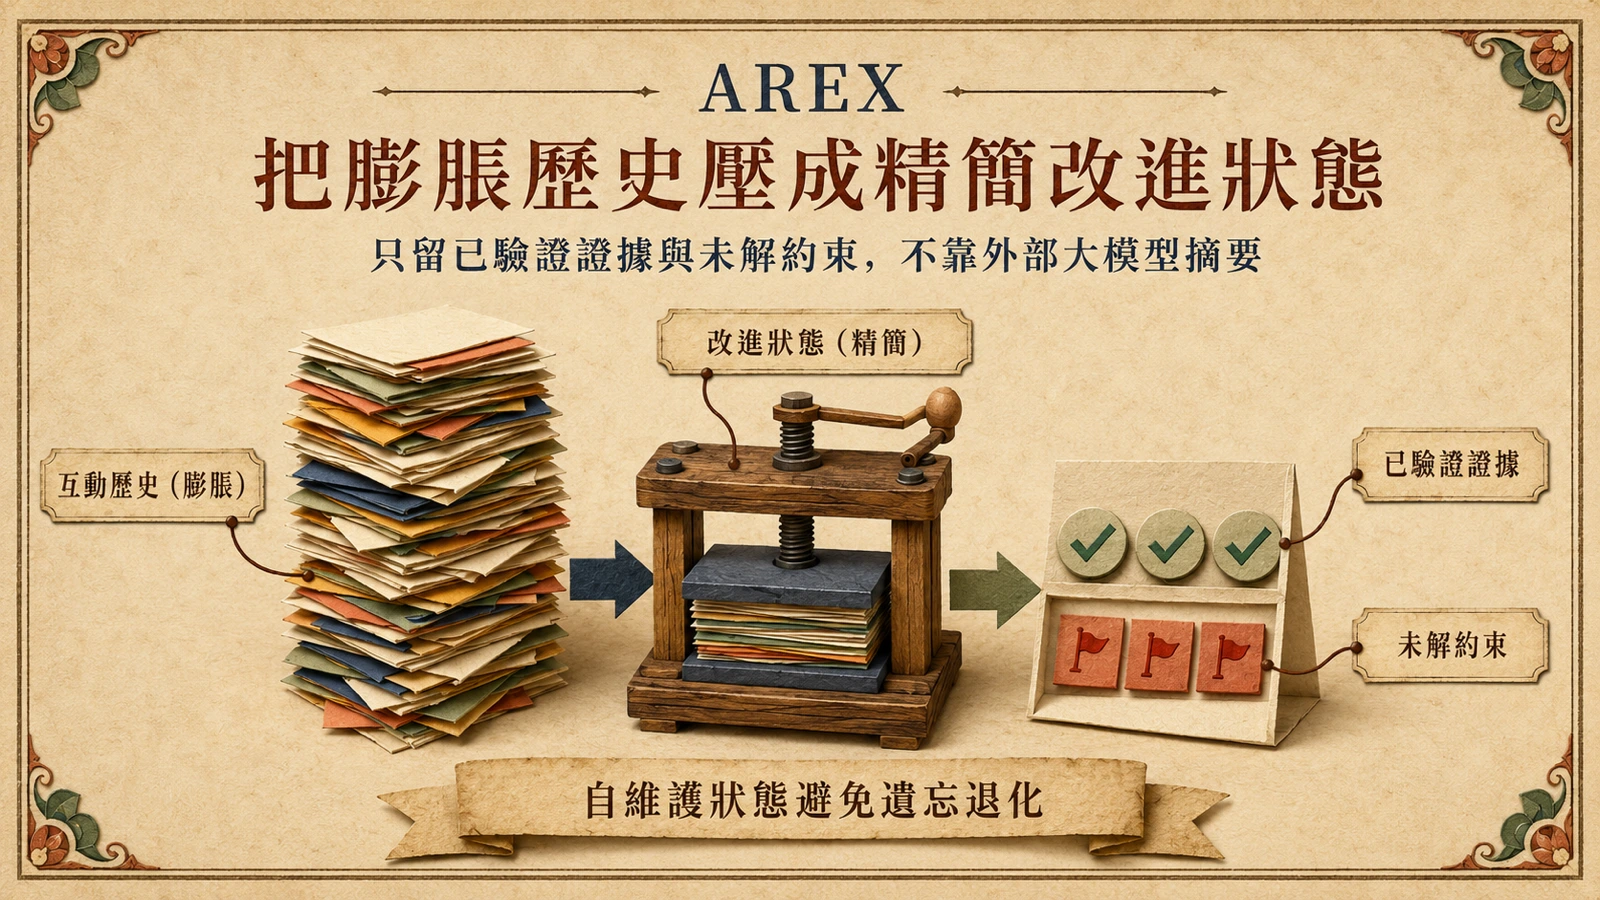
為了在長跨度任務中維持這套循環不退化,AREX 學習了一個自主上下文更新工具,把不斷膨脹的互動歷史壓縮成精簡的「改進狀態」,保留已驗證證據與未解約束,且不依賴外部大模型來做摘要。
內外雙循環如何避免退化
遞迴自改進聽起來直觀,落地卻有兩道結構性難關:一是長跨度下最終獎勵極度稀疏,模型往往要走出數十步才看得到對錯訊號;二是互動歷史隨步數線性膨脹,最終把上下文窗口塞爆,讓「記得自己驗過什麼」本身變成不可能的任務。AREX 對第一道難關的回應是改變獎勵設計——在 agentic mid-training 與長跨度強化學習階段,特別強調那些「取得決定性證據」或「修正錯誤研究方向」的關鍵步驟,把稀疏的最終獎勵拆成可沿途觀測的中間訊號,緩解信用分配(credit assignment)在長軌跡上的稀釋。
對第二道難關,則是前述的自主上下文更新工具。它把不斷累積的瀏覽、檢索與對話歷史壓縮成一份精簡的「改進狀態」,只保留兩類資訊:已驗證的證據與尚未解開的約束。這份狀態由模型自己維護、不呼叫外部大模型摘要,既省下額外推理成本,也避免摘要模型引入的失真。值得決策者注意的是,這套機制讓內外雙循環在數十步的長跨度任務中仍能持續運作而不退化——它不是附加功能,而是整個遞迴自改進設計賴以運轉的關鍵組件。少了它,外層循環很快就會在已經遺忘的脈絡裡重複驗證同一條約束,遞迴改進也就退化成原地打轉。
驗證器品質決定自改進的上限
AREX 的「遞迴自改進」成敗繫於外層循環那個逐約束驗證的步驟:約束必須可被明確拆解、驗證本身必須比發現便宜,整套迴圈才有意義。一旦面對的是開放式、約束本身就模糊的真實問題(例如「評估這項策略是否可行」),逐條驗證會退化為模型自我確認,外層循環失去校正力,遞迴就回到原地打轉。這也點出一個常被忽略的命名界線:AREX 的「self-improving」改善的是「單一答案對固定約束的滿足度」,屬於有界的自我校正,而非 AGI 語境下那種提升代理本身能力上限的無界自改進。對採購與治理決策者而言,這代表它在約束清晰的深查任務(法規比對、規格核實、引用查證)上最具價值,而在約束待定的探索型任務上,應預期其迴圈容易空轉,需另行設計約束生成機制。
4B 與 122B-A10B MoE 實例化並開源
訓練面,AREX 採用 agentic mid-training 與長跨度強化學習,並在合成的已驗證任務與高品質軌跡上訓練;為緩解長跨度下最終獎勵稀疏的問題,特別強調那些取得決定性證據或修正錯誤研究方向的關鍵步驟。團隊實例化兩個模型:4B 密集模型,以及 122B-A10B(總參 122B、每 token 激活約 10B)的 Mixture-of-Experts 模型,權重已在 HuggingFace 的 BAAI/arex collection 公開。
基準成績與對決策者的意義
在 BrowseComp、WideSearch、DeepSearchQA、Humanity’s Last Exam(HLE)以及多項推理與工具使用基準上,AREX 顯著優於可比規模的基線模型,並與使用明顯更多激活參數的模型保持競爭力。論文標題為《AREX: Towards a Recursively Self-Improving Agent for Deep Research》,已於 2026 年 7 月 23 日上傳 arXiv(編號 2607.21461)。
對AI 決策者而言,重點不在分數本身,而是「逐約束驗證 → 針對性補強」的迴圈設計,可作為評估自建檢索代理與企業研究助手時的工程藍圖;10B 量級激活的 MoE 在推理成本與品質間提供了明確的落點,是評比深查型代理時值得列入的基準。若把這套設計放到治理與採購語境,可對照〈北京智能體政策如何定義 Harness Engineering〉;若系統進入十億級檢索規模,〈Helmsman 的全快閃向量架構〉則提供另一層基礎設施成本參照。