8.8 分鐘的啟動痛:上 TB 權重卡在磁碟頻寬
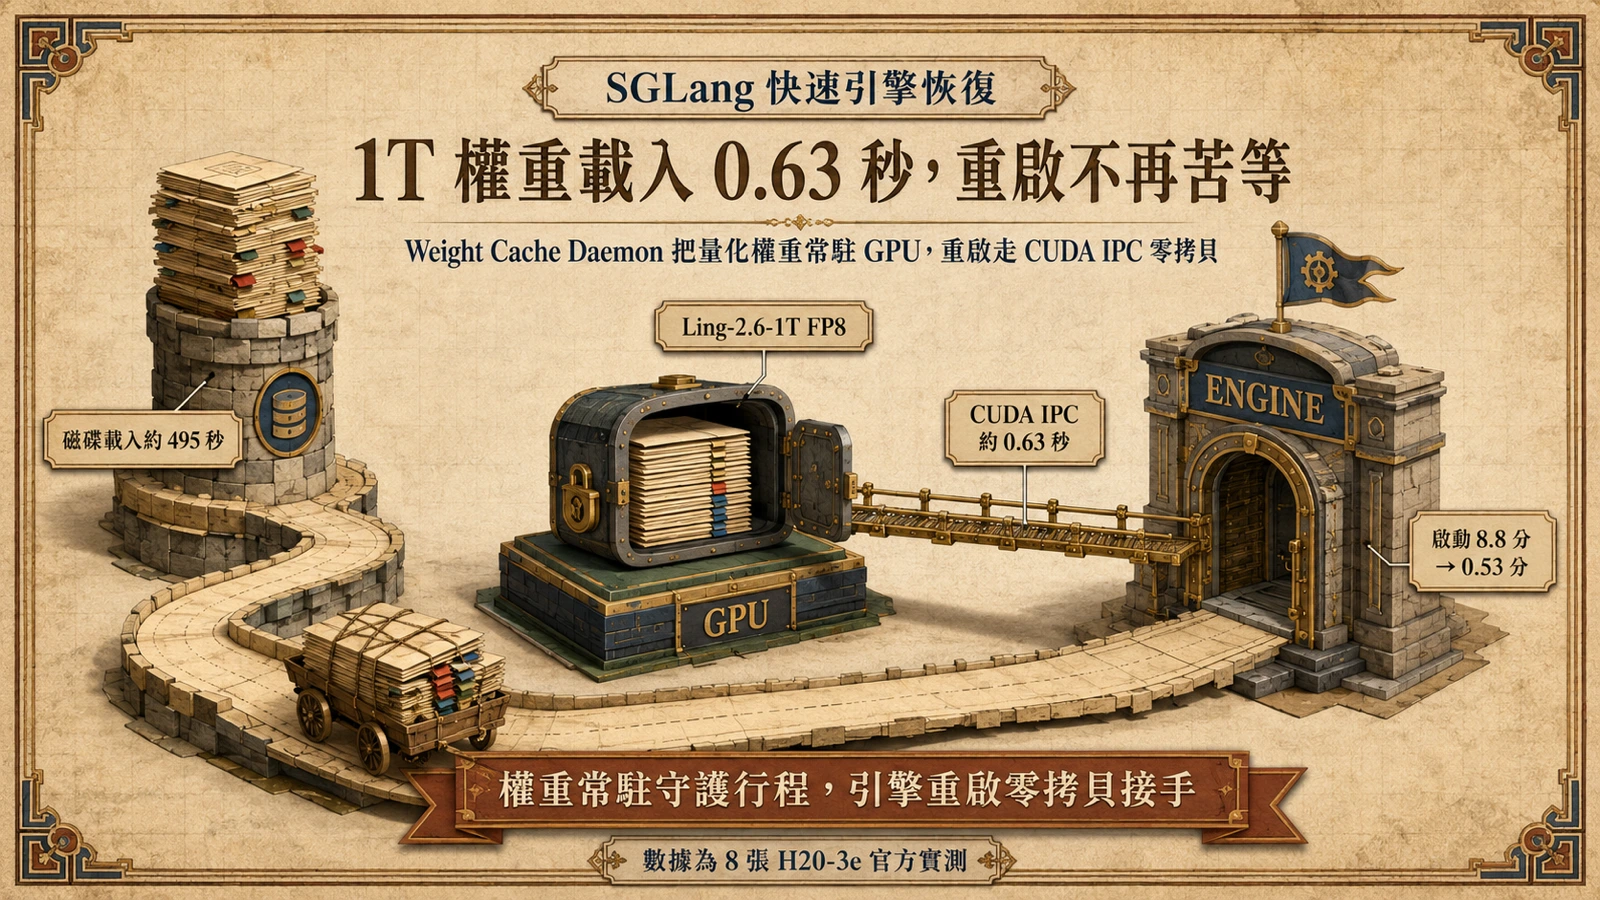
推論引擎最怕的時刻之一,是崩潰後的重啟。SGLang 團隊於 8 月 21 日在 LMSYS 官方部落格發布「Sub-Second Engine Restart for SGLang via Weight Cache Daemon」,開場場景很具體:部署在 8 張 H20-3e GPU 上的 Ling-2.6-1T FP8 實例,光是要進入可服務狀態就需要約 8.52 分鐘,而權重存放在 3.5TB NVMe SSD 上。官方部落格的量測指向的瓶頸不是 GPU 算力,而是把上 TB 的模型權重從磁碟搬進顯存這一段:模型越大、量化流程越複雜,每次引擎啟動都得重走一遍「讀檔、量化、切分、載入」。對需要頻繁輪替版本、調整組態或從故障中恢復的線上服務來說,分鐘級的重啟窗口直接侵蝕可用性——多實例滾動更新時,每個實例都得付一次這個代價。
Weight Cache Daemon 怎麼運作:權重常駐、重啟零拷貝
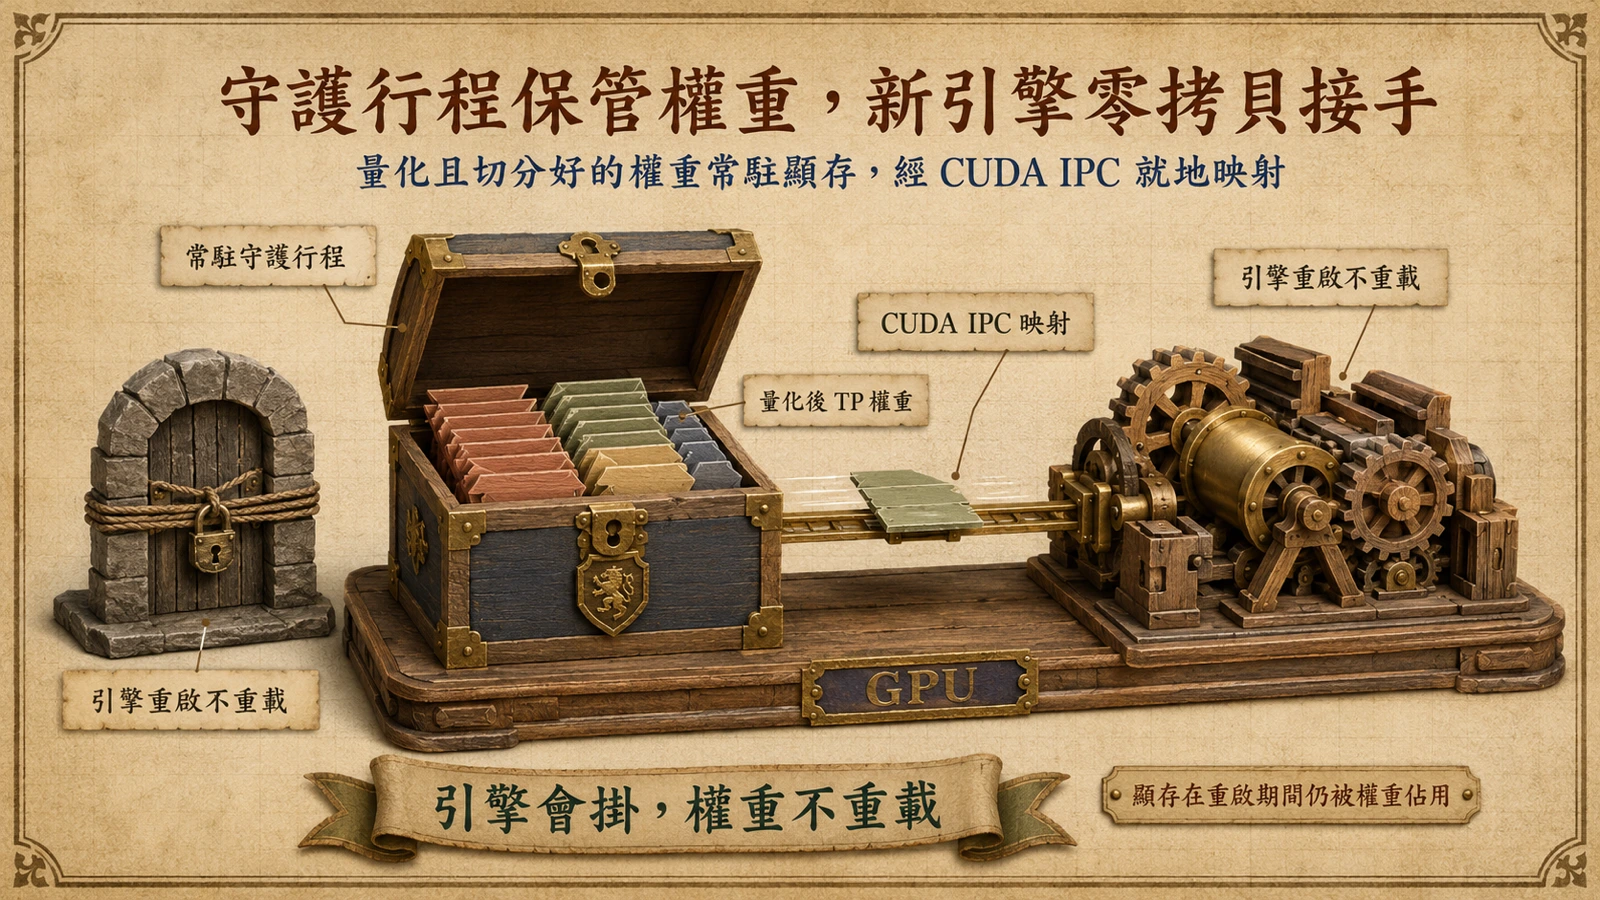
Weight Cache Daemon 的解法,是把「權重」與「引擎」的生命週期拆開。原始構想出自 SGLang 的 RFC 議題 #27052:把權重載入從 model runner 分離出來,交給一個長壽的 GPU 行程;第一階段實作已在 PR #27139 落地。具體來說,每個 rank(可理解為每張 GPU)各有一個守護行程,它把權重載入、量化、按張量平行切分一次做完,之後就常駐在顯存裡;引擎行程結束或崩潰時,守護行程與它持有的權重都還在。新的引擎啟動時不再回磁碟讀檔,而是透過 CUDA IPC 把守護行程持有的顯存區塊直接映射進自己的位址空間——零拷貝,不必再搬運一份。
關鍵細節在於常駐的內容:依部落格的定義,守護行程持有的是「post-quantized, TP-sharded」權重——已經量化完成、已經切分到每張 GPU 各自需要的形狀,新引擎拿到就能直接使用,任何前置處理都不必重做。per-rank 的設計也與張量平行的部署結構對齊:每張 GPU 本來就只需要自己那一份切分,守護行程按 rank 各自保管,映射時便是就地接手。這正是 0.63 秒能成立的技術前提——重啟階段真正剩下的工作,只是建立行程之間的記憶體映射。
數字怎麼看:495 秒到 0.63 秒
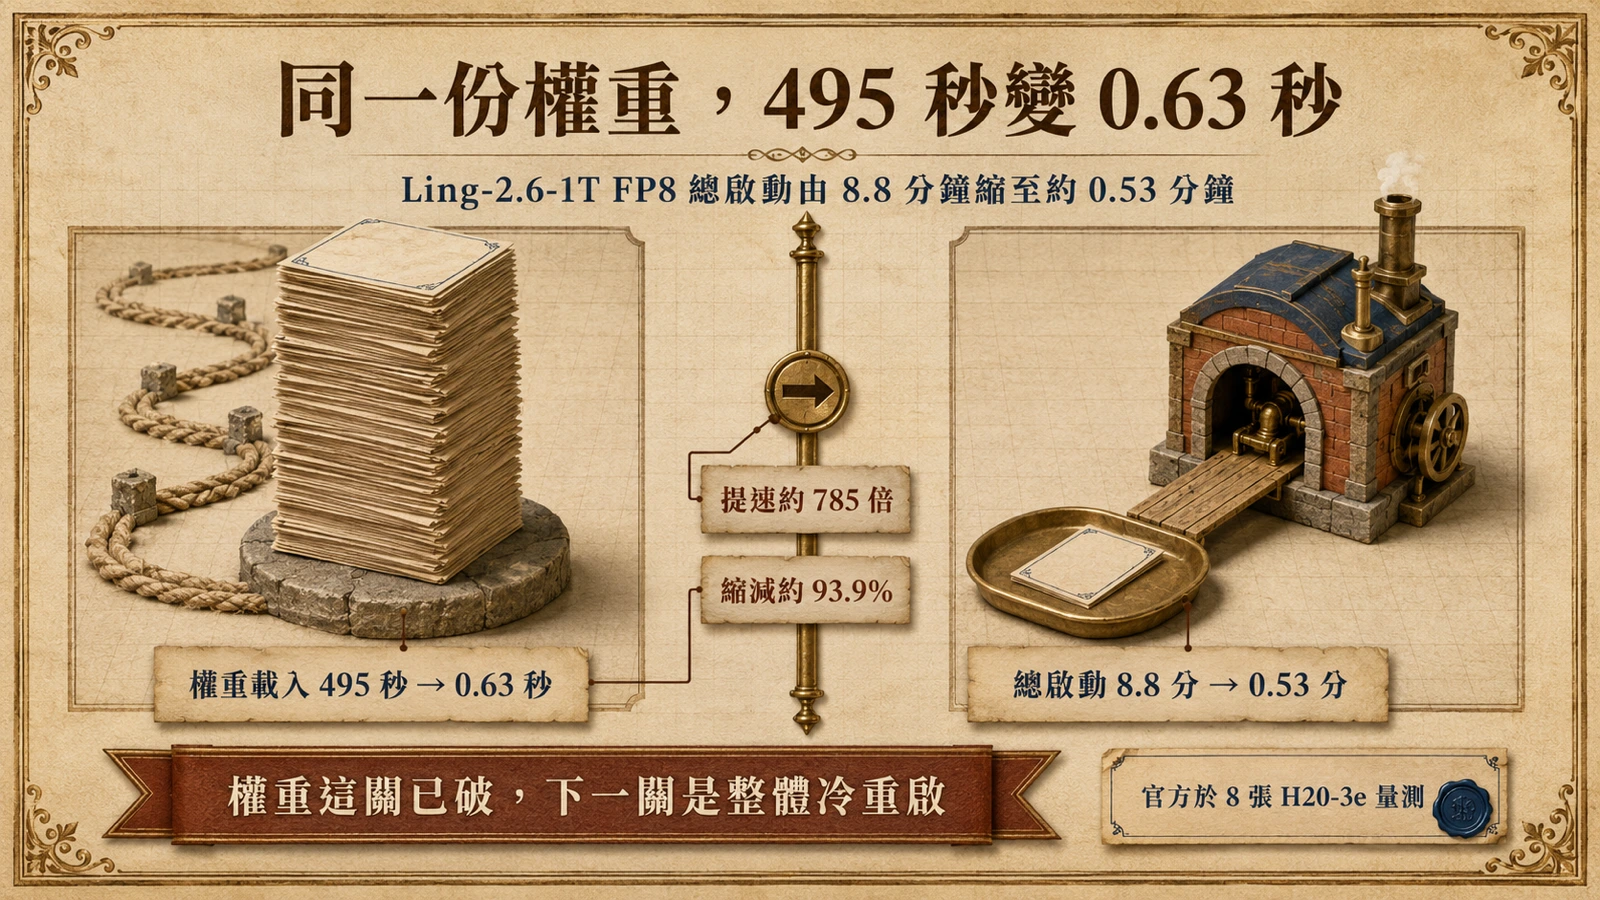
結果面,部落格以 Ling-2.6-1T FP8 為基準給出兩組數字:權重載入從約 495 秒縮至約 0.63 秒,提速約 785 倍;引擎總啟動時間從 8.8 分鐘縮至約 0.528 分鐘(約 32 秒),縮減約 93.9%。兩個數字放在一起看更有意思:8.8 分鐘是 528 秒,其中權重載入就占了約 495 秒——也就是說,傳統啟動流程的時間有九成以上花在權重這一段,把它壓掉之後,總啟動自然只剩下零頭。路線圖議題 #33522 記錄的另一組量測則顯示,權重載入可以從約 306 至 327 秒降到 1 秒內——基準設定不同、數字不同,但「分鐘級變秒級」的方向一致。
值得注意的是 0.528 分鐘這個數字:權重載入在其中只占不到 1 秒,代表其餘約 30 秒花在引擎初始化的其他環節。這也解釋了框架下一步的目標為何放在把冷重啟整體壓到 10 秒內——權重這一段已經不再是主要瓶頸。
不只快重啟:權重共享與秒級備援
快速重啟之外,部落格還點出兩個衍生能力。其一是多實例共享:同一份常駐權重可以映射給多個引擎實例,同機跑多個服務複用同一個模型時,不必每個實例都各自載入一份。其二是秒級主備切換:備援引擎可以在需要時立刻接手指向同一份權重,故障轉移不必重新走一次載入流程。對營運大型 MoE 服務的團隊來說,這把重啟窗口從分鐘級壓到秒級——崩潰恢復、版本輪替、組態變更這些都得重啟引擎的場景全部受益。以 Ling-2.6-1T FP8 的規模估算,一次重啟省下的除了等待時間,還有原本空轉數分鐘的 8 張 GPU。
Fast Engine Recovery 的第一階段
Weight Cache Daemon 是 SGLang「Fast Engine Recovery Framework」的第一階段,官方路線圖寫明的整體目標是 10 秒內冷重啟、1 秒內暖待命切換。第一階段已在 PR #27139 落地,後續並有 GPU Memory Service(GMS)整合議題,要把記憶體管理進一步推向行程外的架構。路線圖同時列出待辦:擴大支援的模型與量化格式、讓快取的生命週期比守護行程更長、讓常駐權重的運用更靈活。換句話說,目前的常駐快取仍與單一守護行程綁定,模型與量化覆蓋也還在擴充——這是採用前需要對照確認的部分。
為什麼拿 Ling-2.6-1T 當示範
示範案例選 Ling-2.6-1T 並非偶然。依 vLLM Recipes 的記載,它是螞蟻集團 inclusionAI 的 BailingMoeV2_5 架構 FP8 旗艦:1T 總參、每 token 激活 50B,混合線性注意力加 MLA,上下文 262K——正是權重載入痛感最強的量級。而 Ling 團隊與 SGLang 的關係也不只是使用者:HuggingFace 模型卡上明白寫著,官方 SGLang 的 MTP 實作存在 bug,建議安裝自家修補版以獲得更好的推論效能——模型團隊自己維護引擎修補,兩邊工程耦合的深度可見一斑。同一系列的 Ling-3.0-flash 發表時,也以「對標 Ling-2.6-1T」作為能力座標。SGLang 生態這一側,從統一 Radix Cache 重構到這次的快速恢復框架,補的都是同一塊拼圖:讓越來越大的開源模型,在工程上真正可營運。
限制與代價:顯存、單節點與官方數據
最後是但書。第一,權重常駐意味著引擎重啟期間,這些顯存仍被守護行程佔用——設計目的正是在引擎掛掉時保住權重,代價是這段期間顯存無法挪給其他工作負載;對顯存吃緊的部署,這是真實的容量取捨。第二,CUDA IPC 是同一節點上跨行程共享顯存的機制,多節點叢集的每個節點各自運行守護行程,跨節點的權重共享不在此機制涵蓋範圍。第三,前述所有數字都是官方在特定硬體(8 張 H20-3e、3.5TB NVMe SSD)上的量測,未附獨立第三方評測;磁碟頻寬、量化格式、模型規模不同,倍數也會不同——約 306 至 327 秒那組數據就反映了不同設定下的差異。第四,模型與量化覆蓋仍在擴充,實際採用前應對照路線圖與文件,確認自己的模型與量化組合已在支援之列。