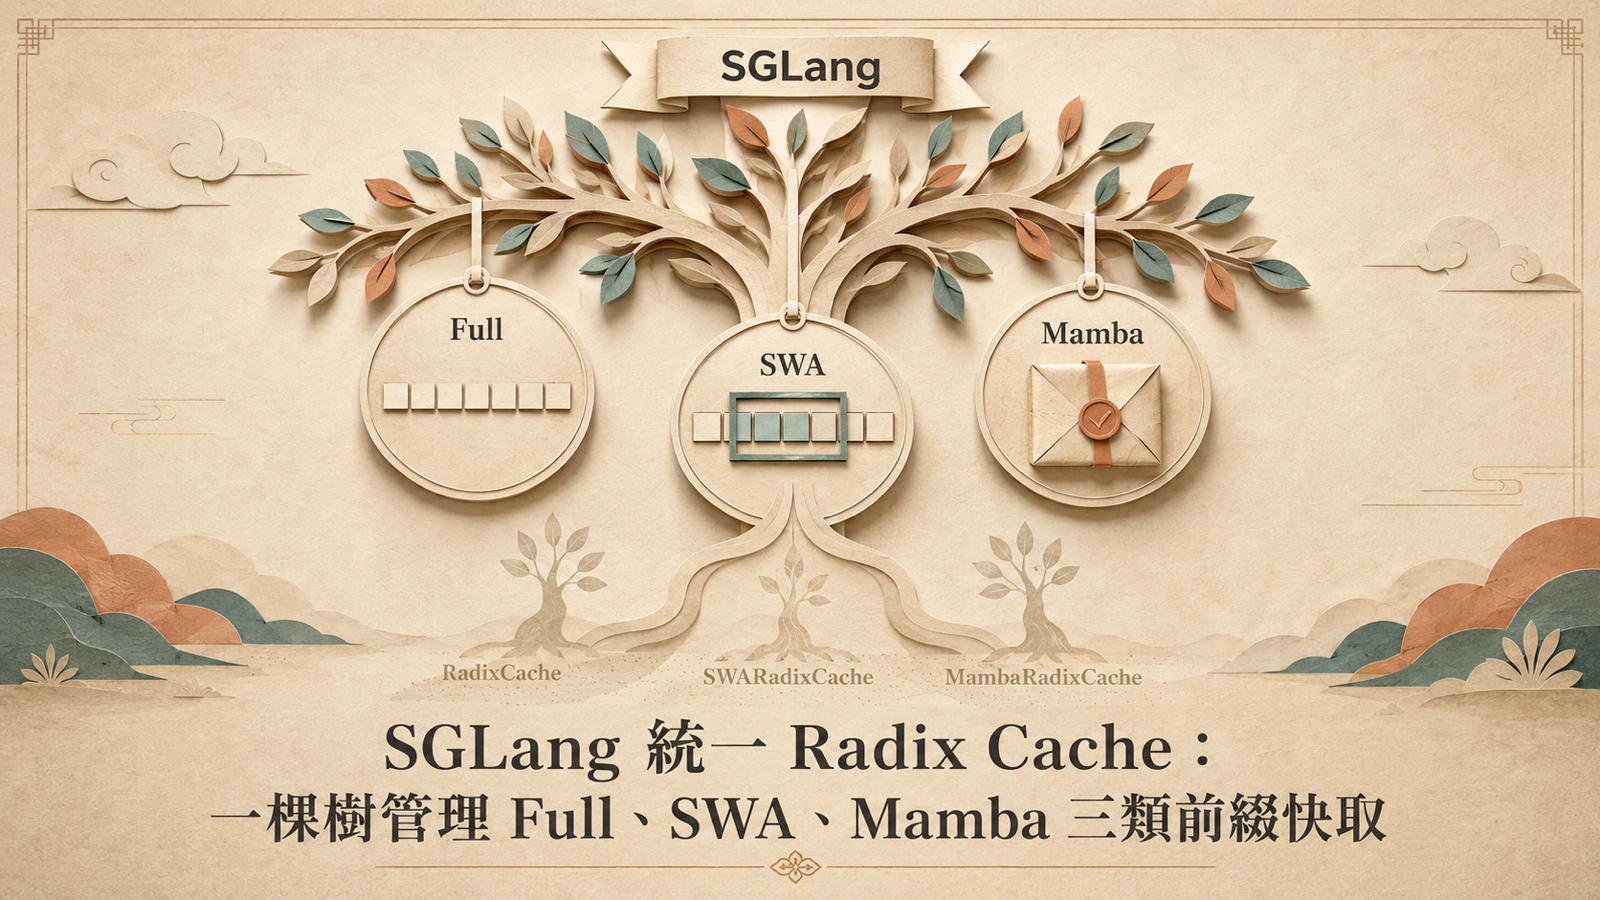
三套分叉的快取,成為 SGLang 的維護負擔
開源推論框架 SGLang 能把多輪對話、few-shot 學習與代理工作負載跑得快,骨幹是 RadixAttention 這套前綴快取機制。它的原理直白:用一棵 radix 樹把 token 序列當作鍵、把對應的鍵值快取(KV cache)張量當作值,請求進來時自動做前綴比對與復用,並以 LRU 策略在顯存吃緊時逐出葉節點。LMSYS 團隊當初在官方部落格介紹它時說得很明白——鍵是 token 序列、值是對應的 KV cache 張量,樹結構存在 CPU 上、維護成本很低。SGLang 的技術報告也把 RadixAttention 列為 runtime 的一大最佳化,並在多項任務上繳出相較當時推論系統最高 6.4 倍的吞吐。
但這套原本只服務全注意力(Full)模型的機制,碰到混合架構就分裂了。當模型把全注意力層、滑動窗口注意力(SWA)層、與 Mamba 這類狀態空間層交錯堆疊,三者的鍵值/狀態結構與復用規則各不相同,SGLang 於是長出三套各自分叉的實作。專案在 2026 年 3 月提出的路線圖議題 #20415 寫道,RadixCache、MambaRadixCache、SWARadixCache 三套實作共享大量邏輯,卻以分叉副本各自維護,結果是「程式碼重複、行為不一致,擴充到新模型類型時維護負擔沉重」。
統一的起點:一棵樹、三個組件
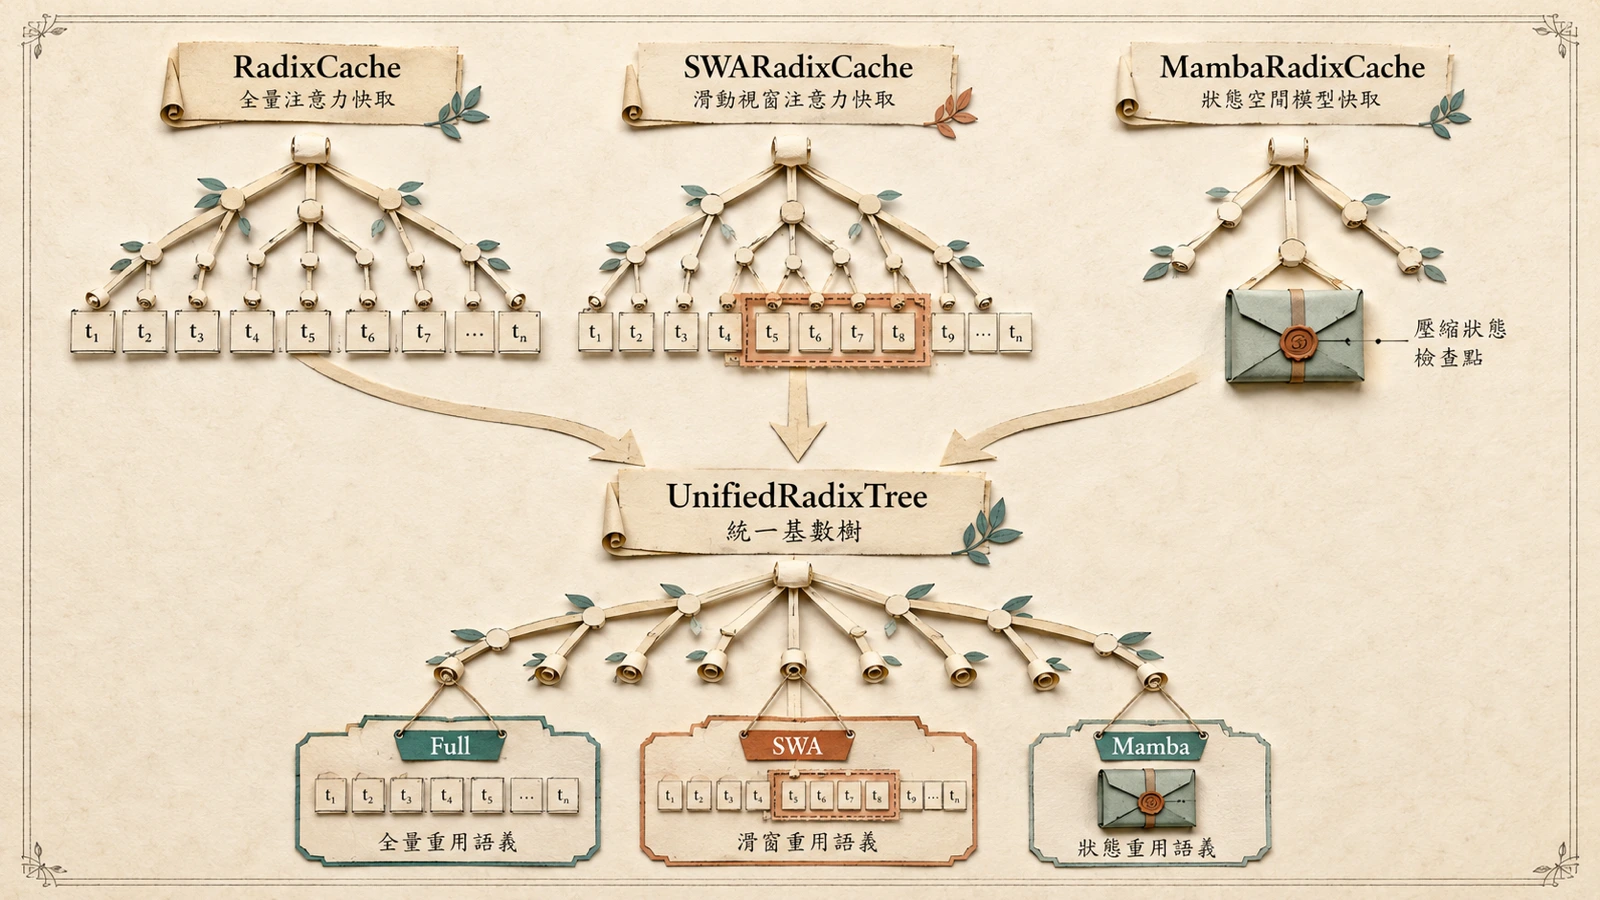
Unified Radix Cache 的方向,是把不同模型層的快取收攏到同一套介面之下。路線圖把目標定為「圍繞一個共同基礎介面,統一混合式 radix cache 階層」——讓新增快取變體時不必重複造輪子,也確保不同實作行為一致。具體做法是統一出一棵以 token 鍵控的 UnifiedRadixTree,由它掌管 token 序列的索引、前綴比對與插入等共通操作。
不同層的差異,路線圖則以 full、swa、mamba 三個組件來承接,並各自配置對應的最佳化與 HiCache 卸載——它明列涵蓋 mamba、swa、full 三個組件的 offloading 支援。也就是說,無論模型是純全注意力、混了滑動窗口,還是摻了 Mamba 狀態層,對外都走同一棵樹;至於三種層各自的復用規則——全注意力的逐段復用、滑動窗口的局部範圍、Mamba 的狀態檢查點——則交給對應組件各自處理。把共通的樹狀索引留下、把會打架的層級差異收進組件,是一棵樹能同時服務三種層的關鍵。
Full、SWA、Mamba 各自的復用語意
三個組件對應三種截然不同的復用規則,這正是混合模型快取比純 Transformer 難的原因。Full 層走經典鍵值快取:每個位置的鍵值張量可逐 token 對齊、逐段復用,前綴命中就能直接接上。SWA 層只看局部窗口,窗口外的舊資料不再被讀取,因此快取只需保留最近一個窗口的範圍。Mamba 這類遞迴狀態空間層則完全不同:它的「快取」是壓縮後的隱狀態(SSM state),復用時必須整段一起命中,沒辦法像鍵值快取那樣逐 token 拼接。
路線圖為後兩者各開了專屬最佳化。針對 Mamba,它把卸載機制改成在 session 場景「只卸載每個請求的葉節點、中間節點不再卸載」,以提升 Mamba 的並行排程能力;針對 SWA,則是在從 L2 載回 L1 時「只載入窗口範圍、跳過窗口外資料」,降低載回延遲。把這三套規則塞回同一棵樹、卻讓每個組件各自守住自己的語意,就是 Unified Radix Cache 要解的工程題。
重構分階段推進,長期劍指 Rust
路線圖把工程拆成幾個階段。Stage 0 先統一 radix 樹介面——match_prefix、insert/evict、lock 等共九支 PR——讓三套實作走同一組參數與流程。Stage 1 是主菜:交付 Unified HybridRadixTree V2(PR #21206),把 UnifiedRadixTree 搬進主目錄、補上完整文件,並加入涵蓋 mamba、swa、full 三個組件的 HiCache 分層卸載、以 bigram key 為基礎的 Mamba Cache V2,以及把 StreamingSession 整合進 UnifiedRadixCache 的 session cache。這個階段還收掉一批效能最佳化,從 LRU、長脈絡的路徑壓縮,到為滑動窗口拆分樹節點。一旦穩定,計畫是「移除其他所有樹實作(含 RadixTree、SwaRadixTree、MambaRadixTree),只保留 UnifiedRadixTree」。
Stage 2 收尾清理介面命名與語意;Stage 3 則是更長遠的藍圖——先用連續陣列取代 token 儲存作為前置工程,再待設計收斂後以 Rust 重寫。換言之,統一介面不只是當下的整理,也是為日後換儲存結構、換實作語言鋪路。
為什麼這件事值得關注
對推論服務的使用者,統一快取的意義不在一次性的速度數字,而在它改變了 SGLang 支援新架構的方式。混合注意力與狀態空間模型已是主流路線,而每多一種層類型,舊的「一套模型一套快取」做法就得再分叉一份。Unified Radix Cache 把這條分叉收斂成單一骨架,讓新增層類型、HiCache 分層卸載、Prefill-Decode 分離等擴充都能掛在同一棵樹上。另一層意義是工程債務的清理:三套分叉實作最痛的是行為不一致——同一套快取語意在不同模型上可能走出不同結果,這對需要穩定行為的生產推論是隱形風險,路線圖提到的 SWA/Mamba 一致性修補正是針對這類問題。
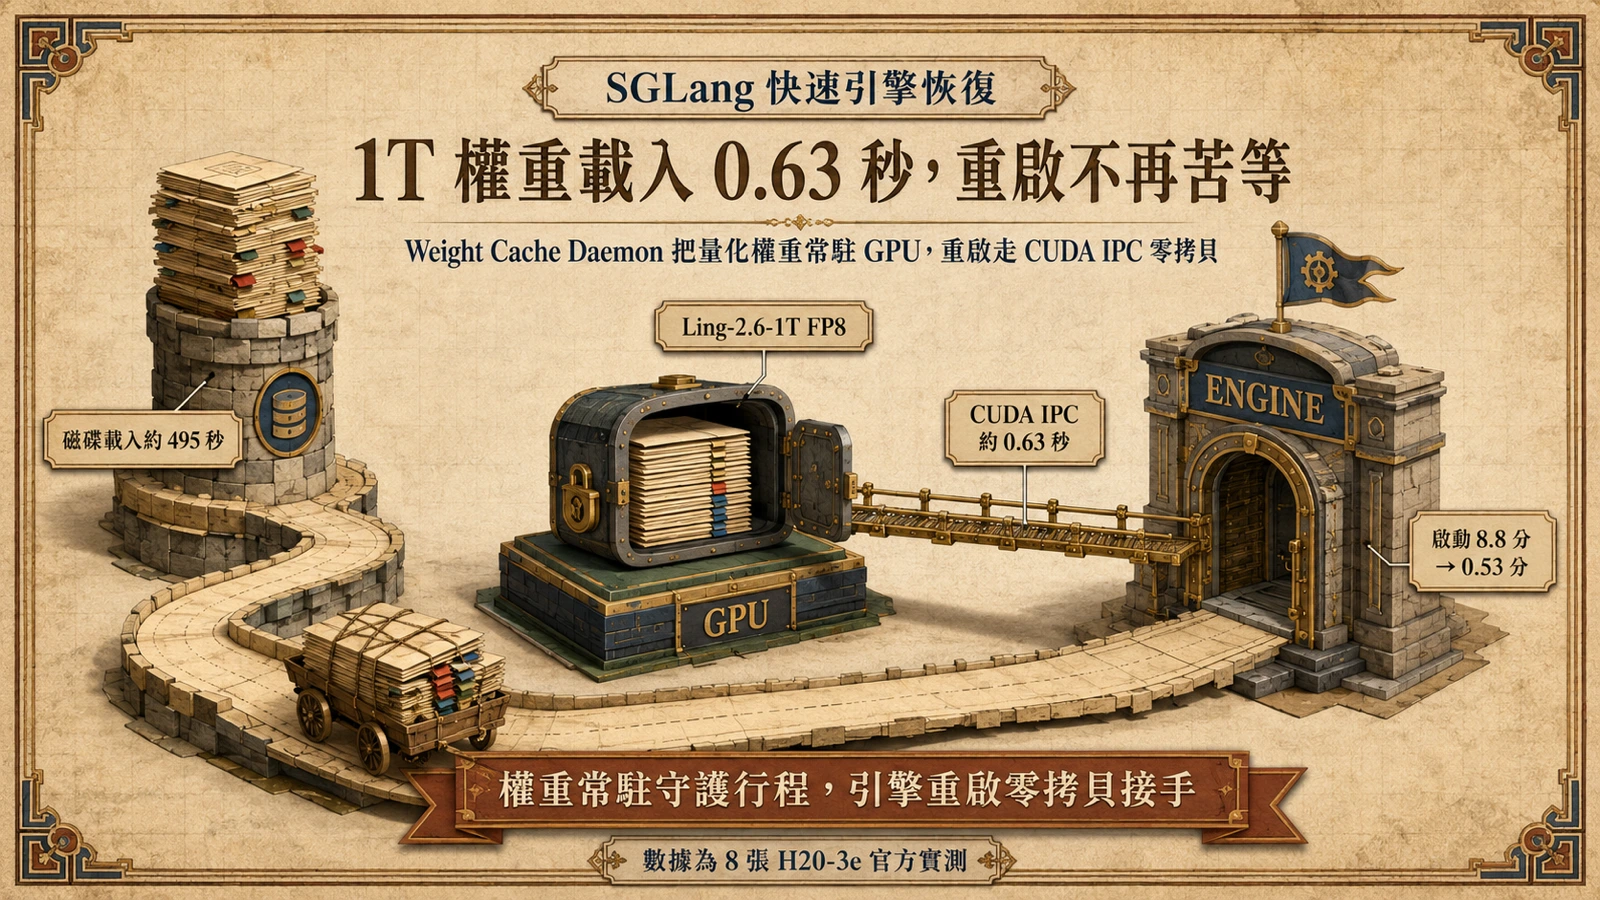
不過有幾點值得看清楚。其一,這是一份進行中的路線圖,階段與 PR 會調整,不宜把任何單一支 PR 當成已穩定的承諾;其二,文中提到的一致性修補與最佳化,實際效果視模型與工作負載而定,AIDM 並未獨立實測。換言之,Unified Radix Cache 解的是「同一棵樹能不能同時服務三種層」的結構問題;若瓶頸在模型重啟時的權重載入,則是 Weight Cache Daemon 把 1T 權重載入壓到 0.63 秒所處理的另一層。兩者換來多少延遲與吞吐改善,仍要等它們在更多模型與工作負載上落地才能論斷。