提示詞之後的互動單元
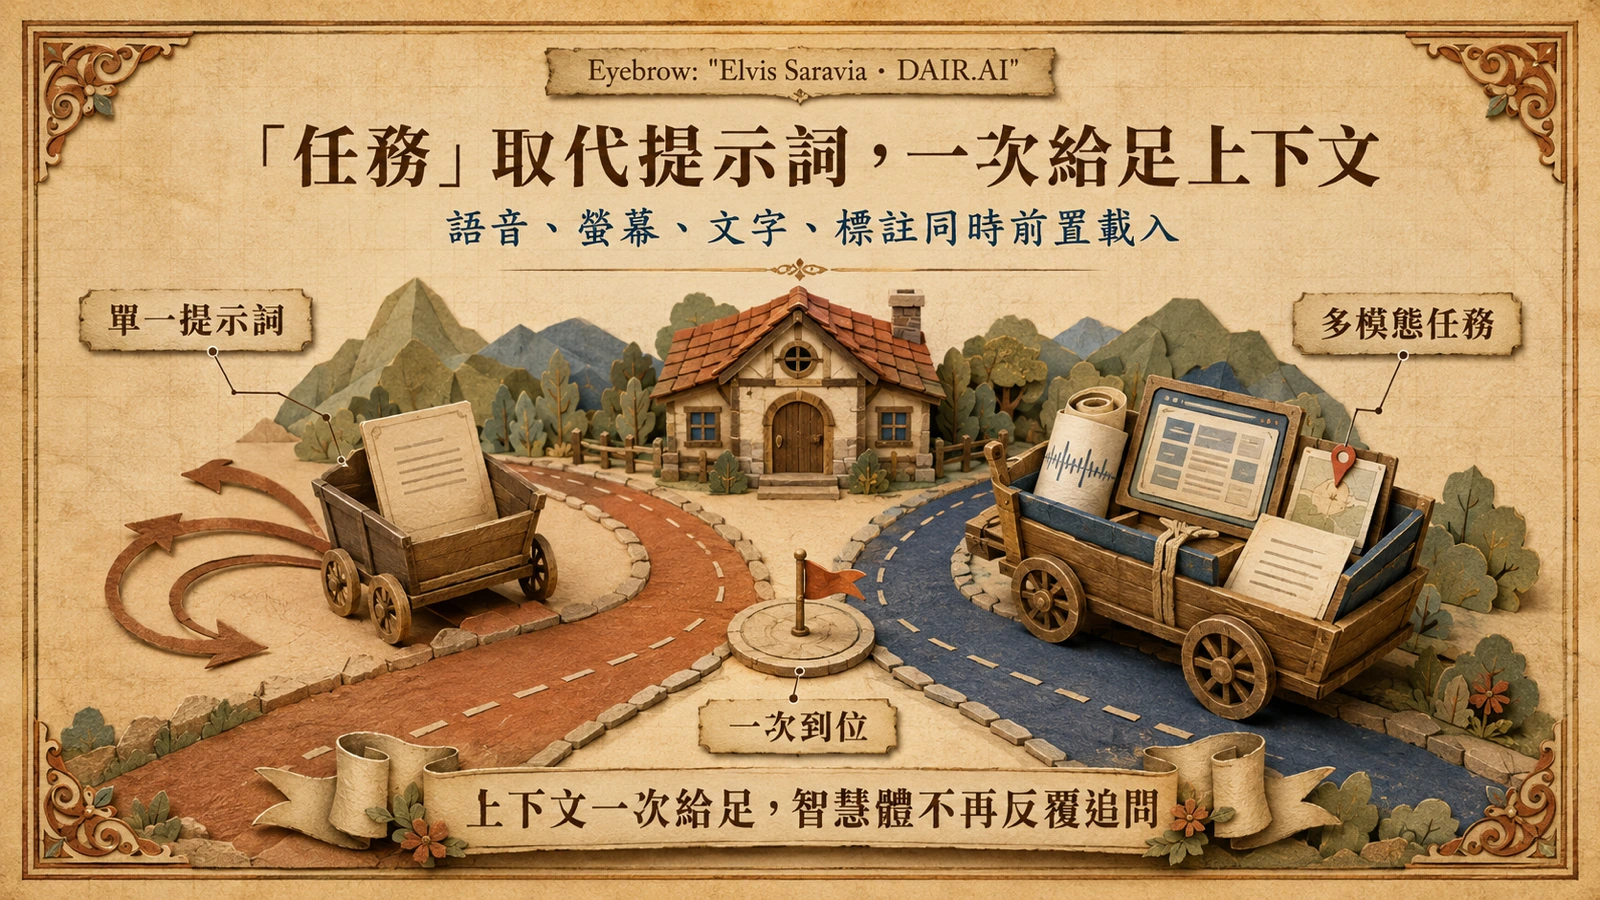
DAIR.AI 共同創辦人 Elvis Saravia 在 X 發表〈What Comes After the Prompt〉,提出以「任務」(task)作為比單一提示詞更大的互動單元。一個任務會在一次互動中,把指令與盡可能完整的相關上下文一起交給智能體,內容可涵蓋較長的語音說明、當前螢幕畫面、精確文字、標註、轉錄稿與影像。他將此構想歸功於 Andrej Karpathy 近期關於「長語音會話作為提示詞」的討論,並進一步用更多模態延伸該思路,產品端可對照〈Claude 語音模式〉。
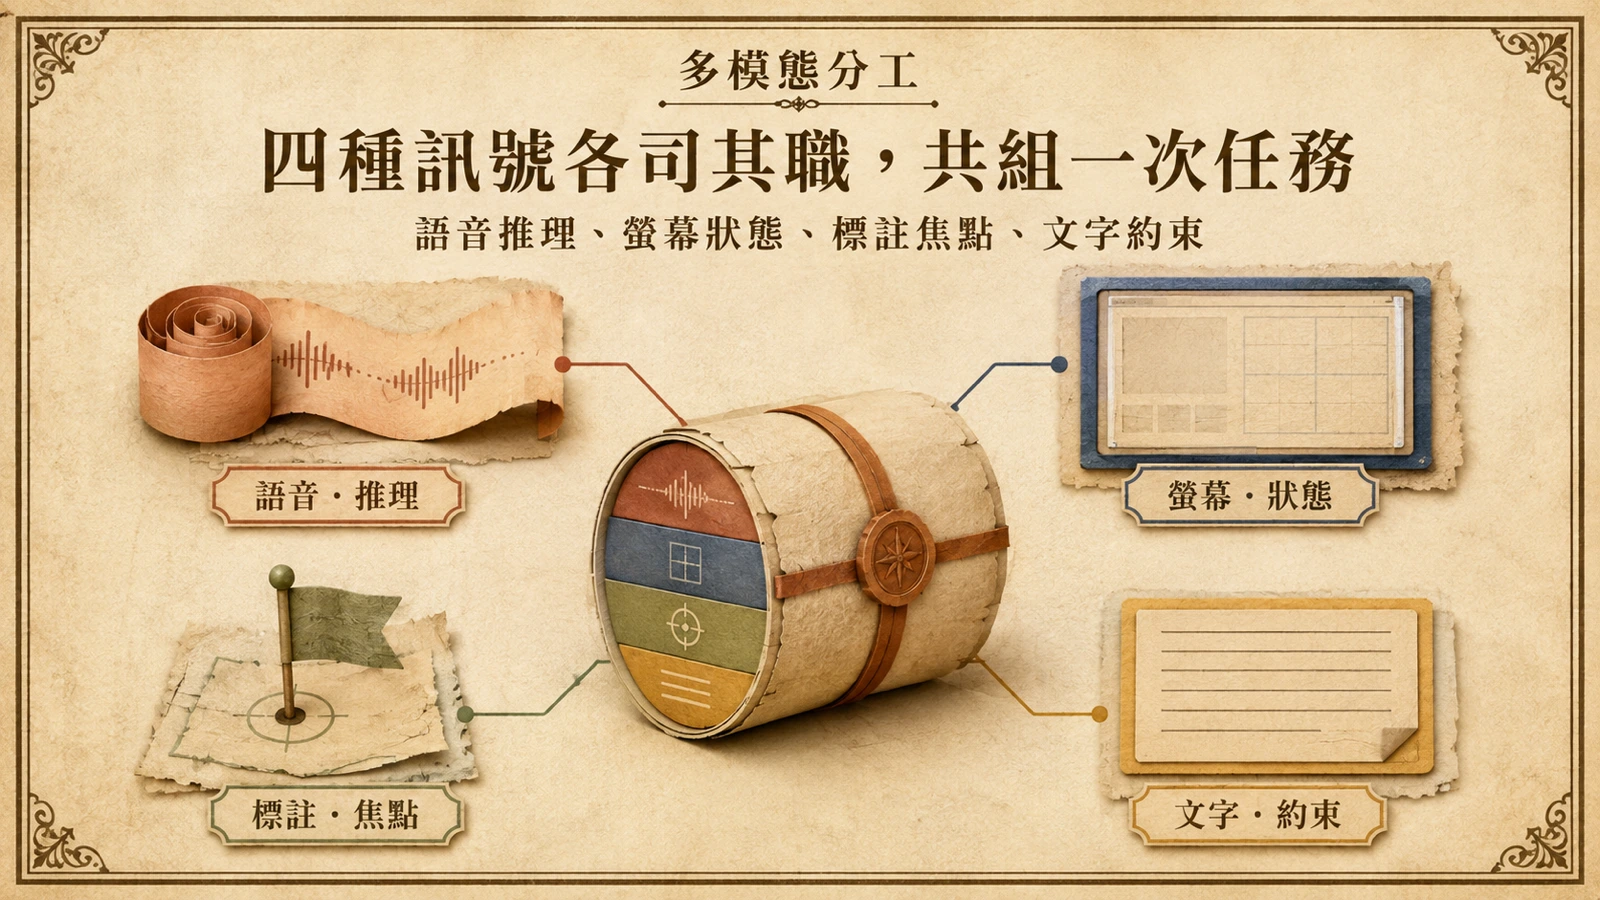
Saravia 為每種模態劃分角色:語音承載推理過程、優先順序與不確定性,螢幕給出當前狀態與環境,標註將注意力引導到具體細節,文字則保留精確需求、名稱與約束。這些訊號共同為模型提供更豐富的工作表徵。
前端載入上下文降低修正循環
實務上,Saravia 會在講解工作時錄下語音筆記、截取相關畫面、用快速標註標記,再貼上智能體所需的精確文字,把原本要分多次提供的上下文一次性前置載入。他指出,更豐富的任務減少了重複來回——那種得反覆說明脈絡、指出同樣細節、或糾正原本可從一開始就避免的假設的情況。
他舉例,在一個自己不熟悉的平台上排程發布時,以語音說明目標與約束、共享排程頁面螢幕並標註關鍵欄位,智能體就能一次完成設定,過去常見的後續追問不再出現。這類方法對 browser use 與 computer use 尤其適用,因為智能體可同時看見環境、聽見推理過程、跟隨標註、再用文字取得精確細節。
Saravia 強調,簡單請求仍應使用簡單提示詞;只有任務運行時間長、精度要求高、需導航陌生介面,或錯誤會導致多輪修正時,他才會動用更豐富的多模態任務。多模態任務因包含更多上下文而成本較高,但根據他的經驗,這筆投入通常值得。
多模態任務的成本效益邊界
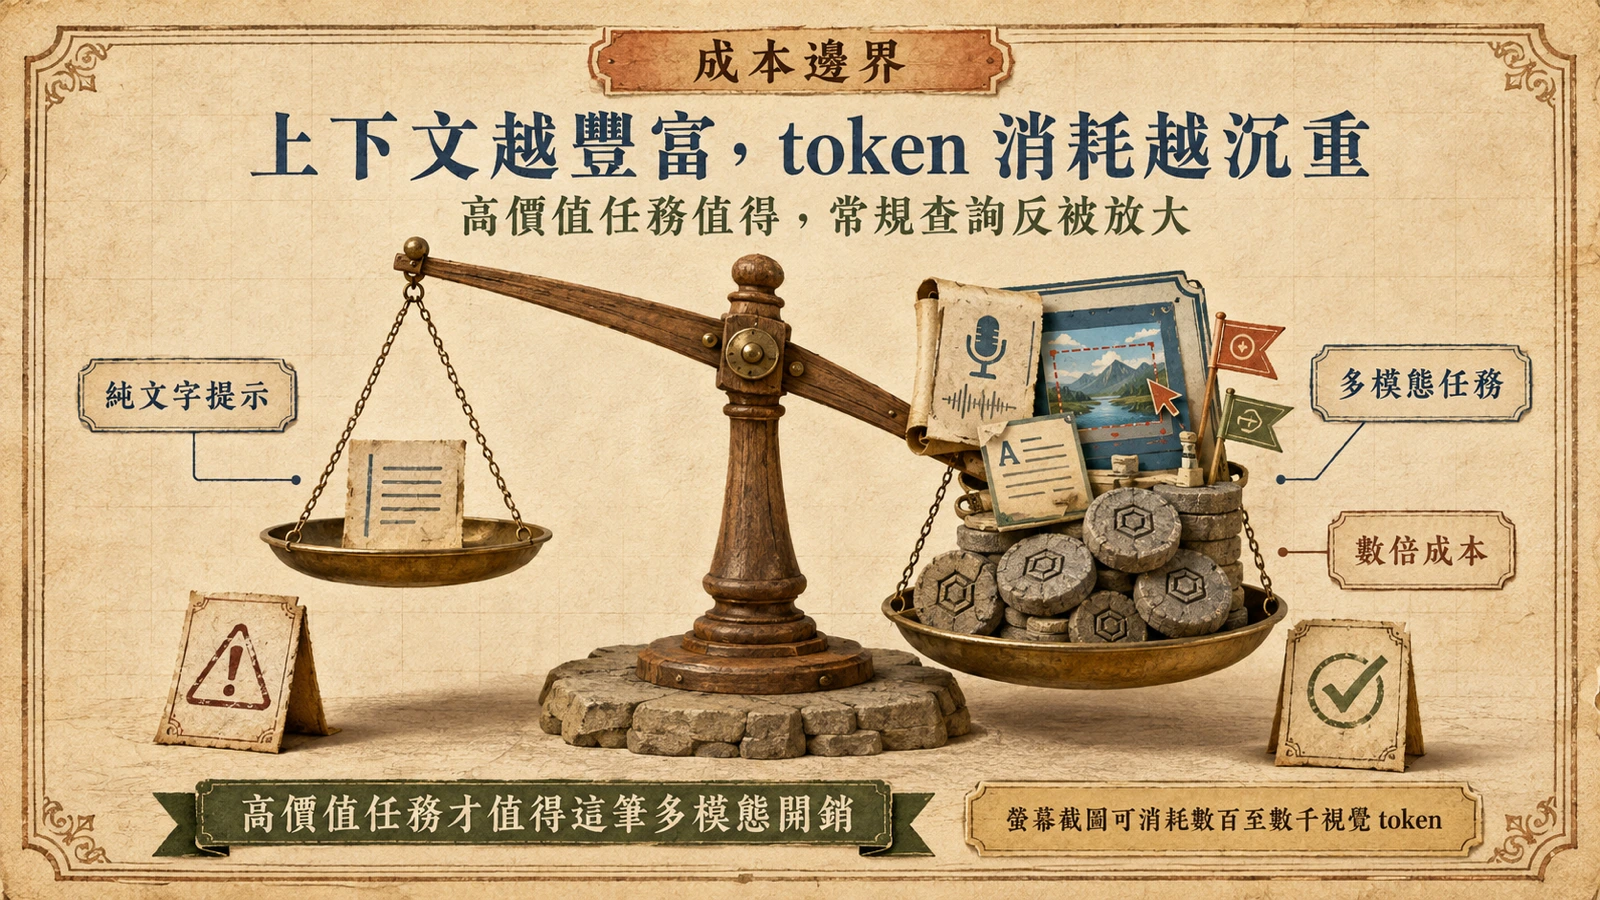
Saravia 的構想雖然直覺,但存在一個尚未被量化討論的成本效益邊界。多模態任務把語音、螢幕截圖、標註與文字同時送進模型——這意味著每次互動的 token 消耗遠高於純文字提示。語音轉文字本身增加推理成本,螢幕截圖在高解析度下可能消耗數百至數千視覺 token,標註則需要額外的空間推理。對單次高價值任務(如陌生平台部署、跨系統資料遷移),這筆投入值得;但若用於常規查詢,多模態任務反而會把簡單問題的成本放大數倍。
更根本的挑戰是上下文衰減。即使是 256k context window 的模型,當一次任務塞入語音逐字稿、多張截圖、文字約束與歷史軌跡時,模型對早期訊號的注意力會下降——這與 Anthropic 在上下文工程中提出的「漸進式揭露」原則形成張力。Saravia 主張前置載入盡可能完整的上下文以減少修正循環,但 Anthropic 的方向是把上下文分階段揭露、避免一次灌入過多資訊。兩者並非互斥——關鍵在於區分「一次給足建立意圖所需的完整軌跡」(Saravia)與「按需載入執行細節」(Anthropic),但實務上這條線需要大量試誤才能畫準。
從任務軌跡到可複用技能
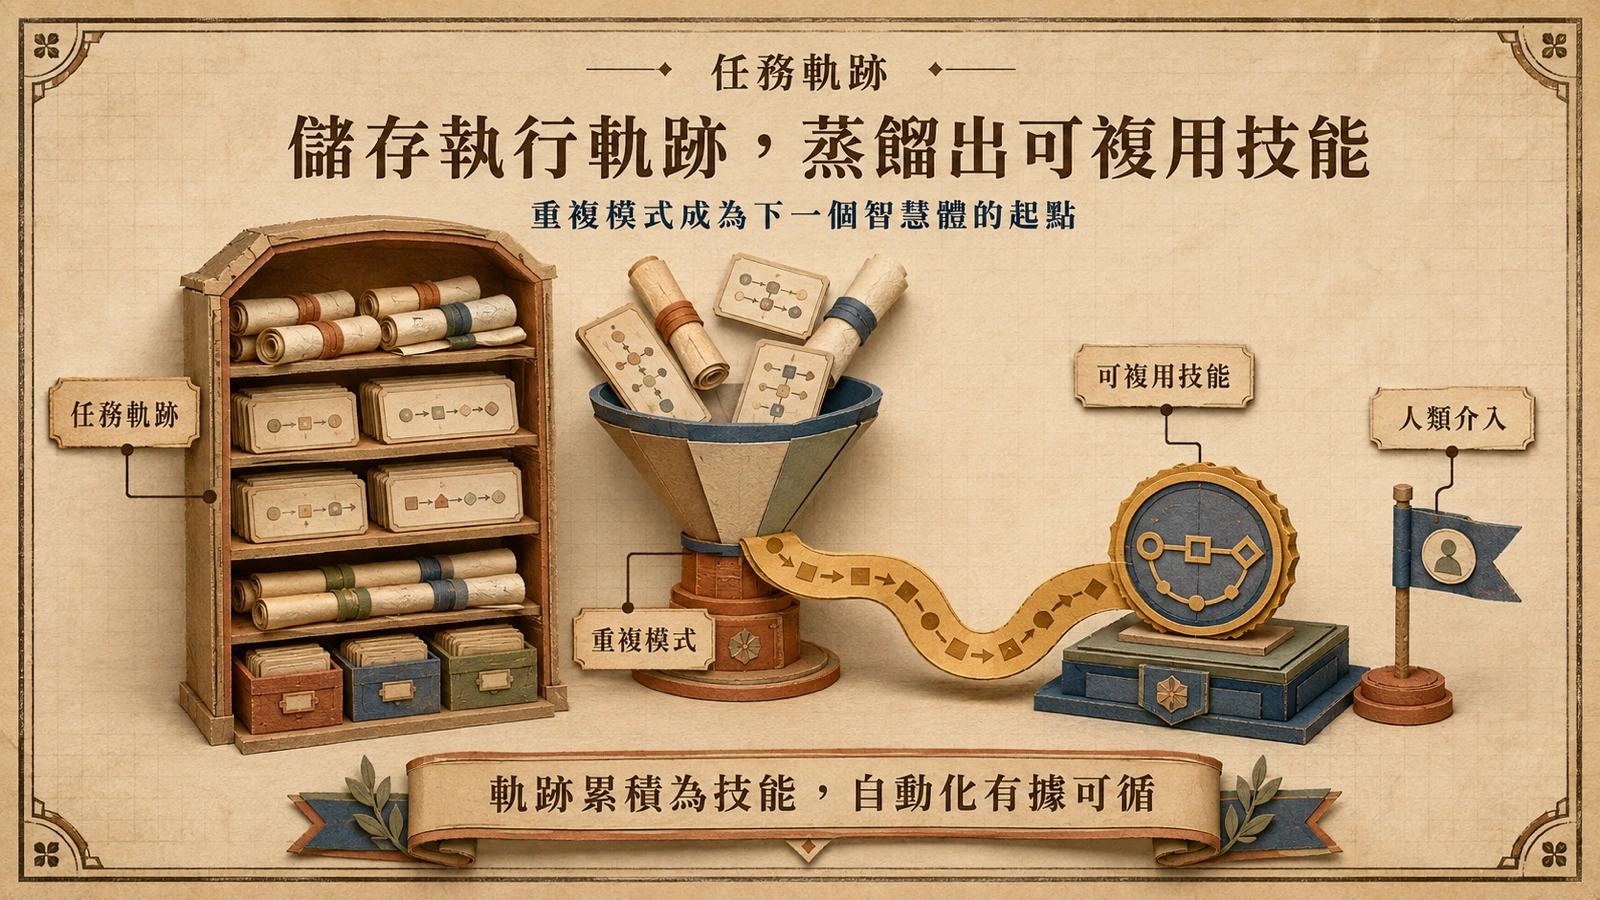
除了當下的效率,Saravia 會把這些任務的執行軌跡儲存下來,從中檢視重複出現的模式,例如動作序列、反覆強調的約束、品質檢查與能穩定改善結果的修正。這些模式可被萃取為可複用技能,讓下一個智能體從更強的工作流程起步,也讓自動化的判斷有據可循:哪些部分可穩定自動化、哪些仍需人類介入。
他預期,原生支援語音、視覺、影像與文字的全模態(omnimodal)模型,會讓這種互動風格變得自然,使用者在同一個會話中可同時說話、展示、指點、打字與提供範例。Saravia 透過 DAIR.AI 學院持續分享相關實作。「任務」這個名稱是暫時性的,但核心主張已透過反覆使用變得清晰:給智能體更豐富的工作軌跡、讓它重建意圖、儲存過程、並複用有效的模式。若要比較把長跨度軌跡轉成自我驗證循環的研究路線,可延伸閱讀〈AREX 遞迴自改進研究代理〉。