Google 把向量索引推向 100 億筆
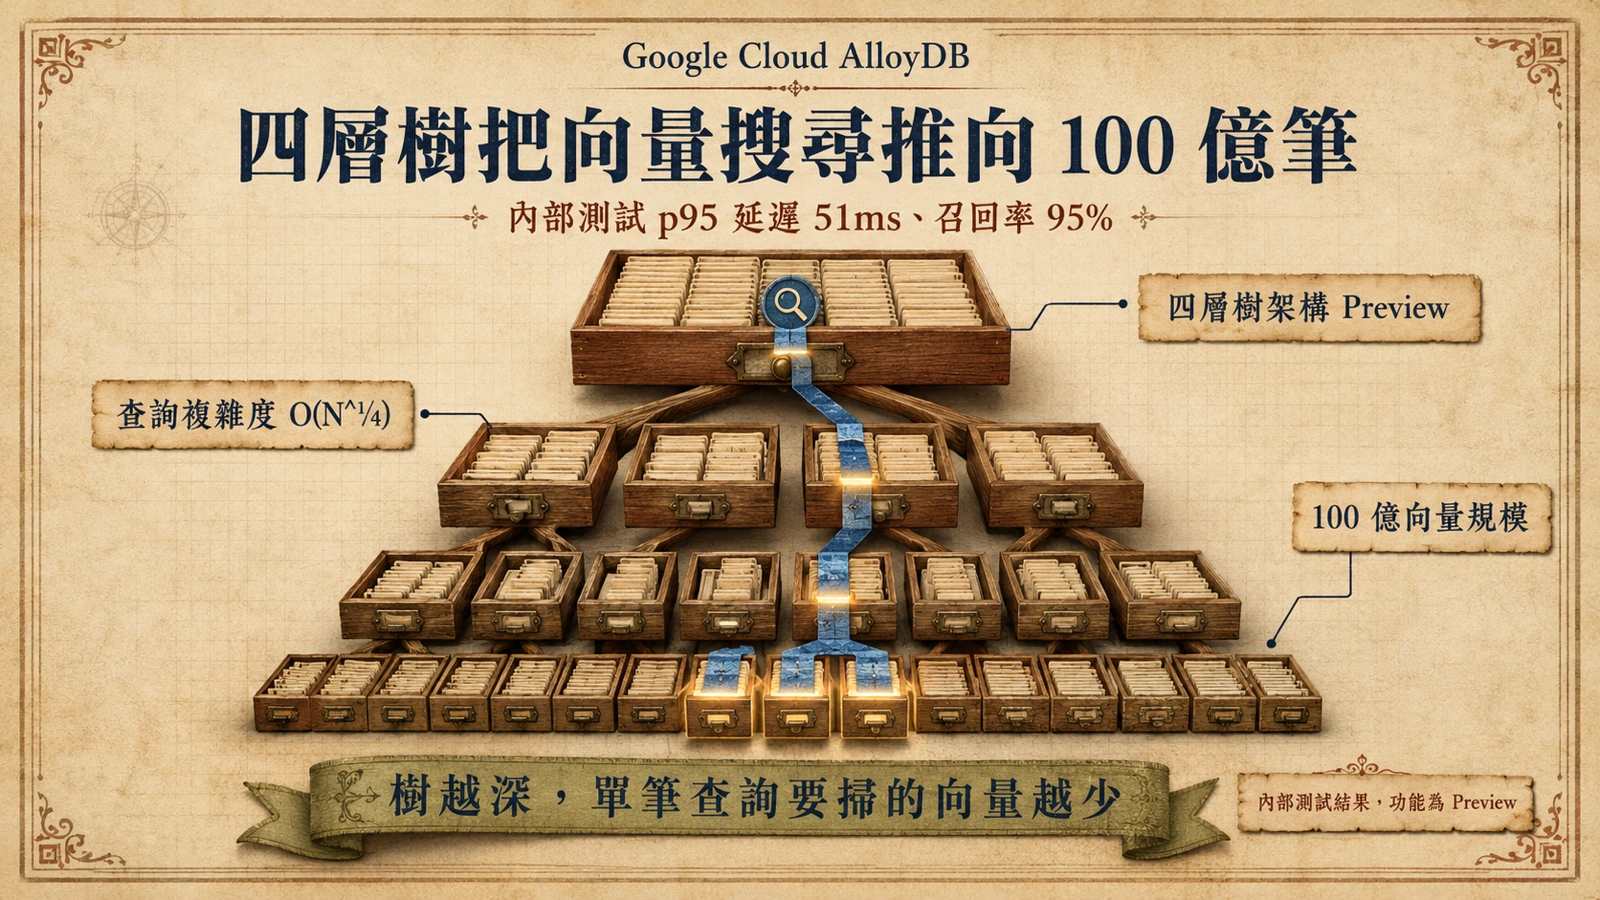
Google Cloud 在官方部落格宣布,AlloyDB 的 ScaNN 向量索引新增四層樹(four-level tree)架構,目前以預覽(Preview)形式提供。官方公告形容,新的四層樹讓 ScaNN 索引能在 100 億向量以上的規模有效率運作,目標是承接大規模 RAG 與 AI 應用的檢索工作負載。成效數字一併公布:Google 的內部測試在 100 億向量規模下,達到 p95 延遲不超過 51 毫秒、召回率 95%,公告並把這項改進的核心歸結為查詢複雜度從 O(N^1/2) 降到 O(N^1/4)。
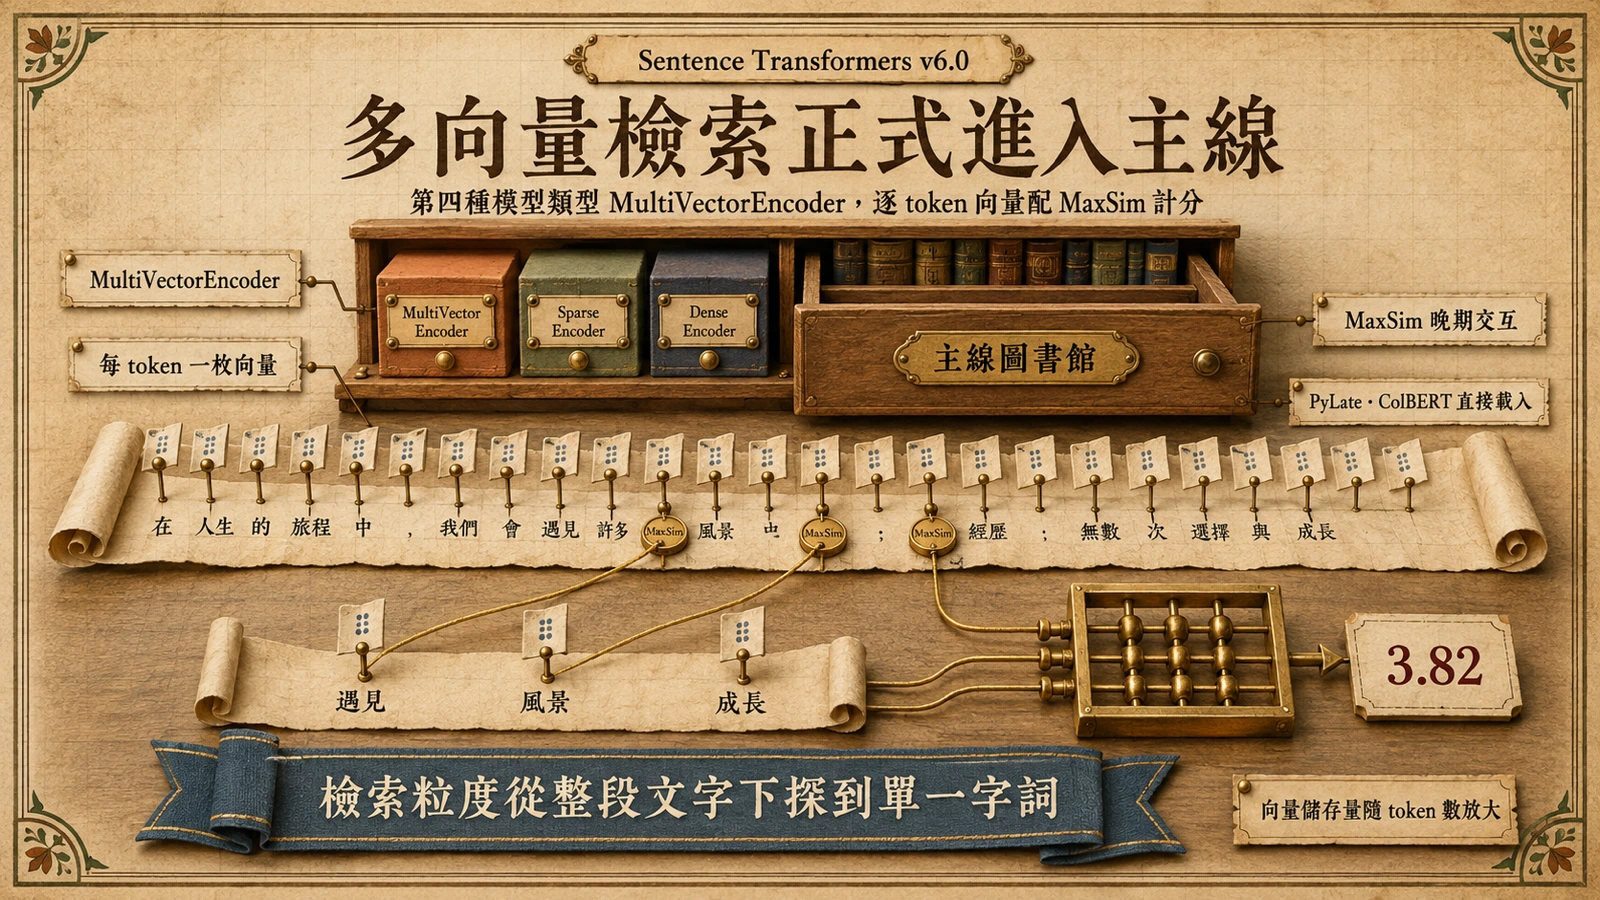
100 億向量是什麼概念?以常見的 768 維嵌入向量、float32 儲存換算,單一向量約 3 KB,100 億筆就是超過 30 TB 的原始向量資料,這還沒計入索引結構本身。檢索增強生成(RAG)流程把文件切成區塊、轉成嵌入向量存入資料庫,檢索時拿查詢向量比對相似度;語意搜尋、推薦與代理人記憶也都建立在同一類基礎設施上。若關注模型與檢索表示本身,可對照 Sentence Transformers v6.0 將 ColBERT 式多向量檢索納入核心介面;當資料量往百億筆走,「如何在可接受的延遲內找到夠準的答案」就從演算法問題升級為儲存與成本問題。
兩層樹換四層樹,查詢成本為什麼掉得快
ScaNN 屬於樹狀分群索引:先把整個向量空間用叢集中心(centroids)切成分群,再把分群繼續往下切,形成一層層的樹。查詢進來時,沿著距離最近的分支往下降,最後只在落入鄰近葉節點的向量裡做精算,而不是逐筆比對整座資料庫。這是近似最近鄰搜尋(ANN)以準確度換速度的基本套路,95% 召回率讓掉的正是那 5% 的誤差。
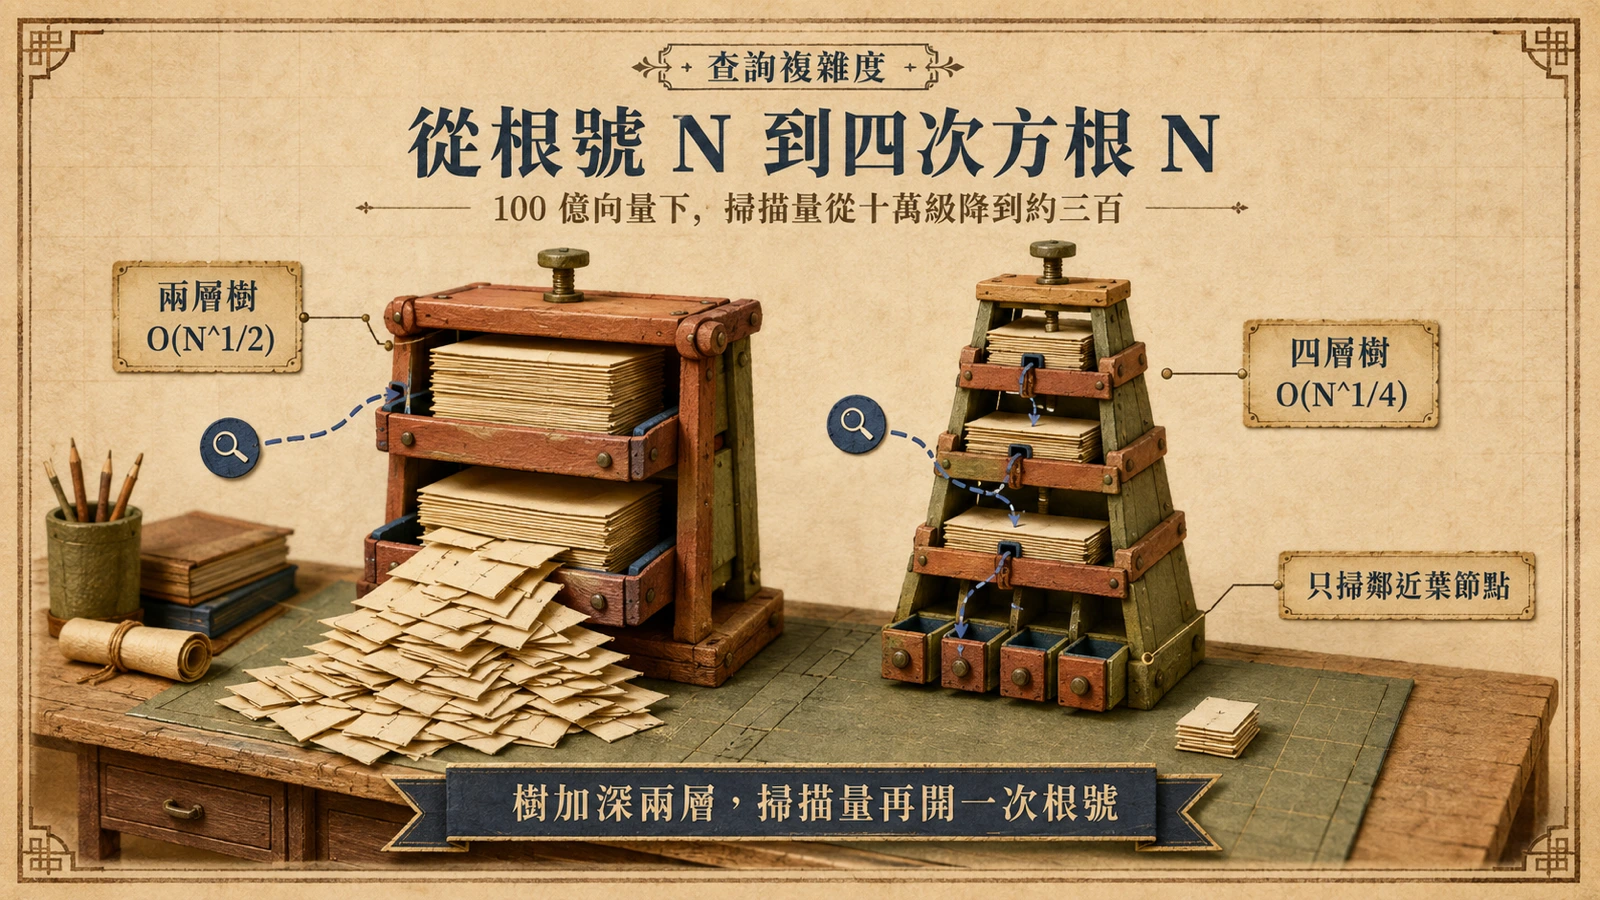
層數決定葉節點有多大。兩層樹時,N 筆向量分到各葉節點,單筆查詢要掃描的量級約是 N 的平方根;改成四層樹,葉節點再被切小兩級,掃描量級降到 N 的四次方根。以 100 億向量代入:平方根是 10 的 5 次方(十萬級),四次方根約 316——同一筆查詢要動到的向量,從十萬級掉到百級。這當然是複雜度數量級的直覺換算,實際延遲還取決於向量維度、篩選條件與硬體配置,但「樹加深、掃描變少」正是這次架構升級能撐住 100 億筆的關鍵機制。
量化壓縮:省記憶體與計算的第二根支柱
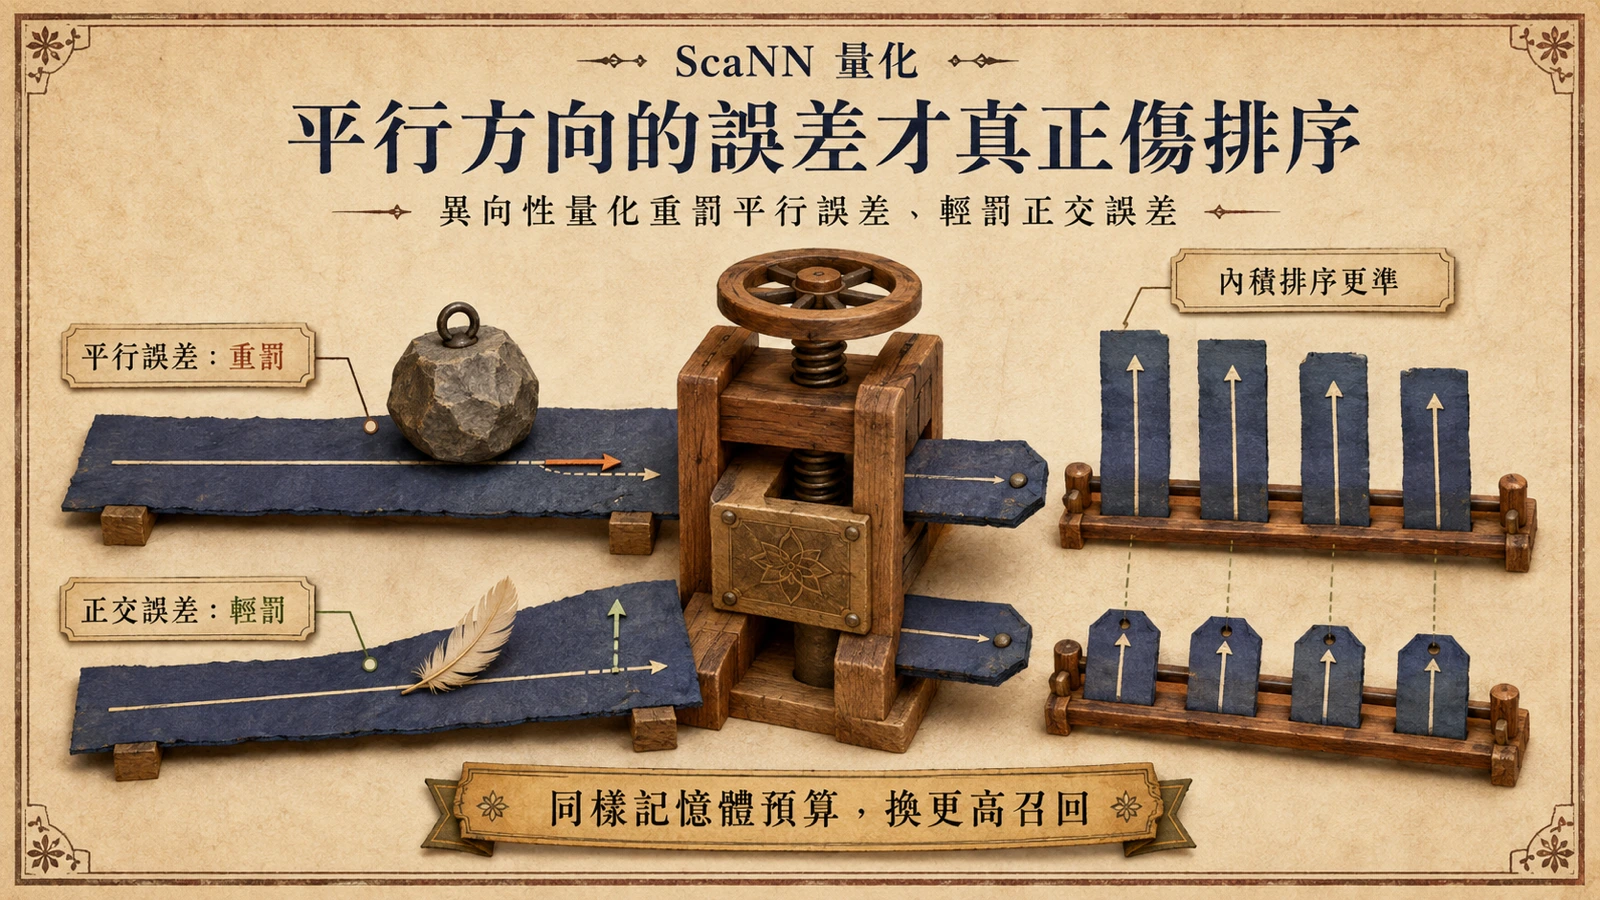
如果說四層樹解決的是「掃多少」,量化解決的則是「每掃一筆有多貴」。ScaNN 的技術根源,是 Google Research 團隊 2019 年的論文《Accelerating Large-Scale Inference with Anisotropic Vector Quantization》,摘要開宗明義:量化技術是把最大內積搜尋(MIPS)擴展到大規模資料庫的現階段最佳方法。
量化把每個向量壓縮成緊湊編碼,距離與內積的計算因此變輕、記憶體佔用跟著變小。這篇論文的關鍵洞見在於:量化誤差的傷害取決於方向。若誤差發生在平行於原向量的方向,會直接改變內積的大小,等於動搖排序本身;若誤差垂直於原向量,對內積的影響小得多。所謂異向性(anisotropic)損失函數,就是對平行誤差重罰、對正交誤差輕罰,讓同樣的記憶體與計算預算買到更高的搜尋準確度。樹狀分群負責把搜尋空間切小,量化負責讓切進來的每一步都便宜——兩者相加,才撐得起 100 億筆規模下的 51 毫秒。
樹狀索引對上 HNSW:分岔在哪
Postgres 生態最常見的向量索引,是 pgvector 提供的 HNSW——一種以鄰居邊層層相連的圖索引,查詢時在圖上貪婪遊走。ScaNN 走的是另一條路:不建圖,改用分群樹加量化。兩者在成本結構上明顯分岔:圖索引的邊與鄰居清單隨資料量線性膨脹,記憶體是主要瓶頸;樹狀索引配合量化壓縮,把單筆查詢的計算與儲存開銷一起壓低。
Google 給出的比較數據是建置速度:官方技術文章指出,AlloyDB AI 的 ScaNN 索引建置速度比標準 PostgreSQL 的 HNSW 快最多 8 倍。對需要重建或大量更新索引的場景,這是實際的營運差異。更重要的是,AlloyDB 本身是與 PostgreSQL 相容的託管資料庫,ScaNN 以擴充功能形式整合,應用程式仍以 SQL 操作向量欄位——對已投資 Postgres 技術棧的團隊,遷移成本遠低於另接一套專用向量資料庫。
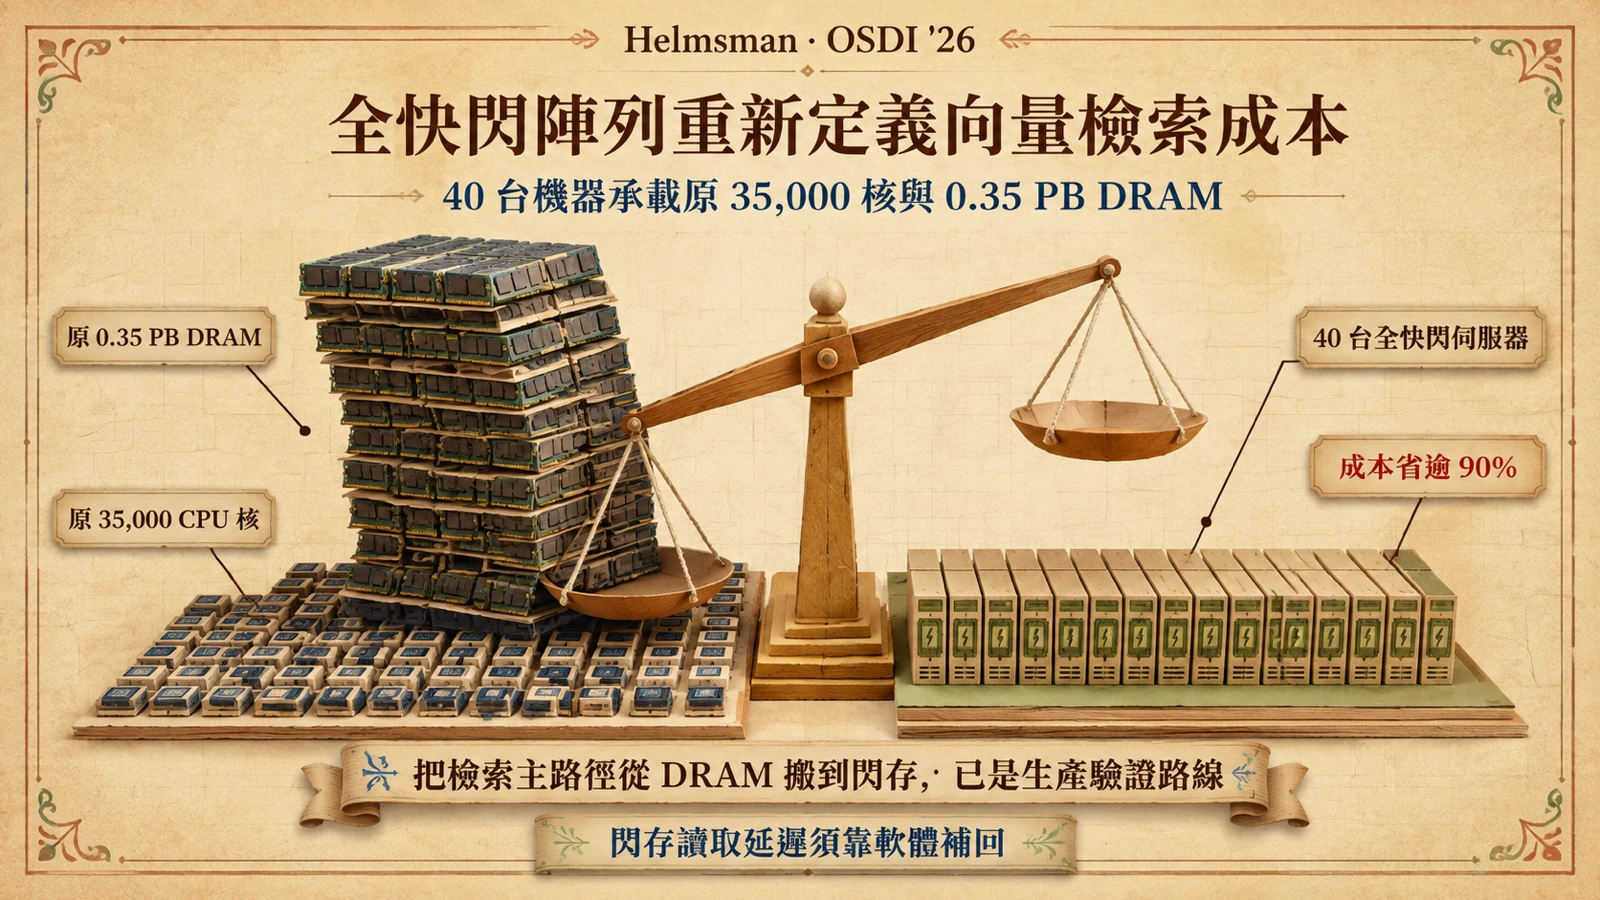
大規模向量檢索的記憶體成本問題,產業裡不只有一種解法。小紅書團隊在 OSDI ‘26 發表的 Helmsman 就選了另一條路:放棄記憶體內的 HNSW 圖索引,把檢索主路徑搬到全快閃儲存,用 40 台全快閃伺服器取代約 0.35 PB DRAM。雲端託管服務走「更深的樹加量化」、超大規模自建者走「儲存重構」,反映的是同一個壓力的兩種應對。
想先試的人:Preview 旗標與調校旋鈕
四層樹目前掛在 Preview 下,不是預設開啟。AlloyDB 的 ScaNN 調校指南說明,啟用 Preview 功能有兩種方法,其中之一是設定資料庫旗標 scann.enable_preview_features,之後才能建立四層的 ScaNN 索引。
索引建好後,最核心的調校旋鈕是 num_leaves_to_search:查詢時掃越多葉節點,召回率越高、延遲也越高;縮小它則換到速度。95% 召回率不是固定答案,而是延遲預算下的選擇——團隊該做的是用自己的資料與查詢分布,把召回率與延遲的取捨曲線量出來,再決定營運點落在哪裡。官方指南另提供量化器、訓練器與取樣上限等索引層級參數,對應不同資料分布與硬體配置,大規模部署前值得逐一掃過。
對 RAG 與企業檢索基礎架構的意義
對開發者與企業,這次升級的實際意義是:單一資料庫能撐的向量規模被往上推了一個數量級,而且是在 Postgres 相容的介面內完成。過去 100 億級的檢索需求,多半要考慮專用向量資料庫或自建叢集;現在留在 AlloyDB 內的選項變得具體——交易資料與向量放在同一個資料庫、共用同一套 SQL 與權限管理,少了跨系統同步的工程複雜度。
不過它改變的是規模上限,而不是選型問題的全部。多租戶隔離、跨區域複製、混合查詢(向量加結構化篩選)的成本,以及既有應用的遷移工程,仍要按各自情境評估。對已經在 Google Cloud 上跑 AlloyDB 的團隊,開旗標、建索引、量測召回率曲線是門檻最低的下一步;對其他人,這則是一個值得寫進評估清單的新基準點。
限制與待驗證之處
必須先說清楚:51 毫秒與 95% 召回率是 Google 的內部測試結果,不是第三方評測,也還沒有可供外人重現的完整基準設定——向量維度、資料分布、並發量、篩選條件與機器規格都未在公告中完整揭露。延遲與召回率高度依賴工作負載,直接把這組數字寫進服務水準協議之前,應自行驗證。
其次,Preview 意味著行為與參數仍可能變動,放進生產環境前需衡量風險;官方也尚未公布 100 億規模下的索引建置時間與記憶體佔用,而這兩項正是大型部署的成本關鍵。值得追蹤的後續指標包括:正式版(GA)時程與功能差異、與專用向量資料庫的獨立橫向評測,以及實際客戶在混合查詢場景下的公開數據。在這些資訊補齊之前,把它視為「規模上限被推高」的方向訊號,會比視為已定案的效能結論更穩健。