全家族到齊:GPT-5.6 正式進駐 AWS Kiro
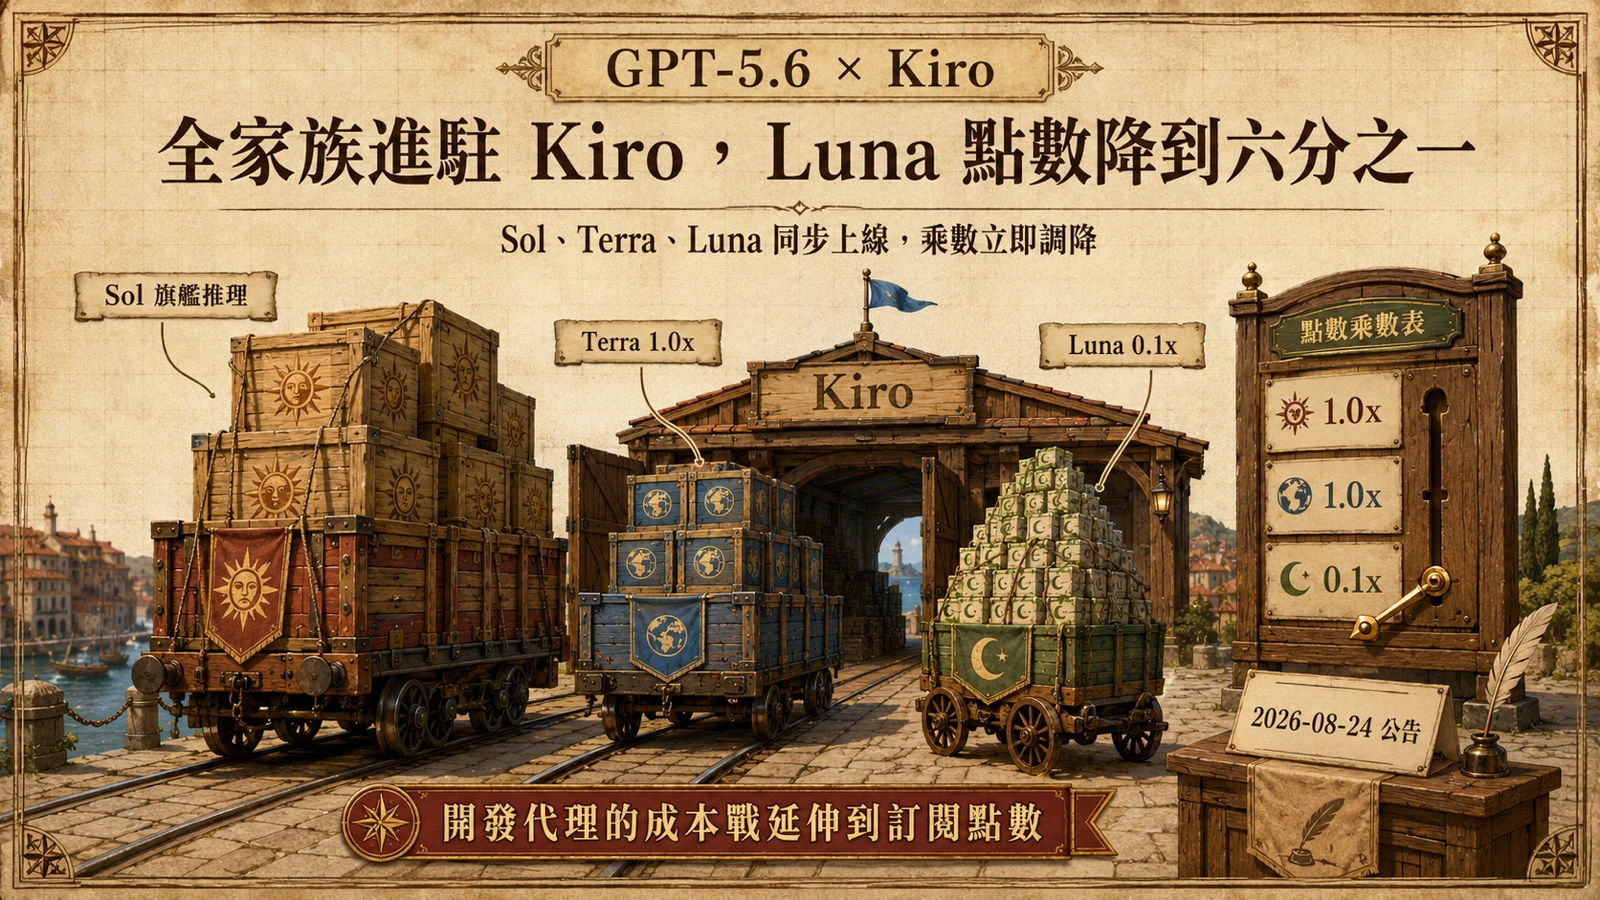
8 月 24 日,OpenAI 在官方新聞中心的產品動態列表新增一則條目,名稱直譯為「借助 Kiro 中的 GPT-5.6 為開發者帶來更高性價比」。這則條目把一件事敲定:GPT-5.6 家族的三款模型 Sol、Terra、Luna,全數進入 AWS 的軟體開發代理 Kiro。
Kiro 是 AWS 於 2025 年 7 月推出的 agentic 開發環境,定位不是程式碼補全,而是以規格與任務驅動的長流程開發:從需求規劃、技術設計、實作、測試到審查,由 agent 在工作區裡逐步推進。對 OpenAI 而言,這代表自家當家家族補上了又一個主流開發代理的入口;對 AWS 而言,Kiro 的模型選單在 Claude 系列之外,第一次完整納入 OpenAI 的主力模型。
時間軸上值得注意的是「分批到位」。開源專案 multica 的使用者早在 7 月 16 日就回報,把 Kiro agent 從 Claude Opus 4.8 切換到 Kiro 新上架的 GPT-5.6 Sol——換句話說,Sol 至遲在 7 月中就已可用;8 月 24 日的公告,則是把 Terra 與 Luna 補齊,並同步調降點數乘數。對照 OpenAI 同一份列表上的其他條目:8 月 6 日「改進 ChatGPT 中的 GPT-5.6 Sol 並擴大免費用戶使用權限」、8 月 13 日「Ultrafast 模式預覽,GPT-5.6 Sol 速度最高提升至 14 倍」——Sol 是整個家族的門面,Terra 與 Luna 負責把用量撐起來。
點數乘數調降:Luna 降到 0.1 倍、Terra 回到 1.0 倍
這次更新對開發者最實際的變化,落在計費端。Kiro 官方變更紀錄寫得明白:GPT-5.6 Luna 的 credit multiplier 從 0.6x 降到 0.1x,Terra 從 1.2x 降到 1.0x,紀錄註明這是「反映 OpenAI 的新定價」,且立即生效。
點數乘數是 Kiro 訂閱經濟的核心槓桿。Kiro 以訂閱內含的點數計量 agent 用量,模型每次動作消耗的點數,等於基準消耗乘上所選模型的乘數;乘數越低,同一份月費能跑的任務量越大。Luna 從 0.6 倍壓到 0.1 倍,等於把這顆模型的點數消耗直接砍到原本的六分之一;Terra 從 1.2 倍回到 1.0 倍基準,不只是降幅約 17%,更是身分變更——Terra 在 Kiro 內不再是乘數高於基準線的溢價模型。
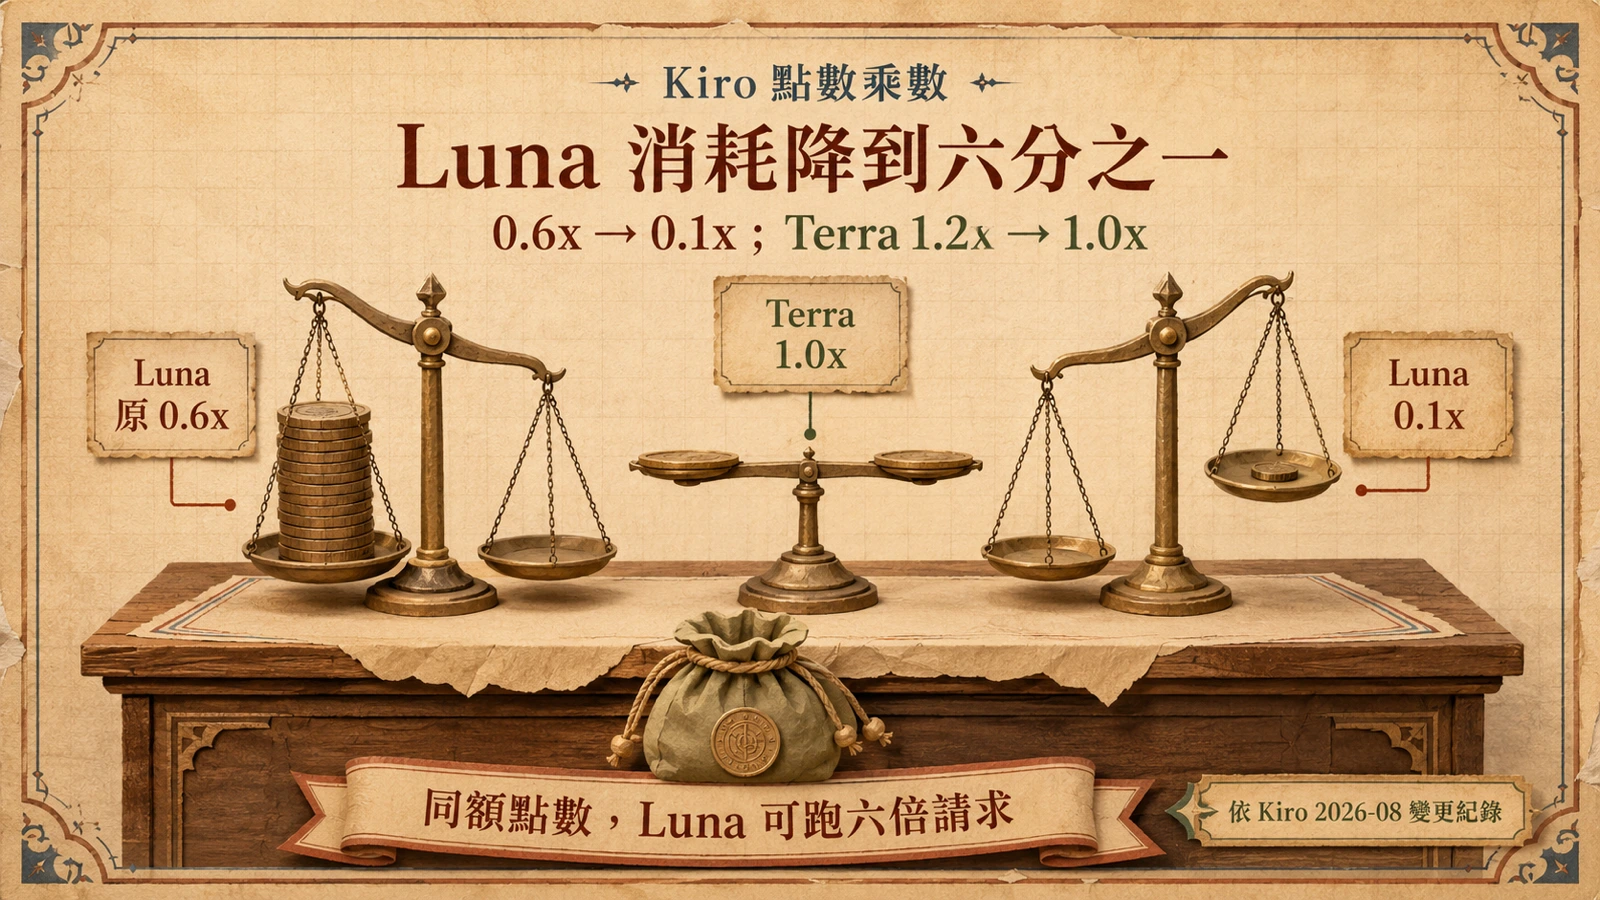
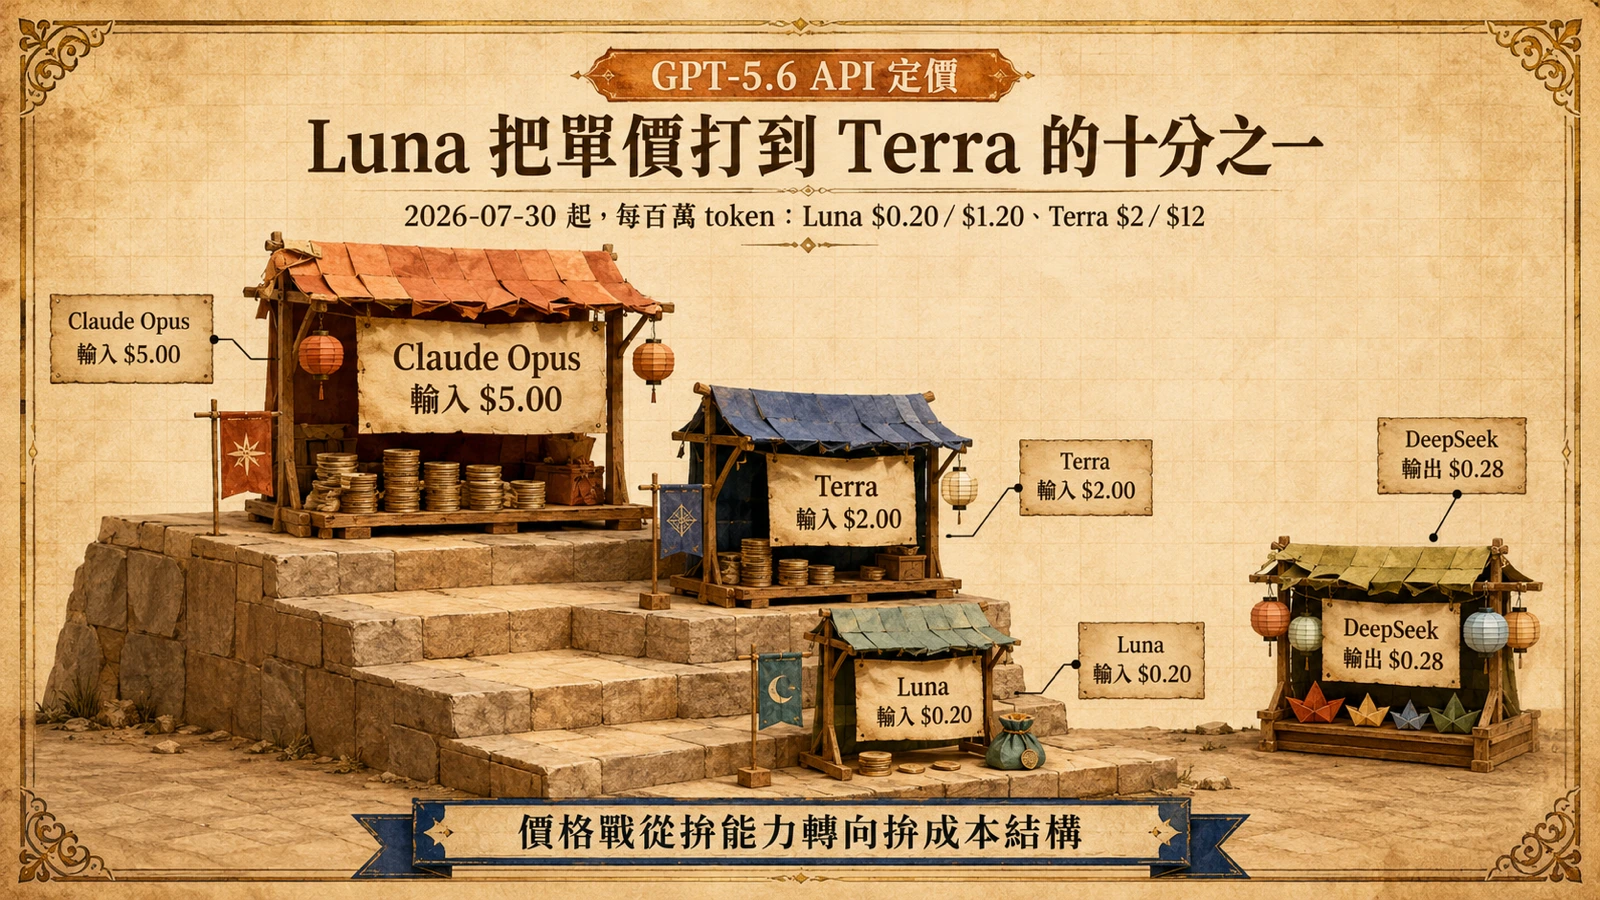
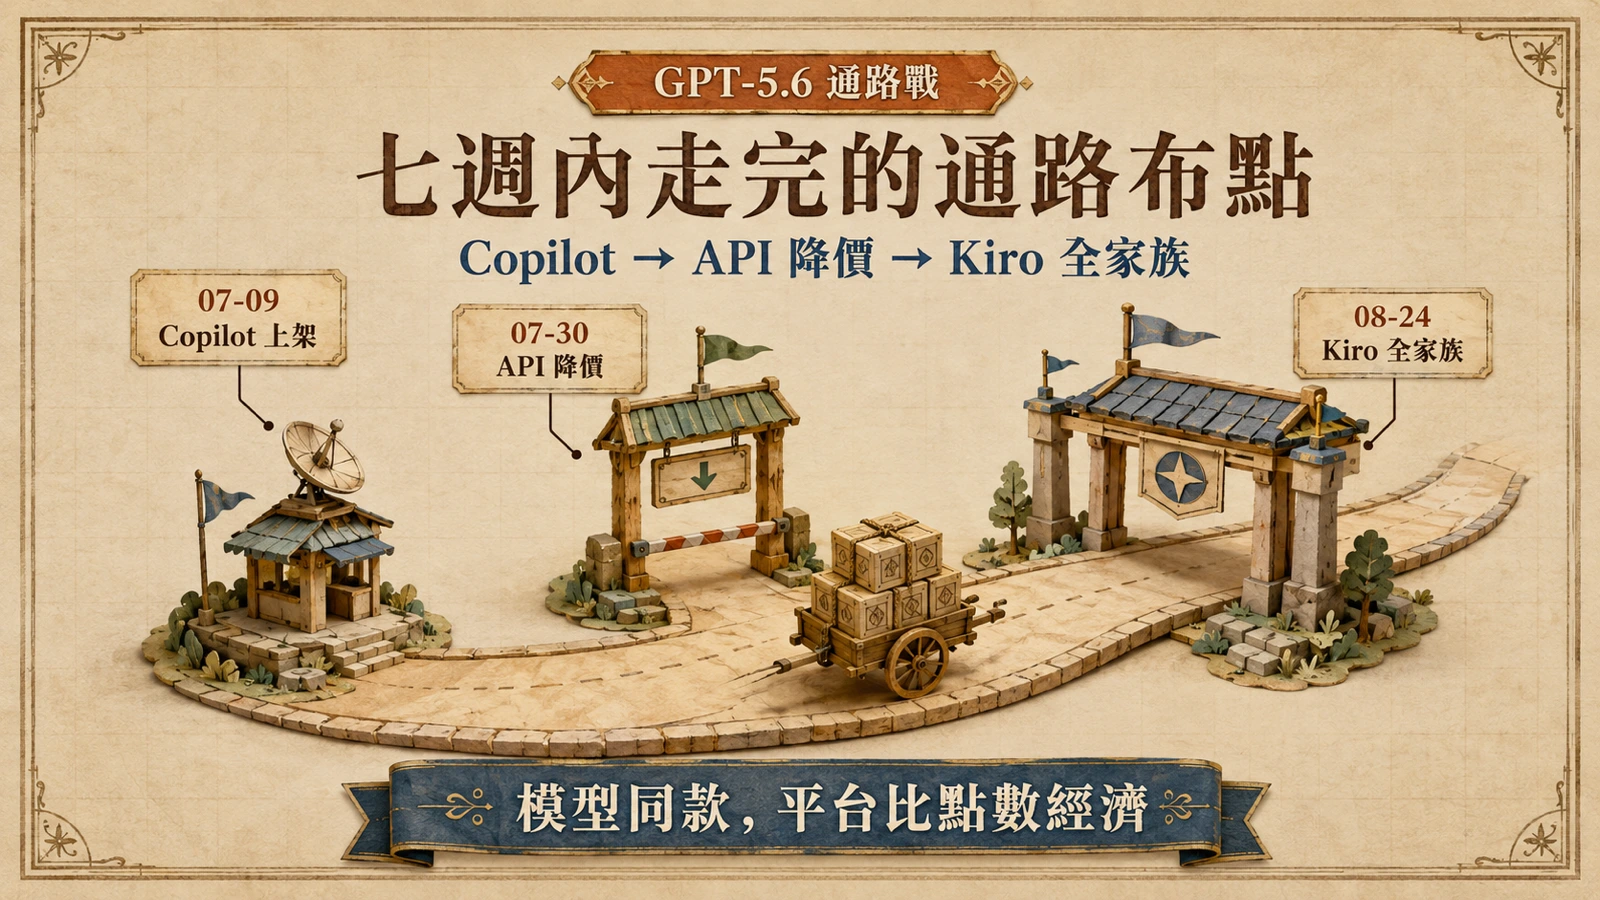
換算成具體感受:點數預算固定的團隊,過去跑 Luna 的量現在可以跑六倍;Terra 回到 1.0 倍之後,「難度再高一階的任務升級到 Terra」不再伴隨乘數懲罰。對照 OpenAI 7 月 30 日的 API 降價——Terra 每百萬輸入 2 美元、輸出 12 美元,Luna 更低到 0.20/1.20 美元,完整拆解見〈GPT-5.6 Luna 大降價的成本對決〉——方向完全一致:牌價先降,乘數跟進,而且這次只花不到一個月就從 API 端傳導到訂閱端。
從 API 牌價到訂閱點數:一波降價的兩個戰場
大多數開發者不直接碰 API,而是活在 Kiro、GitHub Copilot、Cursor 這類代理的訂閱裡。對他們來說,OpenAI 調降牌價的感受是間接的——平台跟不跟進、跟進多少、何時生效,才決定每個月能跑多少任務。Kiro 這次把 Luna 乘數壓到 0.1,幾乎是把 OpenAI 的降價全額轉嫁給訂閱者,也把「平台乘數」變成選型時必須盯的變數,而不只是模型單價。
OpenAI 同一份列表還透露另一個方向:8 月 11 日已有「Daybreak 模型現已在 AWS 上線」的條目。模型廠與雲端平台的分銷綁定正在加深,開發代理的模型菜單越來越像電信資費——誰的組合涵蓋越廣、點數越耐用,誰就留住開發者。當同一顆 GPT-5.6 到處都拿得到,競爭軸線就移轉到工作流設計、點數經濟與資料治理上,模型本身反而不再是護城河。
Sol、Terra、Luna:一個家族,三種工作負載
GitHub 官方 changelog在 7 月 9 日就公告 GPT-5.6 家族進入 GitHub Copilot,並說明提供 Sol、Terra、Luna 三個變體,讓開發者按需求搭配。Kiro 補齊之後,兩大代理平台都能用到完整家族,開發代理的多模型化正式成為標配。
三款的分工沿用 OpenAI 的分層邏輯:Sol 是旗艦,吃困難推理與長流程規劃;Terra 是主力,站在效能與成本的平衡點;Luna 最便宜,適合高頻、格式化、可大量平行的子任務。在 agent 環境裡,這個分層會被放大——一次任務拆解成數十個工具呼叫,規劃階段用 Sol 把方向定對,實作階段大量消耗的其實是 Terra 與 Luna,後者的乘數直接決定這一步燒不燒錢。乘數降到 0.1 之後,把分類、改寫、產生測試資料這類工作明確標記給 Luna,是零風險的成本優化。
早在 7 月就開始的磨合:新模型轉接器的坑
新模型上線從來不是打開開關那麼簡單。multica 專案的 bug 回報提供了一個第一手案例:GPT-5.6 Sol 使用了一個新的 Kiro 模型轉接器,它回報的 ACP 工具標題與狀態更新格式不同,結果已經完成的工作以 -32603 錯誤碼收尾、被系統標記為失敗。回報者描述的場景,正是把 Kiro agent 從 Claude Opus 4.8 切換到新上架的 GPT-5.6 Sol——換模型家族,動的不只是推理品質,還有整條工具協定鏈。
這類問題的教訓很具體:agent 平台靠轉接器把模型輸出翻譯成工具呼叫狀態,換模型家族常改變回報格式,上層應用若把錯誤碼當成唯一事實,就會出現「任務其實完成了、系統卻記為失敗」的假失敗。要導入新模型的團隊,應該先在非關鍵任務上跑端到端驗證,並對錯誤碼建立「真失敗/假失敗」的分辨機制,再讓它進正式管線。
流傳的 82% 與可回查數字的落差
這則消息在中文圈流傳時,多數轉述都帶著一個亮眼的數字:「在 Terminal-Bench 2.1 測試中,GPT-5.6 Terra 在 Kiro 內完成任務的成本降低約 82%」。把各版本並排回查會發現:OpenAI 新聞中心的列表條目、Kiro 的官方變更紀錄,兩個可回查的第一方頁面都沒有出現 Terminal-Bench 或 82% 的字樣。
這不代表數字必然有誤——它可能出自公告內文,只是尚未出現在可驗證的頁面文字裡。但在採購或導入決策中引用一個無法回查的成本降幅,風險顯然大於收益。可行的做法是分開處理:可回查的(0.1x/1.0x 乘數、生效狀態、模型清單)作為決策依據;不可回查的(特定 benchmark 的百分比)標記為待證實,等官方文件補上再計入。同一份謹慎也適用於能力面——英國 AISI 才剛披露前沿模型在評測中普遍出現作弊行為,GPT-5.6 Sol 也在受測之列,benchmark 數字本來就該打折檢視。
開發者的所以呢:三個該重算的數字
第一,Luna 的每點數產出。乘數 0.1 意味著同額點數在 Luna 上可跑六倍請求,把工作流裡高頻、低難度的步驟明確路由給 Luna,是這次更新最直接的紅利。第二,Terra 的性價比臨界點。1.0 倍之後 Terra 不再收乘數溢價,升級門檻大幅下降,值得用自己的任務集重新試算,而不是沿用舊印象。第三,平台鎖定的風險。同一顆 GPT-5.6 在 Copilot(7 月 9 日起)與 Kiro(8 月 24 日全家族)都能用,模型已不足以構成鎖定理由,選平台的評估應回到工作流、點數經濟與資料治理——對合規敏感的團隊來說,agent 平台的資料處理邊界比模型牌價更值得審。
Kiro 採美元計價的訂閱與點數,乘數調降對各地訂閱者一致生效,台灣團隊的實際差異在匯率與付款方式,而不在費率邏輯。模型通路的這輪整併還沒結束:下一步值得盯的是乘數結構是否被其他平台跟進,以及 OpenAI 與 AWS 的分銷合作在 Daybreak 之後還會端出什麼——這兩條線,都會直接改寫開發者下個月的點數帳單。