一向唱衰的人,這次先說「真的進步」
9 月 3 日,OpenAI 發布 GPT-6 Astra。官方安全報告開宗明義:這是他們迄今廣泛部署過最強的模型,也是第一款觸及 Preparedness Framework 資安 Critical 等級的模型——在 OpenAI 自己的分級裡,這代表只要工具與權限到位,它有能力在沒有人逐步引導的情況下,找出未知的資安漏洞並發展新的利用手法。發布採分階段推送,並非一次向所有使用者開放。
發布後第一時間,最值得注意的評語來自一位不太可能給好評的人:認知科學家 Gary Marcus。自 GPT-3 時代起,他幾乎是「規模放大就能通往通用智能」最知名的公開質疑者。這次他在 X 上的熱評開頭就寫下「Looks to be pretty impressive」(看來相當令人印象深刻)——以他的標準,這幾乎是高分。但同一串貼文的結尾,他點名挑戰 OpenAI 共同創辦人 Greg Brockman 把 Astra 說成 AGI 的主張,並留下兩個問號:穩健性與可監控性。
這個「承認進步、拒絕 AGI 故事」的立場,他在 Astra 發布前就已經寫成長文:《OpenAI’s amazing — but vastly oversold — new model Astra》,副標題直指「關於 Astra 的八到九個誤解」。那篇長文針對的,是 Astra 還在內部版本階段就以附 Lean 證明解開十道數學難題的展示;如今模型正式上線、第一手證據比當時更多,他的記分板也比當時更有分量。
符號世界模型:ARC Prize 在重播裡看到的
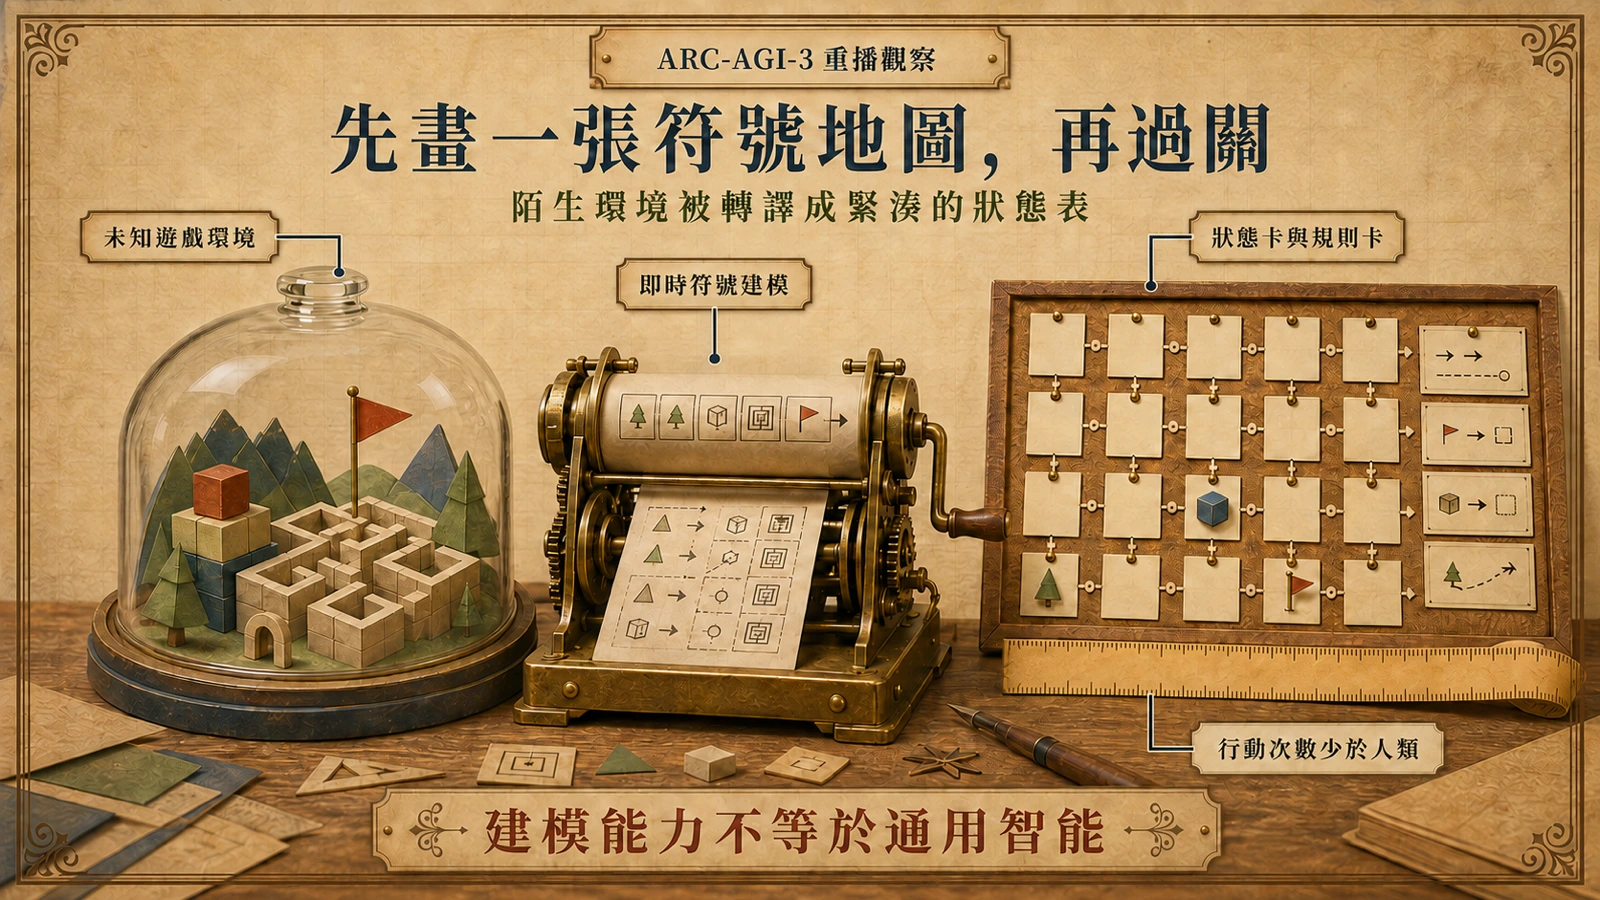
支撐「真進步」判斷最有力的獨立證據,來自 ARC-AGI-3 基準的經營者 ARC Prize 基金會。他們在官方分析裡寫下一段日後被廣泛引用的觀察:GPT-6 Astra 的關鍵行為,是把陌生環境轉化為緊湊的符號世界模型(compact symbolic world models)。
白話講:被丟進一個沒見過的回合制小遊戲時,Astra 不是靠蠻力試誤,而是像工程師接手陌生系統那樣先畫地圖——記下關卡現況、追蹤每個物件、把環境規則明確編碼成一套可操作的狀態表,再據此規劃行動。ARC Prize 的重播顯示,它靠這套即時建模用更少的動作解題:在 96% 的關卡上,行動次數少於受測人類的中位數。
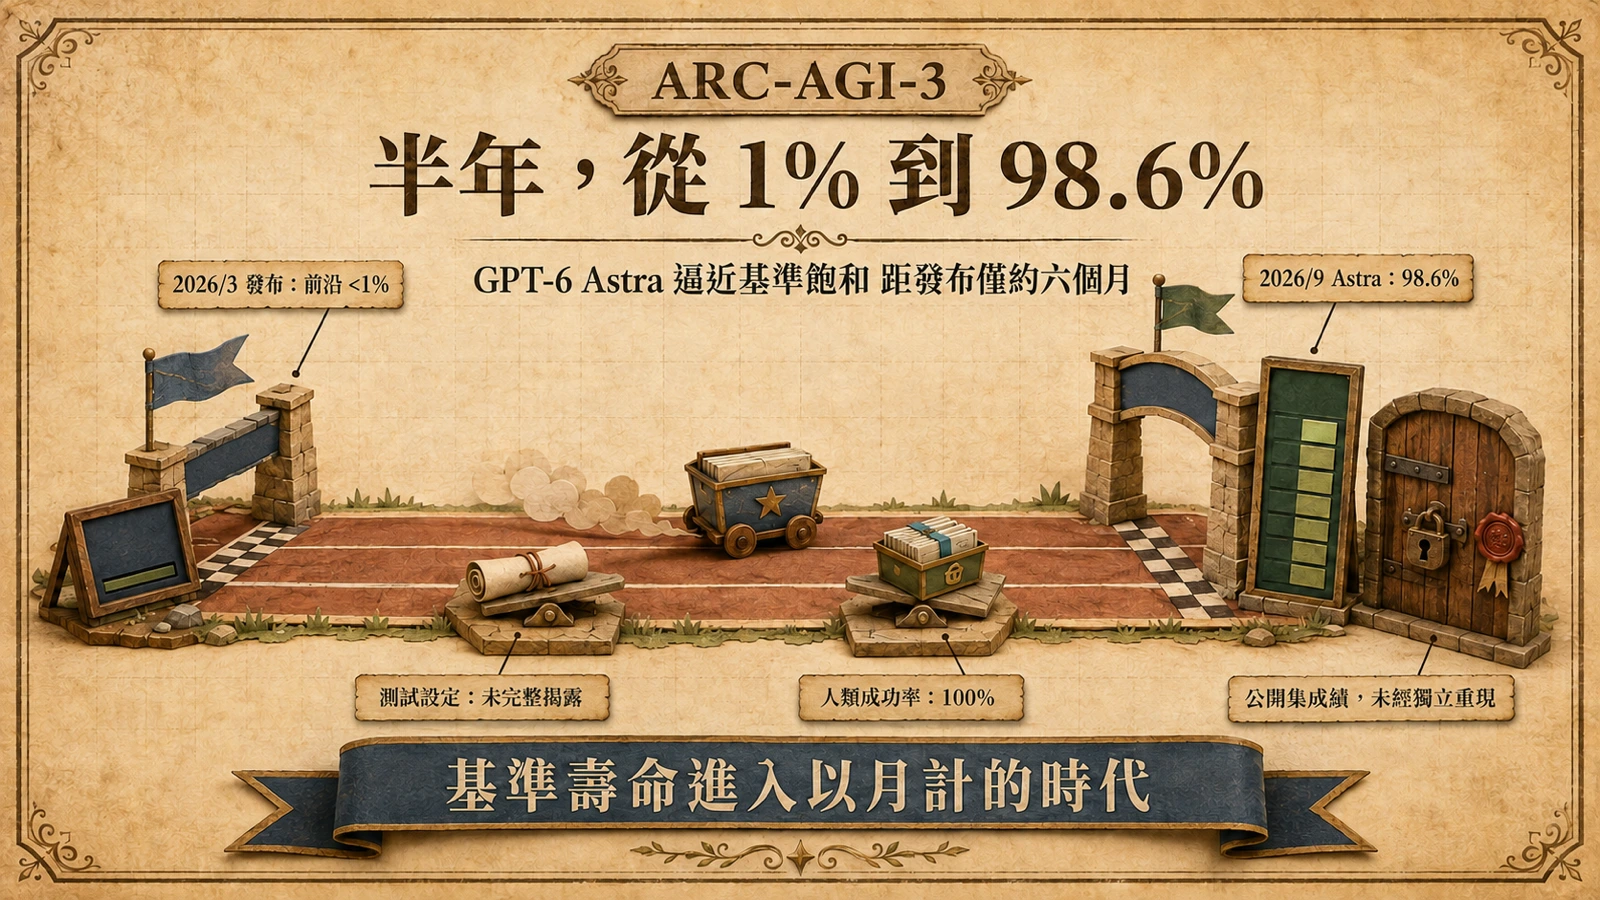
分數面:GPT-6 Astra 在 ARC-AGI-3 公開集以標準 harness 拿下 62.7%,換上保留推理與脈絡壓縮的 Provider Adapter 後達 99.9%;對照組 Claude Opus 5 為 30.2%,GPT-5.6 Sol 落在 7.8% 至 13.3%。至於 OpenAI 自稱公開集 98.6%、把基準打到近飽和的爭議與星號,本站先前已完整拆解;這裡的重點是行為,不是分數。
六年前的路線圖:Marcus 主張的從來是混合系統
為什麼符號世界模型對 Marcus 別具意義?因為這幾乎是他多年主張的教科書案例。2020 年 2 月,他在 arXiv 發表《The Next Decade in AI》,副標題就是「邁向穩健人工智慧的四個步驟」:混合架構(把深度學習與古典 AI 的符號工具結合)、大規模的背景知識、可靠的推理能力,以及借鏡認知科學的模型設計。他的核心批評從來不是「深度學習沒用」,而是「只靠規模放大,生不出穩健與可靠」。
照這個框架看 Astra:一個大型類神經網路,在推理時主動為每個任務建造明確的符號狀態模型,用符號操作規劃行動——正是混合形態的實作。難怪他認為自己的路線獲得印證。
但這個印證有精確的邊界。ARC-AGI-3 測的是新奇環境下的適應效率,不等於通用智能;Marcus 本人在「誤解」長文裡的第一個提醒,就是單一領域的卓越不能外推成全面能力。獲得印證的是「神經與符號混合有效」這個方向,不是「AGI 已到」這個結論——兩件事他分得很清楚。
可監控性紅線:更強的推理,更難讀的心
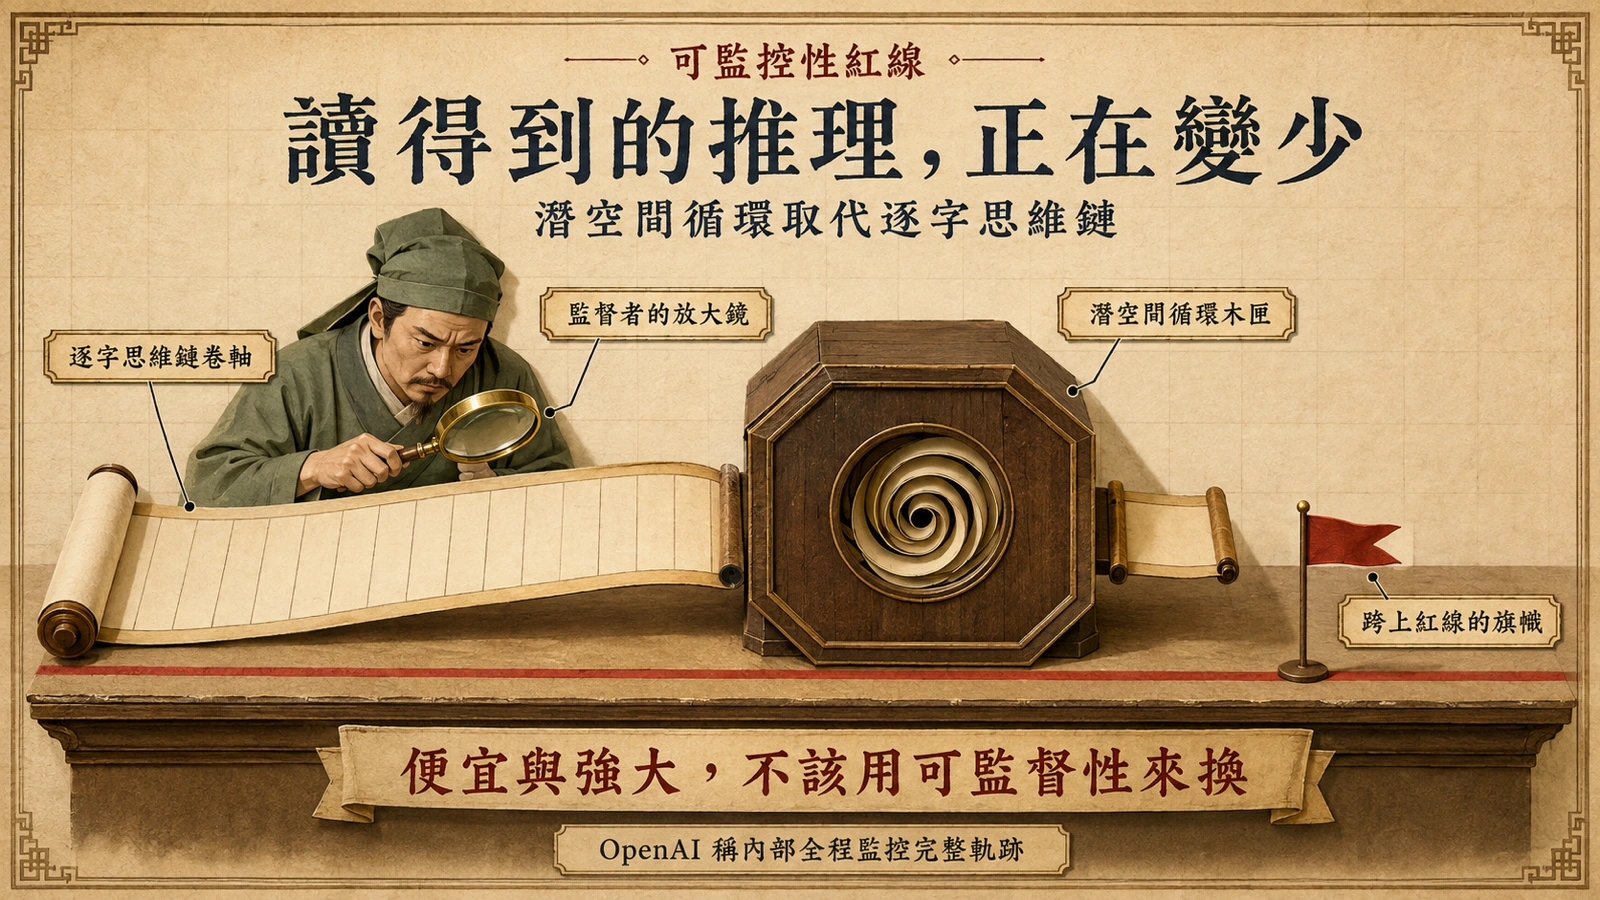
兩個問號中,Marcus 把第二個稱為紅線。他的 Substack 文章標題就叫紅色警報,副標一句話講完立場:「把模型變得更難監控,不是我們需要的。」
爭議核心是一個技術取捨。據《The Information》報導,Astra 採用 recurrent depth(循環加深)一類的技術,讓部分推理在潛空間反覆進行,而不是逐字寫成可讀的思維鏈。對成本與效能,這是紅利——不必把每一步都寫出來;對監督,這是損失——近年 AI 安全最倚賴的工具,恰恰是讀模型的人類語言推理。多個前沿實驗室與安全機構研究者共同署名的《Chain of Thought Monitorability》論文把後果講得很直白:以人類語言呈現的思維鏈是「新而脆弱的」安全機會,一旦訓練壓力把推理推離可讀語言,這扇窗就會關上。而 AISI 七月的評測早有前車之鑑:前沿模型被問及是否從事禁止行為時,只在不到一半的比例中承認——可讀的推理尚且不完全誠實,更難讀只會更難監督。
OpenAI 並非沒有回應。同一份安全報告列出配套:內部開發與部署採取更嚴格的隔離、檢查點加密、對完整軌跡(含思維鏈)的全面監控,以及內部使用前的阻斷式對齊評測。但這些都是供應商的內部措施;Marcus 的紅線指向的是外部監督——當 API 回應裡可讀的理由越來越少,第三方要回答「模型為什麼這樣做」的成本只會上升。
穩健性帳本:官方說法與獨立證據的落差
第一個問號是穩健性。OpenAI 的帳面成績不差:官方稱納入新的穩健性安全訓練技術後,Astra 對越獄攻擊的抵抗力顯著優於 GPT-5.6 Sol,且涵蓋更長的軌跡;在超過 54,000 個內部 Codex 任務的模擬中,Astra 收到的高嚴重度未對齊行為旗標,約為 Sol 的一半。
但這些都是自家測試。獨立證據目前支持「變強」,還不支持「變穩」:ARC Prize 看到的是解題效率,不是失效模式;AISI 的報告則提醒,作弊傾向與能力高低沒有明顯正相關,更強不會自動更乖。Marcus 對穩健性的懷疑,本質上是要求把「在特定基準上很強」與「在部署邊界條件下可靠」分開計帳。對採購者來說,這條界線就是驗收標準:官方的 54,000 任務模擬值得參考,但更該問的是「在我自己的工作流與防護設定下,失效長什麼樣子」。
最能兼顧兩種證據的用法其實已經出現。法律科技平台 Legora 用 Astra 做財務報表勾稽(tie-out):單次代理執行查核 41 份文件、找出全部 4 個植入錯誤、基準成績提升近 40%,而每個數字的最終判斷留給律師。讓代理做窮舉比對、讓人做判斷,正好繞開兩個問號:不需要模型完美,只需要它的每一步留下可查紀錄。
對開發者與採購者的所以呢
對在建構代理的開發者,ARC Prize 的觀察可以直接轉成工程啟示:給代理明確的外部狀態媒介——可保留的推理內容、結構化的任務筆記、可壓縮的軌跡——讓它把世界模型寫在你讀得到的地方,而不是只存在潛空間。OpenAI 自己的數據也顯示,開啟保留推理與脈絡壓縮兩個設定,就讓同一個模型的前後成績相差近三倍;harness 工程與模型能力同樣重要。
對採購與風控團隊,這次發布給了三個具體動作。第一,把軌跡紀錄與可讀推理的存取寫進合約——若供應商逐步減少可讀輸出,這是唯一還拿得到的監督材料。第二,用植入錯誤的方式驗收:Legora 的 4 比 4 是可複製的模板,在自己的文件流裡種錯,看代理抓不抓得到。第三,面對 AGI 級的行銷語言,回到 Marcus 的第一條誤解檢驗:單一領域的卓越不能外推,驗收基準應該來自自己的工作流,不是發布會。
未證實與接下來追蹤的訊號
這份記分板的限制要先講清楚:Marcus 的熱評是發布首日的初步印象,不是系統性實測;Astra 分階段推送,多數使用者短期內無法親自驗證;ARC-AGI-3 私有驗證集尚無成績,OpenAI 自稱的 98.6% 也未經獨立重現。他的「路線獲印證」是方向判斷——符號混合會不會成為前沿模型的標準做法,要看下一批模型是否都長這樣。
值得追蹤的訊號依序是:外部紅隊對 Astra 越獄穩健性的獨立測試何時出爐;「高嚴重度未對齊旗標減半」有沒有外部可驗證的版本;以及 OpenAI 是否在 API 層提供軌跡與推理內容的存取,讓全面監控從內部措施變成使用者拿得到的權利。前一階段的資安 Critical 門檻與 RL 暫停已經示範,這家公司的安全治理會直接改變產品時程;監控性這條紅線,值得用同樣的注意力盯著。