先挑模型:GPT-5.6 Sol 與 Kimi K3 各代表什麼
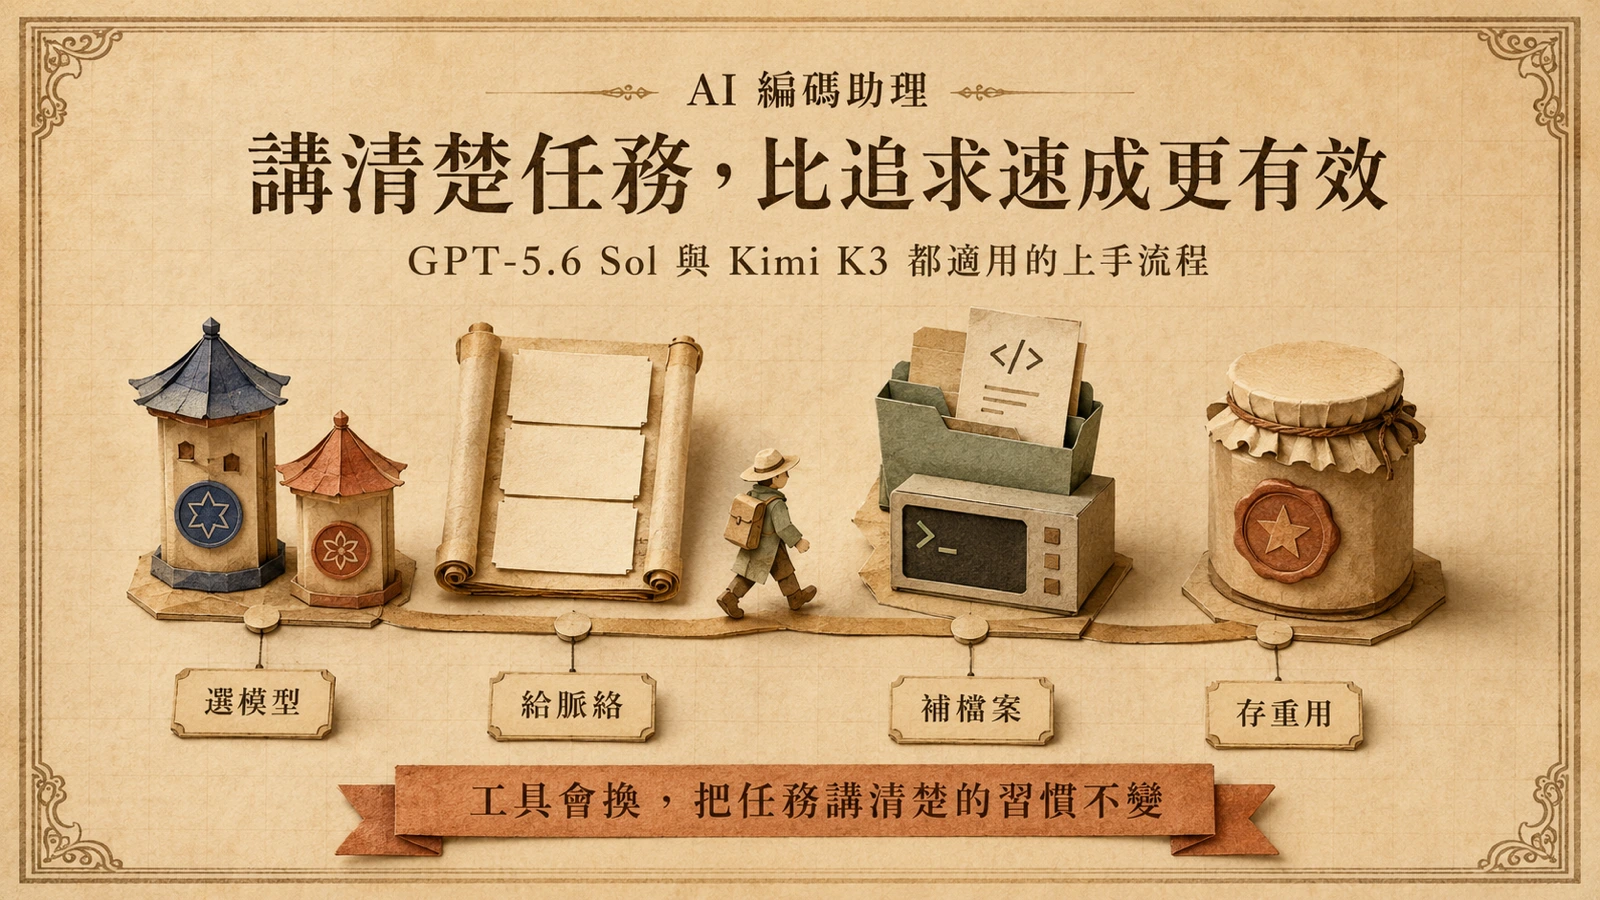
開始用 AI 之前,第一個該決定的不是學哪個工具,而是用哪個模型。模型決定你能解多難的問題、一次能讀多少資料,以及每一輪要花多少錢。對寫程式與代理任務,目前兩個值得新手認識的前沿選項,剛好代表兩種取得方式。
第一個是 OpenAI 的 GPT-5.6 Sol。GPT-5.6 是一個模型家族,依官方公告分為三個持久層級:Sol 是旗艦,主打最高智力與效率;Terra 是成本較低、表現接近前代 GPT-5.5 的均衡層;Luna 則是最快、最便宜的層級,這三層的定位見 GPT-5.6 官方公告。新手若預算允許、想一次到位,Sol 是最穩的選擇;若只是跑大量重複的小任務,Terra 或 Luna 更划算。挑選時先問自己:這個任務需要多強的推理?會跑幾次?答案決定你該不該為旗艦層付費。
第二個是月之暗面(Moonshot AI)的 Kimi K3。官方把它定位為「面向長程編碼與端到端知識工作的旗艦模型」,擁有 2.8 兆參數與 1M token 上下文,支援視覺理解與思考模式,並明確標示適合接進 Claude Code 這類編碼代理。它與 Sol 的關鍵差別在取得方式:GPT-5.6 透過 ChatGPT 與 OpenAI API 提供,Kimi K3 透過 Kimi 開放平台的 API 提供,兩者計費與生態不同,但都能驅動同一類編碼代理工作流。已在 OpenAI 生態的人順著用 GPT-5.6 最省事;想用開放 API 自建流程、或同時處理大量中文長文件,Kimi K3 是值得評估的另一條路。
再挑工具:ChatGPT 訂閱等級與 Codex CLI 怎麼選
模型選好,下一步是把它裝進一個你願意每天打開的工具裡,見〈開源工作區 OpenChamber〉。對多數新手,摩擦最低的路線是 ChatGPT 訂閱;對想把 AI 放進終端機、直接在自己專案裡做事的人,則是 OpenAI 開源的 Codex CLI,見〈免費的 Grok Build CLI〉。
ChatGPT 的個人方案分為 Free、Go、Plus、Pro,差別直接反映在能用到的模型與額度上。Plus 已包含以 GPT-5.6 驅動的進階推理、擴充的 Codex 用量、專案(Projects)、排程任務與自訂 GPT;Pro 再把用量拉到五至二十倍,提供 GPT-5.6 Sol Pro 等級的推理,並把 Codex 任務額度與記憶體/上下文拉到最大,各方案對照見 ChatGPT 定價頁,Pro 在頁面上被標為最適合研究與編碼。換句話說,若你主要拿來寫程式,Pro 的邊際價值最大;若只是偶爾使用,Plus 通常已經夠用。
想在終端機裡跑、而不是在網頁裡聊,就用 Codex CLI。它是 OpenAI 在 GitHub 上以 Apache-2.0 釋出的開源編碼代理,官方說明把它描述為「跑在你終端機裡的輕量編碼代理」,會直接讀寫你本機的檔案、執行指令並查看結果;若不想在本機安裝,也有雲端版 Codex Web。對新手最大的好處是:CLI 模式下 AI 看得到你整個專案的資料夾結構與檔案內容,不必你來回複製貼上,它也能在自己跑出報錯後立刻修正。
交代任務脈絡:背景、目標與限制一次給足
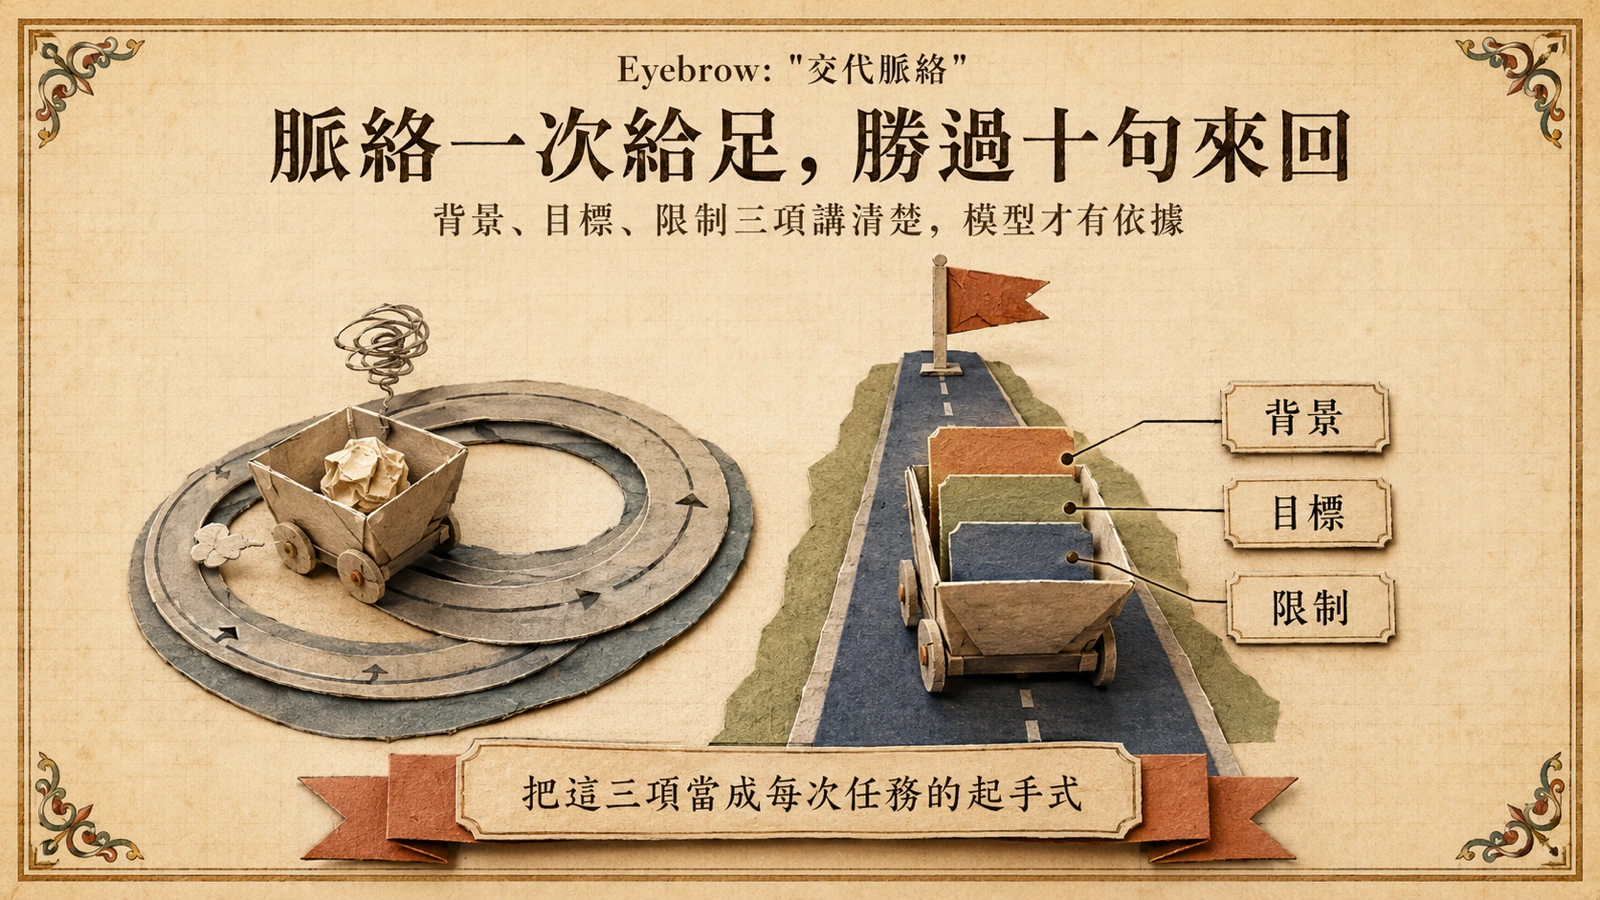
新手最常見的錯誤,是把 AI 當搜尋引擎,丟一句「幫我寫個網站」就等結果。模型不缺能力,缺的是脈絡。把一次任務講清楚,最小架構是三件事:背景(你在做什麼、為什麼)、目標(你要的成品長怎樣)、限制(採用語言、不能動哪些檔案、效能要求在哪)。這三項一次給足,勝過十句來回追問;若要先決定 coding agent 的實作語言,可對照不同程式語言的 agent 實測。
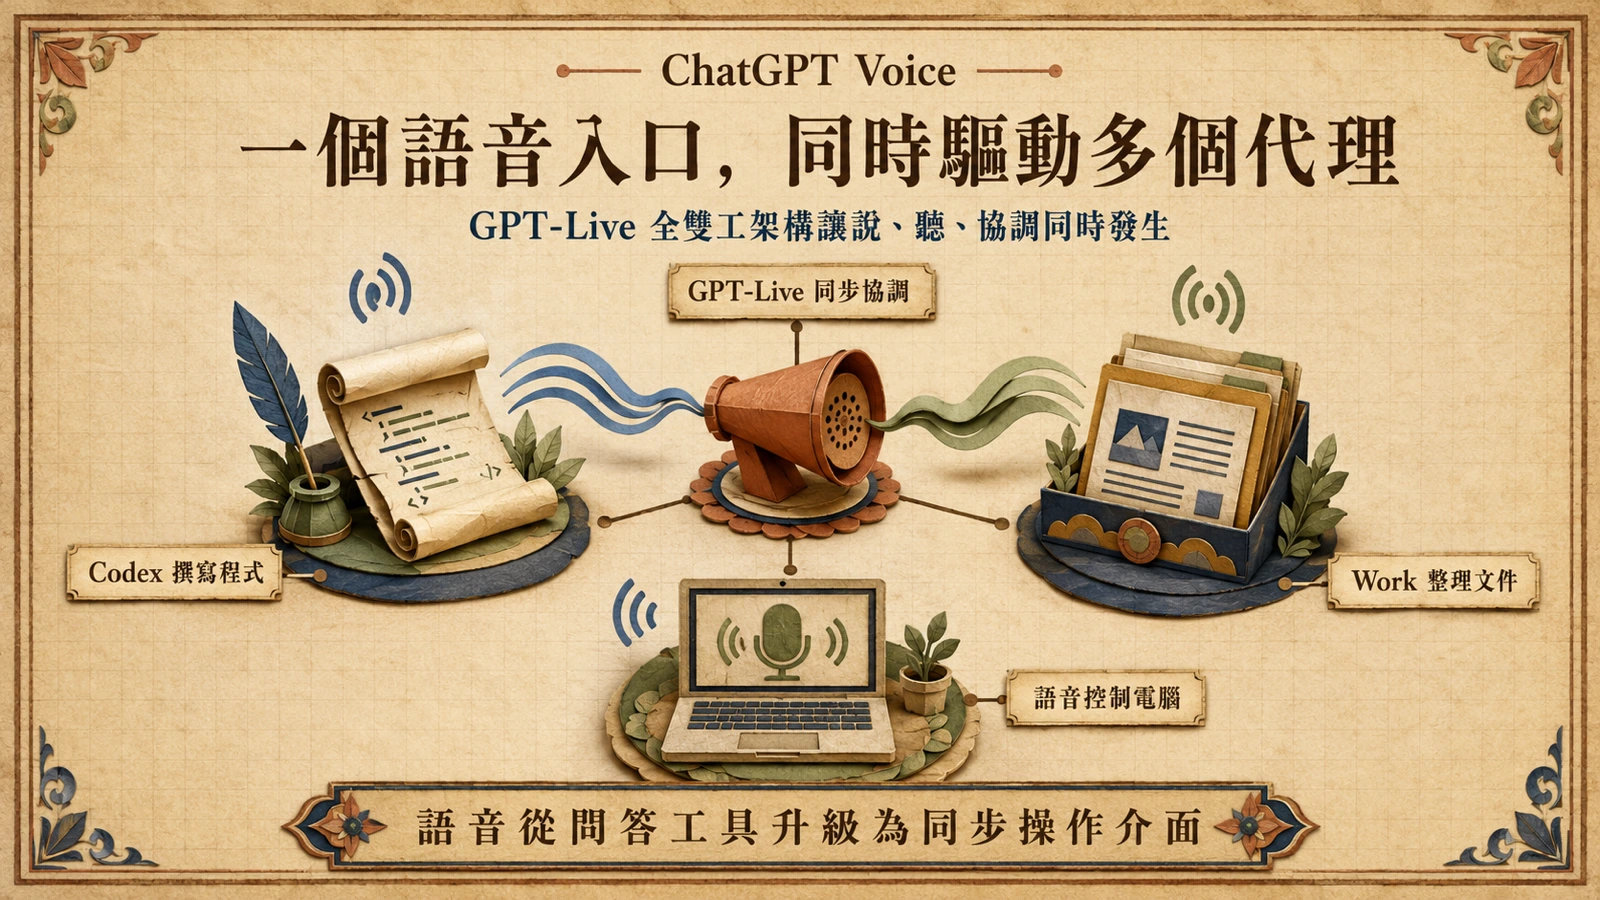
這也是語音輸入派得上用場的地方。用說的把背景與目標交代出來,往往比打字更完整、更口語,模型也更容易抓到你的真實意圖。ChatGPT 的語音功能(Voice,進階模式舊稱 Advanced Voice Mode)讓你用對話方式把任務講清楚,再交給模型整理成可執行的指令;把一段口述的脈絡餵進去,往往比反覆修改一行精簡的提示詞更省時(開源語音模型可見〈VoiceChat 11B〉,設計觀點見〈任務先於提示〉)。
善用 ChatGPT 的記憶(Memory)與專案(Projects),能把重複的背景沉澱進去,不必每次重講。記憶讓模型記住你跨對話的偏好與專案脈絡,專案則把相關檔案、指令與歷史擺在同一個工作區。兩者的差別是:記憶回答「我是誰、我怎麼工作」,專案回答「這次任務的資料與範圍」。把會重複的背景交給這兩個功能,你每次只要專心講這次獨特的目標。
讓 AI 反問並補上檔案:用迭代取代一次猜對
脈絡給足,不代表一次就要完美。更有效的節奏是:先給背景與目標,讓模型反問它還缺什麼,再把對應的檔案或範例補上。模型主動提問,通常比你猜測它需要什麼更快命中要害——它會問資料格式長怎樣、錯誤訊息完整是什麼、有沒有可參考的現有實作。把完整的錯誤訊息、輸入範例與預期輸出一起附上,模型幾乎不需要再猜。
把檔案直接交給模型,是 CLI 工具相對於網頁聊天最大的優勢。Codex CLI 跑在你本機,可以直接讀你專案裡的程式碼、執行指令、看到報錯再修正,整個迴圈不必離開終端機;就算用網頁版 ChatGPT,也能上傳檔案或貼上長文件,讓模型一次看完。重點是讓模型根據真實的資料做事,而不是憑你的描述去猜——描述再詳盡,也比不過讓它親眼看到檔案與報錯。
把重複指令沉澱為可重用能力:Custom GPT 與 Skills
當你發現自己對不同任務重複交代同一套背景與規則,就該把它固化下來。OpenAI 在 ChatGPT 定價頁正式列出的兩個相關功能是 custom GPT(自訂 GPT)與 Skills(beta):前者把固定的角色、知識與指令包成一個可重複呼叫的 GPT,後者則是所有方案都能用、用來封裝可重用能力的新功能。
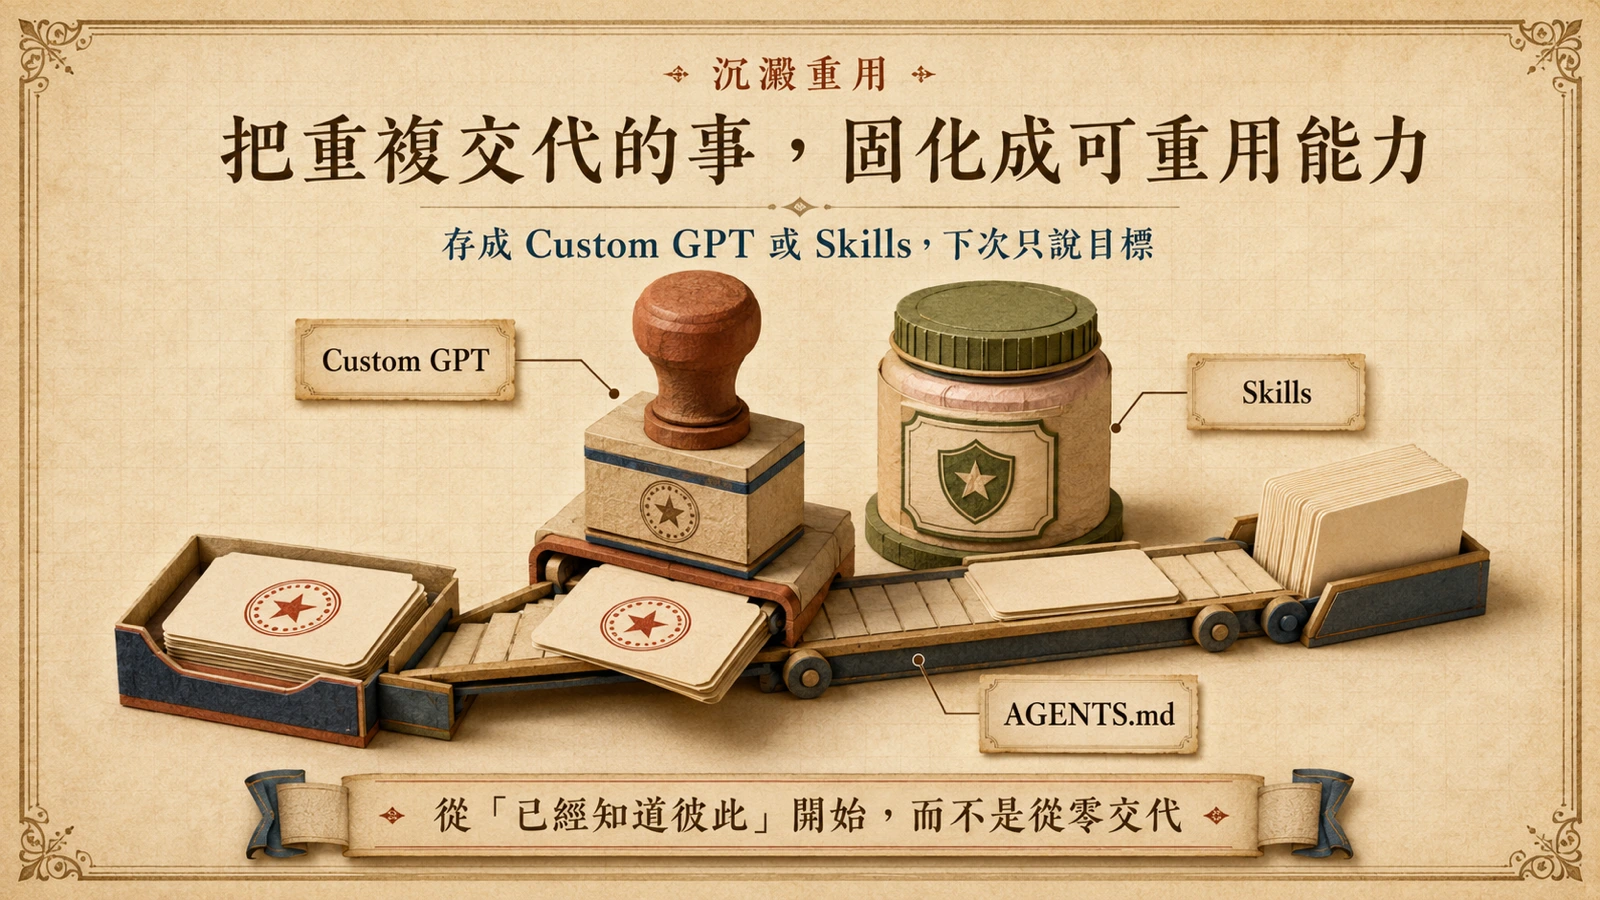
把「我的程式風格、專案的命名慣例、回報格式」存進一個 custom GPT,下次只要說出目標,背景就自動帶上。在 Codex CLI 這一側,對應的做法是把規則寫進專案層級的說明檔,例如 Codex 的 AGENTS.md——它之於終端機代理,就像 custom GPT 之於網頁版:把重複的指令沉澱成一次寫好、每次生效的預設值,差別只在一個存在雲端帳號、一個存在你的程式庫裡。一旦這層底打好,你與 AI 的每次合作都從「已經知道彼此」開始,而不是從零交代。
上手之後的取捨:成本、驗證與資料敏感度
工具能用,不等於該放手讓它全自動。幾個取捨值得記住。第一是成本結構:Sol 等旗艦層級單價較高,在大量重試的代理迴圈裡會放大帳單;先用 Terra 或 Plus 額度把任務跑通,再決定是否升級到 Sol 或 Pro,通常更精算。GPT-5.6 Sol 與 Claude Opus 5 的價格與每任務成本比較,可參考這篇模型對決整理。
第二是驗證:模型會自信地犯錯。它產生的程式碼、指令或事實聲明都要實際跑過、比對過,尤其在動到正式環境或資料之前。把 AI 的輸出當成草稿而非成品,是上手之後最重要的習慣。
第三是資料敏感度:把你公司的程式碼或客戶資料餵進雲端模型前,先確認該服務的資料使用政策。若資料不能離開本機,Codex CLI 這類可在本地端運作、或能指向自架模型的工具,是更保守的選擇;Kimi K3 透過 API 接進自建流程時,也同樣要留意資料落地與合約條款。
給新手一句話:與其追求速成,不如把選模型、交代脈絡、迭代補檔、沉澱重用這四個動作固定下來。工具會換、模型會升級,但這套把任務講清楚、讓模型反問、再驗證輸出的工作習慣,跨產品都適用。更多編碼代理的橫向比較,整理在工具主題分類。