3 億週活與上線範圍
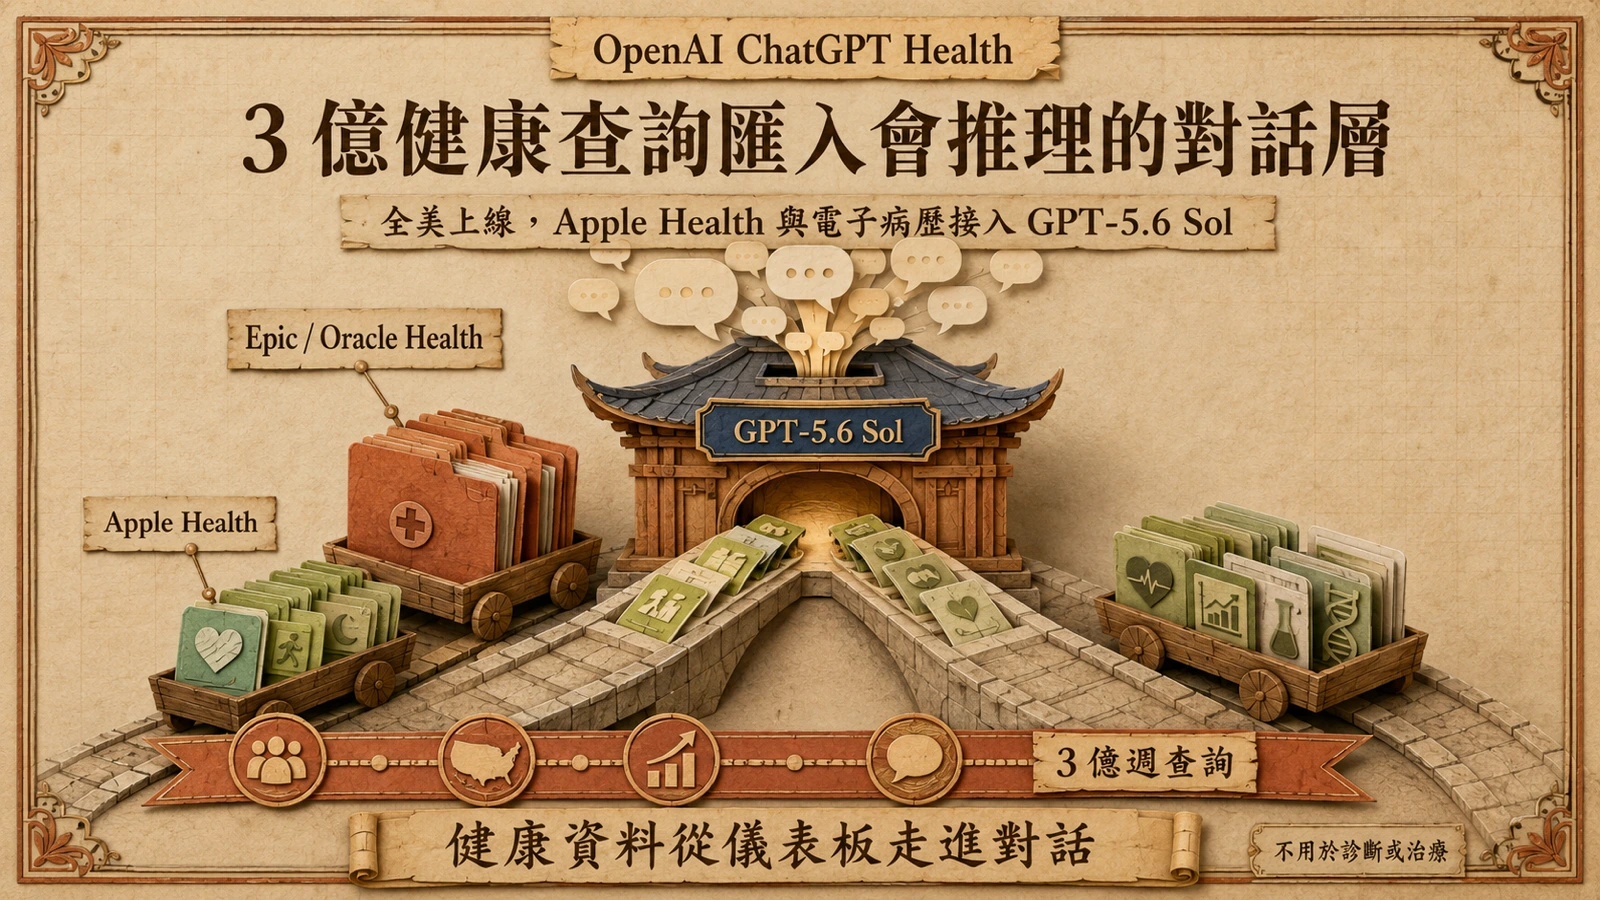
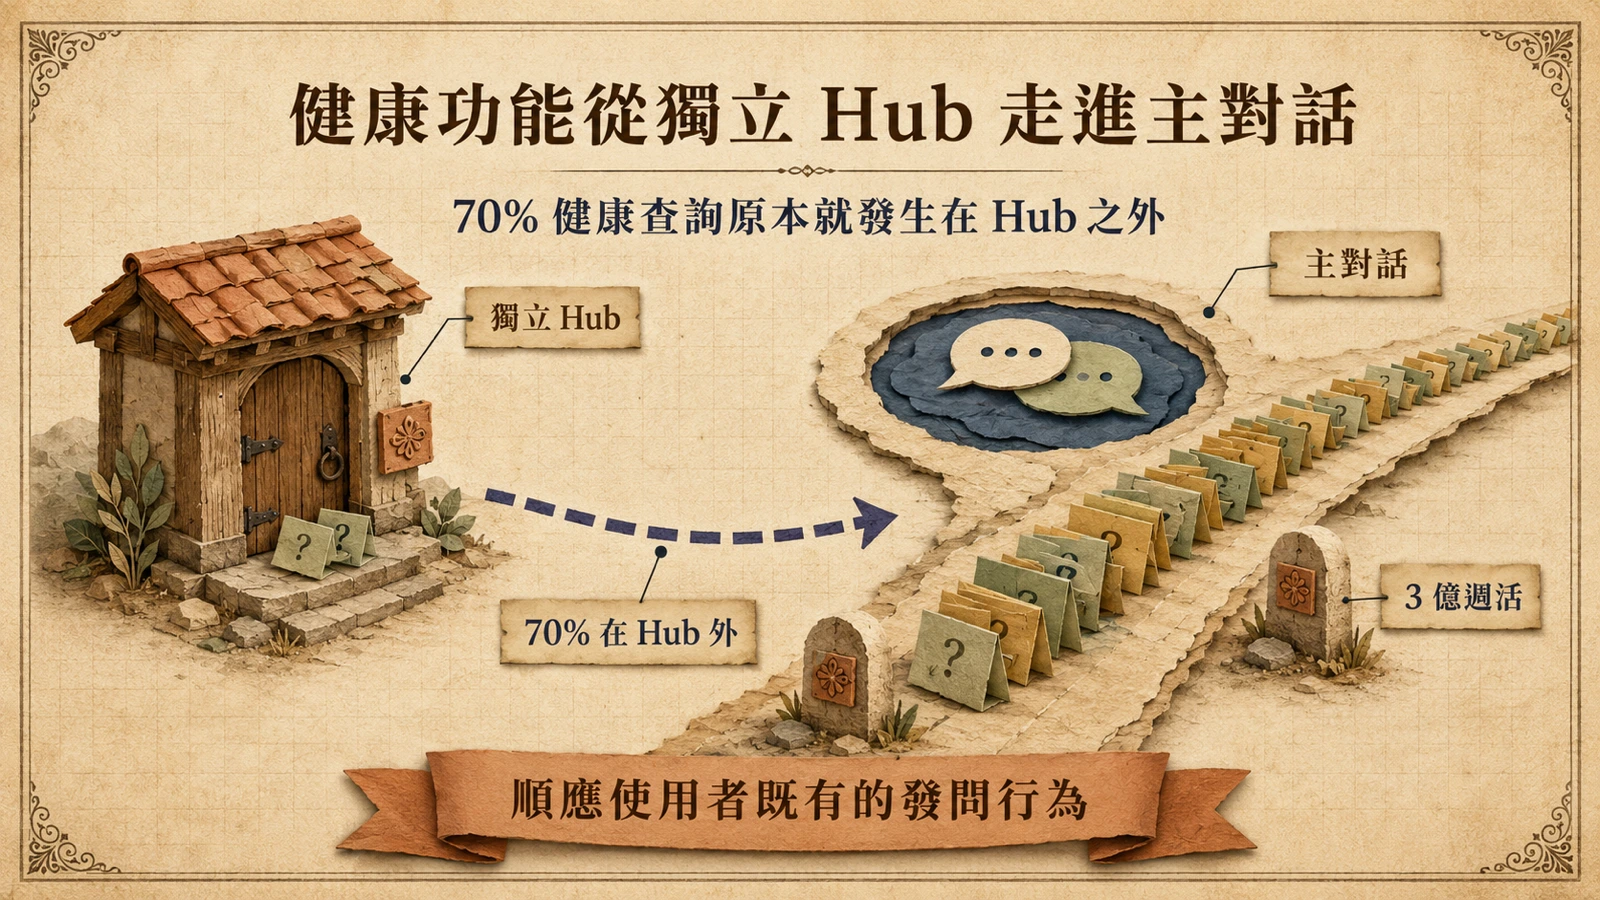
OpenAI 於 7 月 23 日將 Health in ChatGPT 正式向美國 18 歲以上、所有付費層級(Free、Go、Plus、Pro)的登入用戶開放,涵蓋 web 與 iOS;13–17 歲使用者則屬另外一套 ChatGPT for Teens 安全與學習體驗。根據 OpenAI 公布的數字,每週已有 3 億人在 ChatGPT 上提出健康相關問題,較 1 月封測時的 2.3 億持續攀升。這也是 OpenAI 把健康從獨立 Hub 推進到主對話流程的主因:內部觀察顯示約 70% 的健康查詢原本就發生在 Hub 之外,現在使用者可在任何對話中選擇引用已連結的健康資訊。
把健康從專屬入口併入主對話,是一個經過刻意取捨的產品決策。獨立 Hub 好處是隔離風險、容易標示「此處為健康功能」;併入主流程則把健康變成日常對話的背景脈絡,使用頻率與資料連動機會都更高,但模型在沒有明確「健康模式」旗標下解讀身體資訊,也讓誤導建議的觸發面變大。3 億週活的數字證明,無論入口設計為何,使用者早已把 ChatGPT 當成健康資訊的第一站,OpenAI 選擇順應既有行為,而非重新教育使用者走進指定入口。
串接 Apple Health 與醫療體系
使用者可授權連結 Apple Health,以及來自 Epic、Oracle Health 電子病歷系統、One Medical 與 Function Health 的就醫紀錄,並可整合 MyFitnessPal、WeightWatchers、Function 等 App。ChatGPT 會在使用前每次詢問授權,可比對前後次檢驗值、彙整自上次門診以來的變化、追蹤用藥,並把睡眠、活動與日常對話結合(例如依近況飲食限制挑餐廳、依近況傷勢調整週末活動)。OpenAI 強調對話在靜態與傳輸皆加密,連結資料另享額外加密保護,且不會用於模型訓練或廣告投放;使用者可隨時在 Health 設定中改回 once / always / disable。
模型實力與安全邊界
背後模型為 6 月下旬發表的 GPT-5.6 Sol,OpenAI 稱其為「迄今最強的健康模型」;最小版本 GPT 5.6-Luna 在自家開源評測 HealthBench 上優於 GPT 5.5。OpenAI 同時與全球 60 國、數百位醫師顧問合作設計評測情境,評量準確度、安全、溝通與適當升級。然而同一週,據報一名佛羅里達牧師起訴 OpenAI,主張 ChatGPT 先前建議延後就醫,導致他延誤處理肺栓塞險些喪命(未經獨立證實)。OpenAI 重申服務「不適用於診斷或治療」,並引導使用者以專業醫療判斷為準。
與 Apple Health、Google Fit 的定位差異
ChatGPT Health 的定位是「健康情境化對話」——把 Apple Health、電子病歷與健康 App 的資料整合進聊天介面,讓使用者用自然語言詢問、追蹤與比較變化。Apple Health 的本質是資料收集與儀表板,Google Fit 類似但平台碎片化較嚴重;兩者都被動呈現數字,不主動生成醫療建議。ChatGPT Health 的差異,在於把這些資料接入一個能推理與生成建議的 LLM(GPT-5.6 Sol),而非單純的資料視覺化。
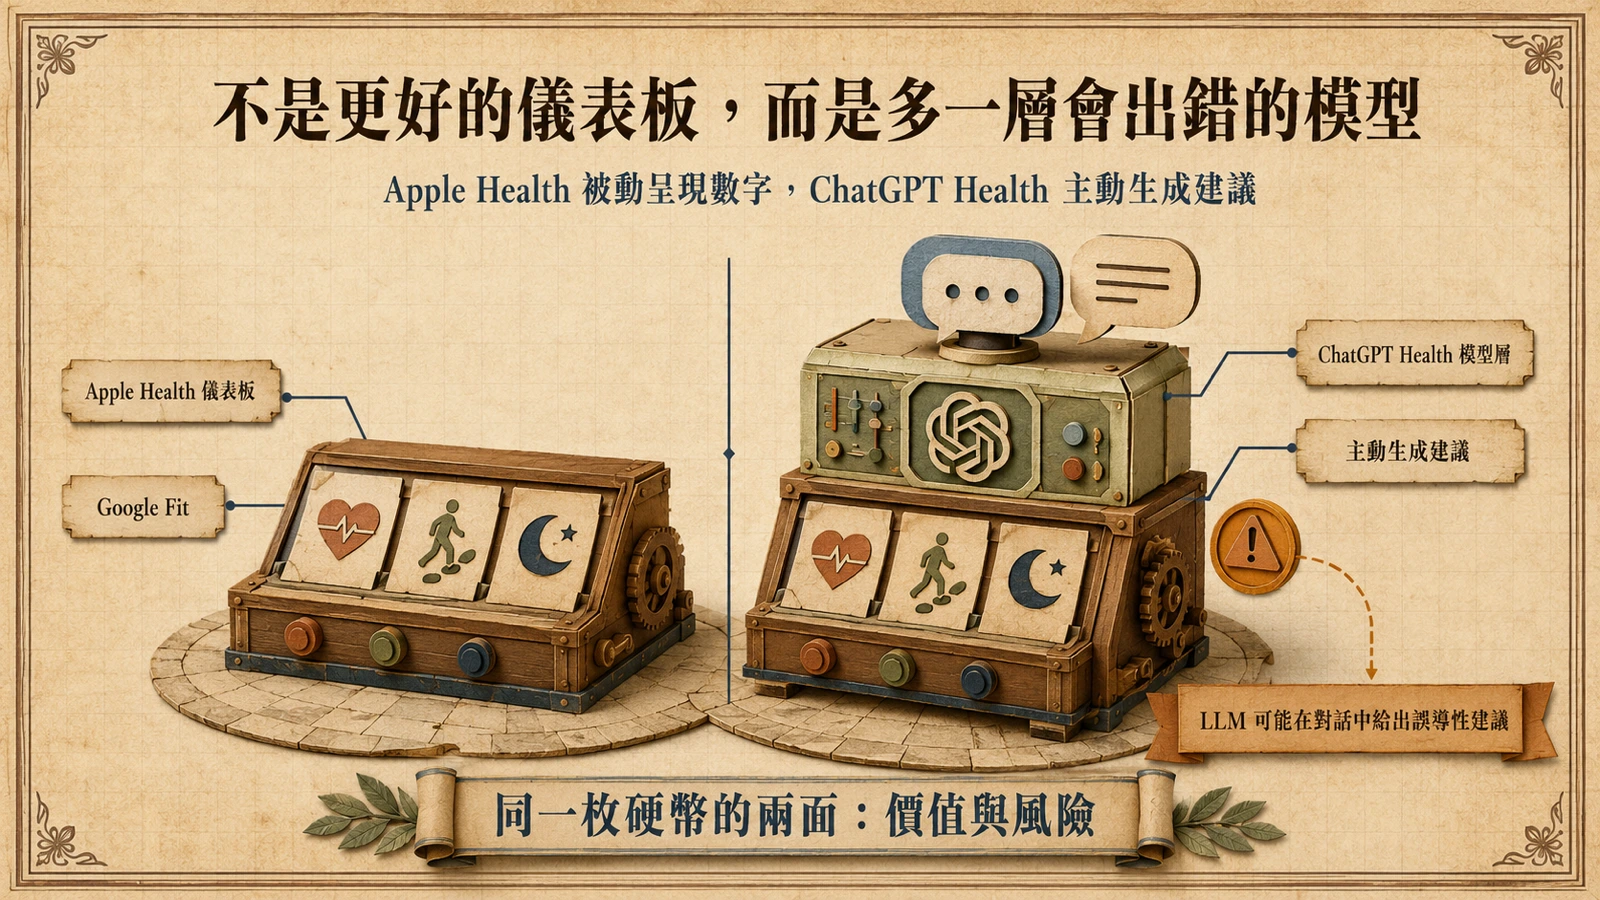
但這也帶來結構性更高的風險:儀表板頂多顯示錯誤數字,LLM 卻可能在對話中給出誤導性建議——佛州訴訟案就是「主動生成建議」這條界線被跨越後的具體爭議。換言之,ChatGPT Health 並非把 Apple Health 做得更好,而是在資料層之上多加了一層會說話、會推論、也因此會出錯的模型層。這一層的價值(個人化解讀、前後次檢驗值比對、主動提醒)與風險(錯誤建議、責任歸屬)是同一枚硬幣的兩面,也是它與既有健康平台最根本的差異。
對決策者的意義
區域限制上,Health in ChatGPT 目前僅美國可用,使用者尚無法直接連結本地電子病歷。但 Apple Health 與消費端健康 App 的資料策略、每次詢問授權的預設值、加密範圍與「支援而非取代專業醫療」的措辭,可作為本地 AI 健康產品設計隱私與安全 default 的參考範本。3 億週活驗證「健康情境化」已是高頻剛需場景,而非邊緣功能;當模型宣稱推理能力逼近甚至超越臨床醫師時,監理、舉證與救濟機制將是下一個主戰場。