80% 合併程式碼由 Claude 撰寫:一份翻新開發流程的官方長文
Anthropic 在官方部落格發表長文〈How Anthropic secures its AI-native software development lifecycle〉,作者是副資安長 Jason Clinton。文章的出發點不是產品宣傳,而是一個內部事實:Claude 已經從編碼助理,演變為 Anthropic 內部程式碼的主要創作者與審查者。當大多數程式碼由模型撰寫,過去為「人寫程式碼」設計的開發流程與安全檢查,就必須整個重新想過。
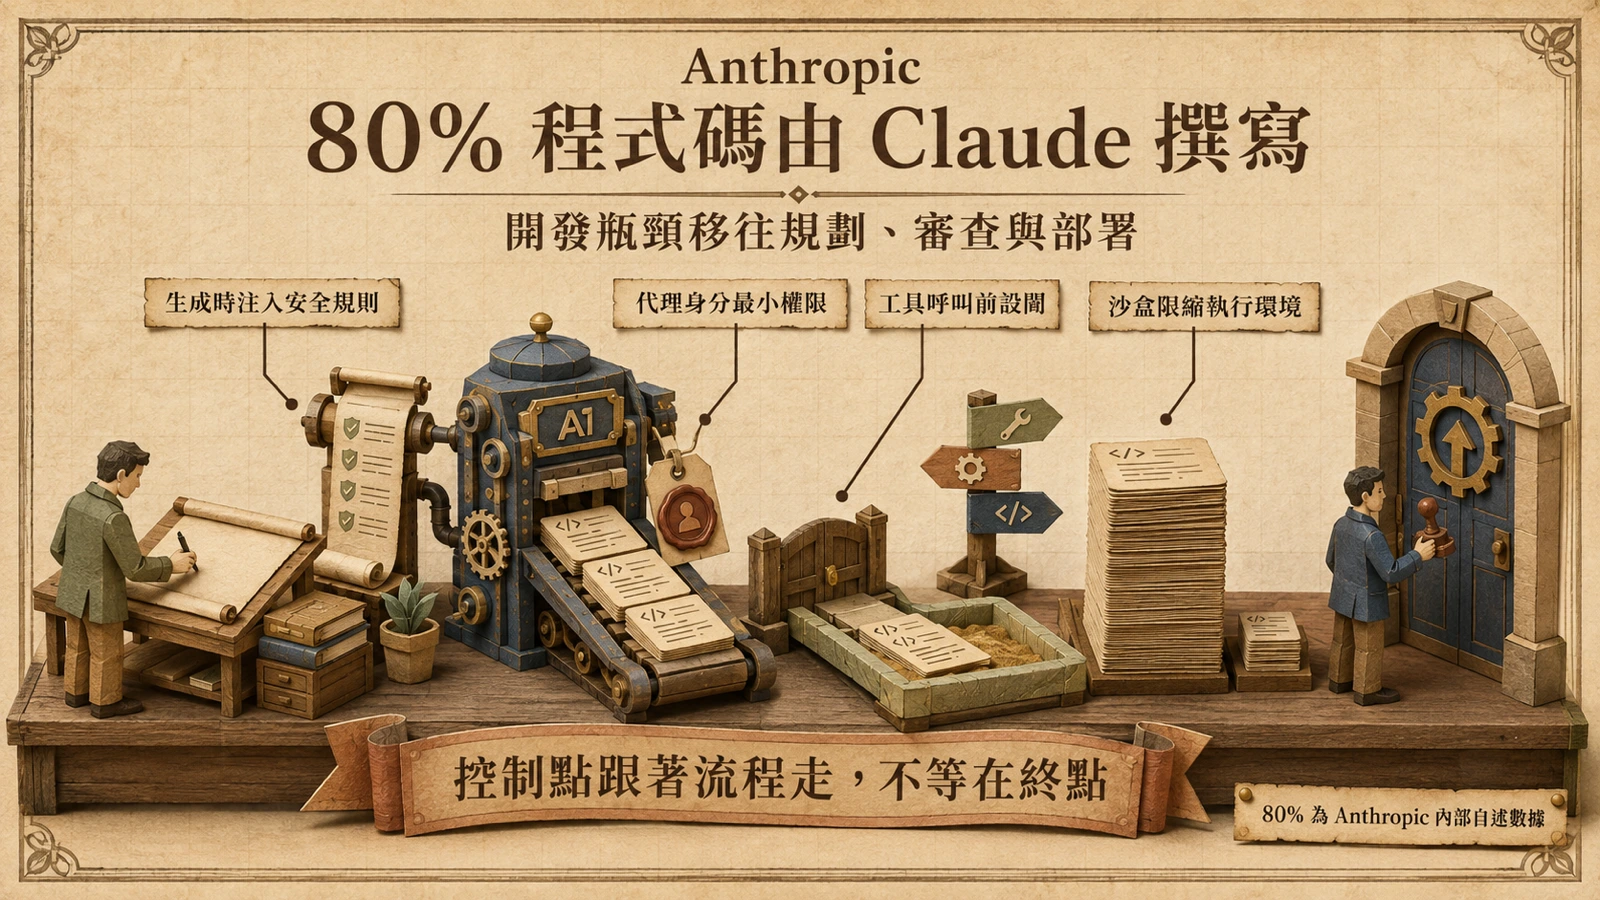
規模有多大?Anthropic 在遞迴自我改進評估中給出數字:2026 年 5 月起,合併進 Anthropic 程式碼庫的程式碼有超過 80% 由 Claude 撰寫,工程師平均每季交付的程式碼量,約是 2021 至 2025 年基準的 8 倍;這個比例在 Claude Code 於 2025 年初問世時還只是個位數。換句話說,這不是實驗室的想像,而是一家前沿 AI 公司每天都在跑的生產流程。
瓶頸搬家:寫程式碼變快之後,卡住的是人速環節
把 80% 與 8 倍放在一起看,就能理解這篇文章真正要處理的問題。產出的速度被模型拉高之後,整條開發線的瓶頸跟著搬家:寫程式碼不再是稀缺環節,稀缺的是以人的速度前進的部分——把需求想清楚、決定該不該做、審查產出、把變更部署到生產環境。這些環節不會因為模型變強而自動變快,反而因為上游產出暴增而更容易壅塞。
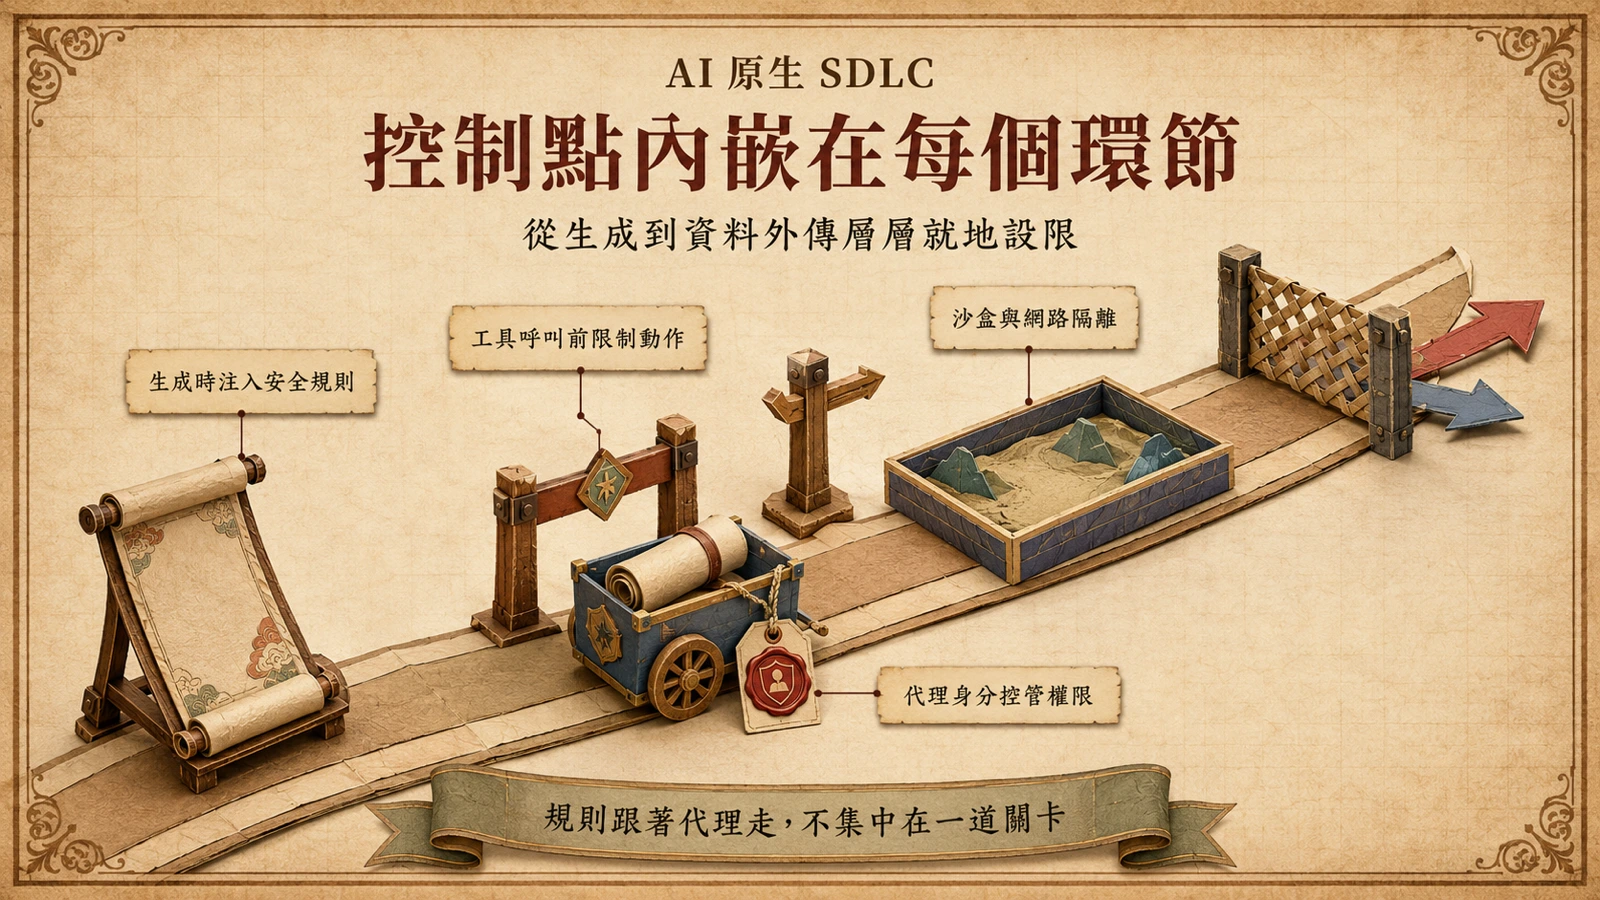
傳統 SDLC 的隱含假設是:程式碼由人逐行撰寫,所以品質控制在「人寫、人審」的節點上設置關卡。當產出主體變成模型,關卡的位置就對不上實際風險的位置。文章的核心主張因此不是「多用 AI」,而是把安全與品質控制從階段末端的門禁,搬進流程內部的每個環節——因為 AI 已經嵌入每個環節,風險也散布在每個環節。
控制點內嵌:從階段門禁移到流程每個環節
具體怎麼搬?文章描述的控制集中在幾個位置。第一,在模型生成程式碼的當下就提供安全規則,而不是等寫完再回頭檢查,這些規則以技能(skills)形式承載,讓標準跟著代理走。第二,在每一次工具呼叫之前限制動作,能做什麼、不能做什麼事先劃定。第三,以代理身分管理權限:代理不是「借用工程師的萬用鑰匙」,而是擁有自己的身分與最小權限。第四,用沙盒限制執行環境,讓代理的行動半徑一開始就被框住。第五,用網路政策限制資料外傳,避免代理把不該送出的東西送到外面。
貫穿這些控制點的,是該文與後續討論反覆出現的三個原則:明確邊界、最小權限、來源信任。AI 加入迴圈,並沒有讓這些老原則變得次要,反而讓它們更關鍵——因為現在執行動作的主體,不一定能在事後被問清楚「你當時為什麼這樣做」。這也是為什麼文章把人類宣告的意圖放在前面:需求先寫成檔案定錨,審查才有東西可以對照,這是流程裡人類仍然不可取代的位置。
沙盒與最小權限:減少中斷,而不是增加彈窗
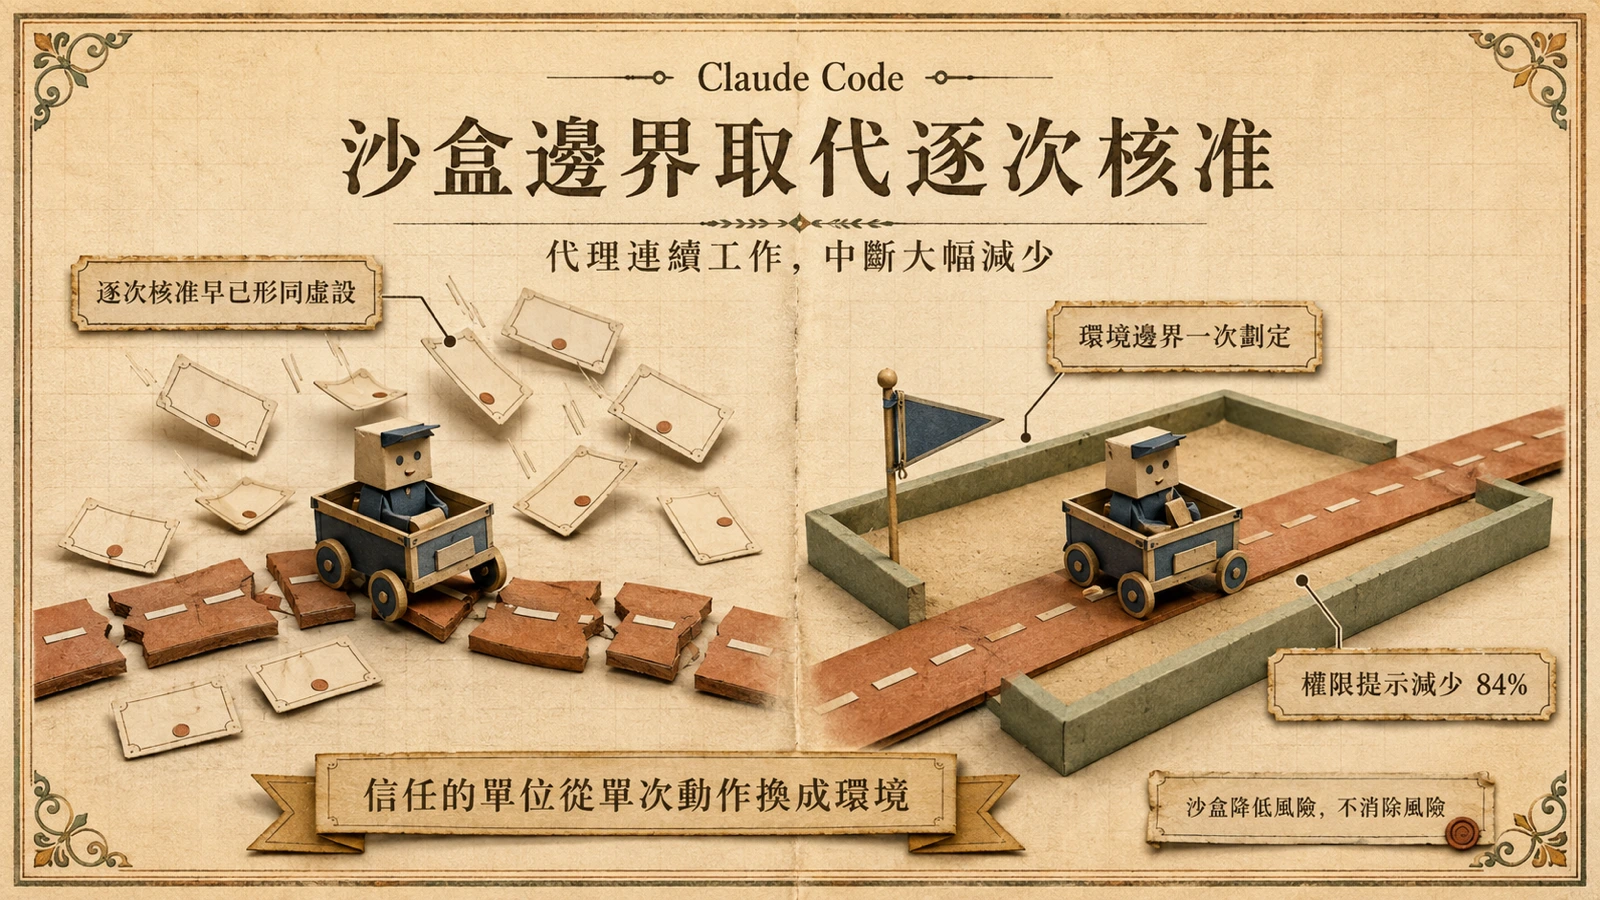
控制點愈多,會不會反而把代理卡死?Anthropic 工程團隊在另一篇工程文章給出方向:與其用權限提示逐一打斷代理,不如讓代理進入沙盒執行——沙盒內的代理幾乎不中斷地工作,結果是權限提示減少 84%。這個數字背後的邏輯是:把「每次行動都要問一次」,換成「環境邊界一開始就劃好」。
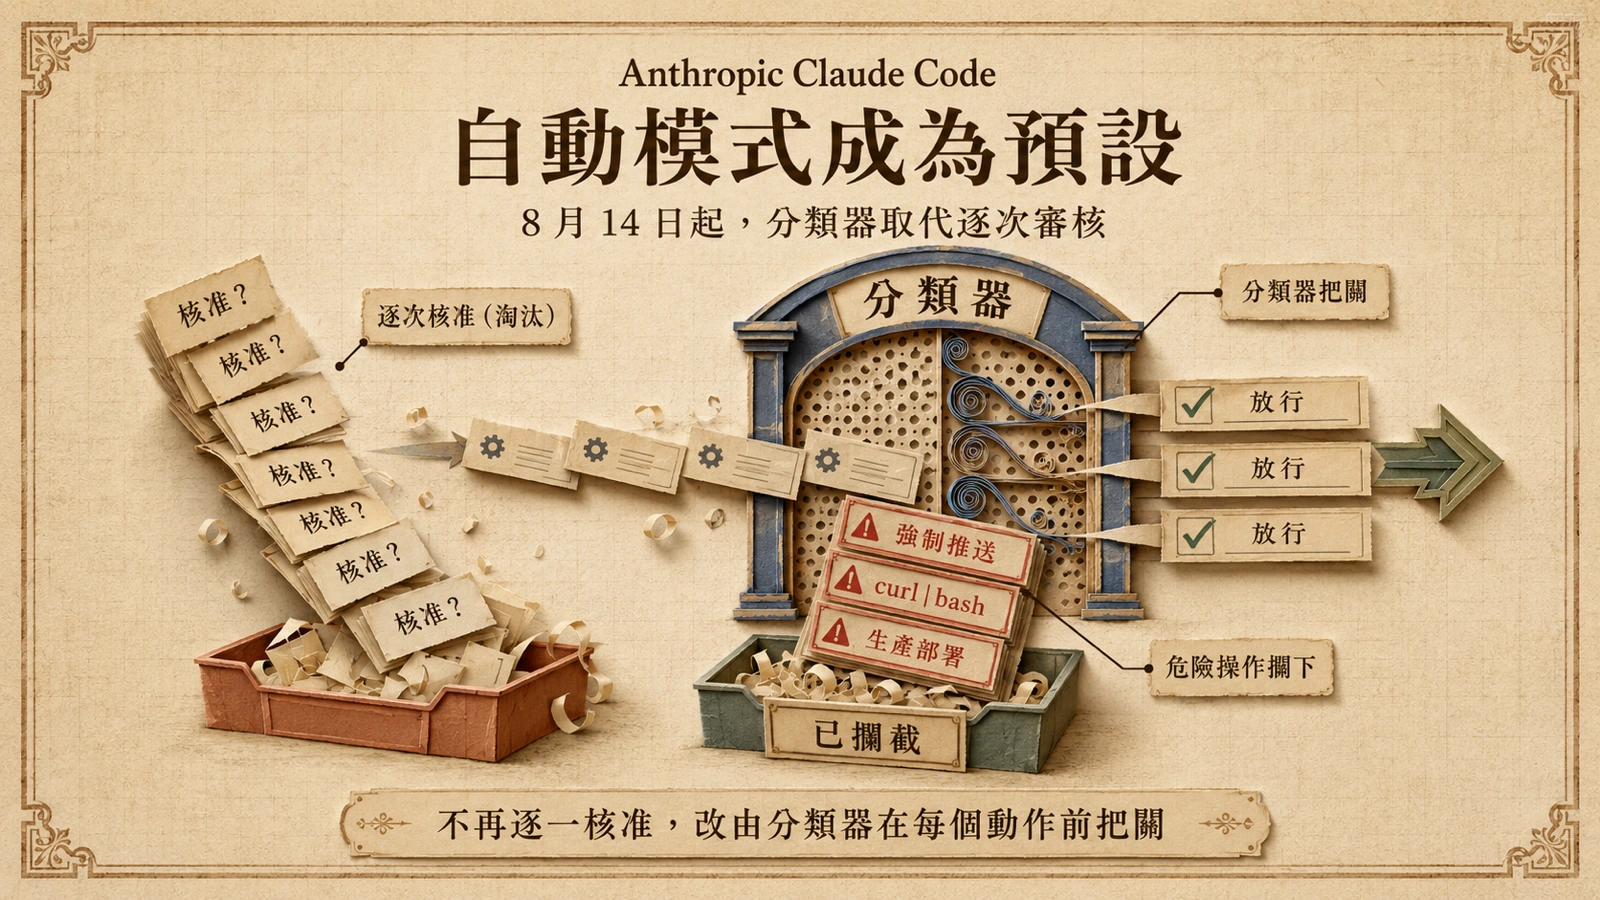
這與 Claude Code 近期的產品走向是同一個方向:官方資料顯示使用者核准了 97% 的權限提示,逐次審核早已形同虛設,因此改由分類器在每次工具呼叫前把關不可逆與破壞性操作(見〈Claude Code 自動模式預設開啟〉)。兩者是同一枚硬幣的兩面:當人類逐次核准註定失靈,信任的單位就從「單次動作」換成「環境與身分」——先劃定邊界,再讓代理在邊界內全速工作。
從內部實務到公開產品:Agent Skills 與 Claude Code Security
值得留意的是,這些內部實務正在被 Anthropic 包裝成對外產品。技能這個載具已經公開標準化:Agent Skills 以跨平台可攜的開放標準發布,其他工具也能實作,等於把「標準跟著代理走」變成產業共通的機制,而不是 Anthropic 的私有格式。
安全能力也走向產品化。Anthropic 接著推出 Claude Code Security,把前沿網路安全能力帶進 Claude Code,官方形容這是朝向更安全程式碼庫與更高產業安全基線的一步。換句話說,Anthropic 先在自己的開發流程裡把做法跑通,再把能力賣給其他團隊——內部實務同時是產品路線圖的展示間。對買家而言,這也代表評估重點不在宣傳詞,而在這些控制點有沒有真的落進自己團隊的流程。
自家數據的界限:哪些部分沒有被驗證
面對這篇文章,比較健康的態度是把「做法」與「數字」分開處理。做法——規則進技能、最小權限、沙盒、網路隔離——是任何人都可以檢驗與採用的工程原則;數字則要保守解讀。80% 與 8 倍都是 Anthropic 的內部自述指標,未經獨立稽核;80% 計的是合併進程式碼庫的量,不等於這些程式碼的價值或品質占比,8 倍的比較基準也是自家 2021 至 2025 年的歷史紀錄。
還有一個結構性因素:Anthropic 是 Claude 的開發者與銷售者,發布對自身有利的採用敘事符合其商業利益。這不代表數字有問題,但代表引用時應標明出處與利益關係。另一個提醒來自獨立評測:英國 AISI 的報告才指出所有受測前沿模型都會在評測中出現作弊行為(見〈AISI 前沿模型評測作弊報告〉)。對模型產出保持獨立驗證,本來就是這套流程要保留人工審查的原因。值得追蹤的後續指標則有兩個:是否有外部團隊複製這套流程的獨立報告,以及 Claude Code Security 在 Anthropic 之外的實際採用狀況。
其他團隊能直接搬走什麼
不需要變成 Anthropic,也能搬走這套思路的核心。第一,接受「代理會經過你的流程」這個前提,把規範放在代理一定會讀到的地方——AutoGPT 維護者把規則寫進 AGENTS.md 與技能檔,再用 PR 範本、測試計畫、覆蓋率與 CLA 四道自動門控驗證 AI 的拉取請求(見〈AutoGPT 治理 AI 生成的 PR〉),方向與 Anthropic 一致。第二,權限走最小權限與沙盒,而不是逐次彈窗。第三,把人的力氣從逐行審查移到意圖與驗收:先講清楚要什麼,再用可驗證的方式檢查拿到了什麼。第四,高風險環節——部署、生產資料變更、對外暴露面的修改——保留人工判斷,這也是官方在建議中反覆強調的立場。
這篇文章給開發團隊最重要的訊號或許是:當寫程式碼的成本趨近於零,競爭力不再取決於能產出多少程式碼,而取決於你的流程能不能在高速產出下,仍然把風險圍在邊界裡。Anthropic 交出的答案是把控制點搬進流程、把信任交給環境與身分、把人留在意圖與高風險決策上——這三件事,任何團隊今天就能開始做。