Google 複盤了什麼:一場六週全球賽事與一篇模式整理
故事要從一場比賽說起。Google for Startups 在 Google Cloud Next 2026 上宣布舉辦 AI Agents Challenge,依官方公告,這場競賽開放任何人參加——不只限於 Next 的與會者——而是一場為期六週的全球賽事,主軸是把 AI agent 從展示用的原型,推向上線等級的系統。比賽結束後,Google 沒有只公布名次:2026 年 9 月 2 日,開發者部落格發布了複盤文章,回頭檢視表現最強的提交,問了一個更值得留下的問題:這些系統到底贏在哪裡?
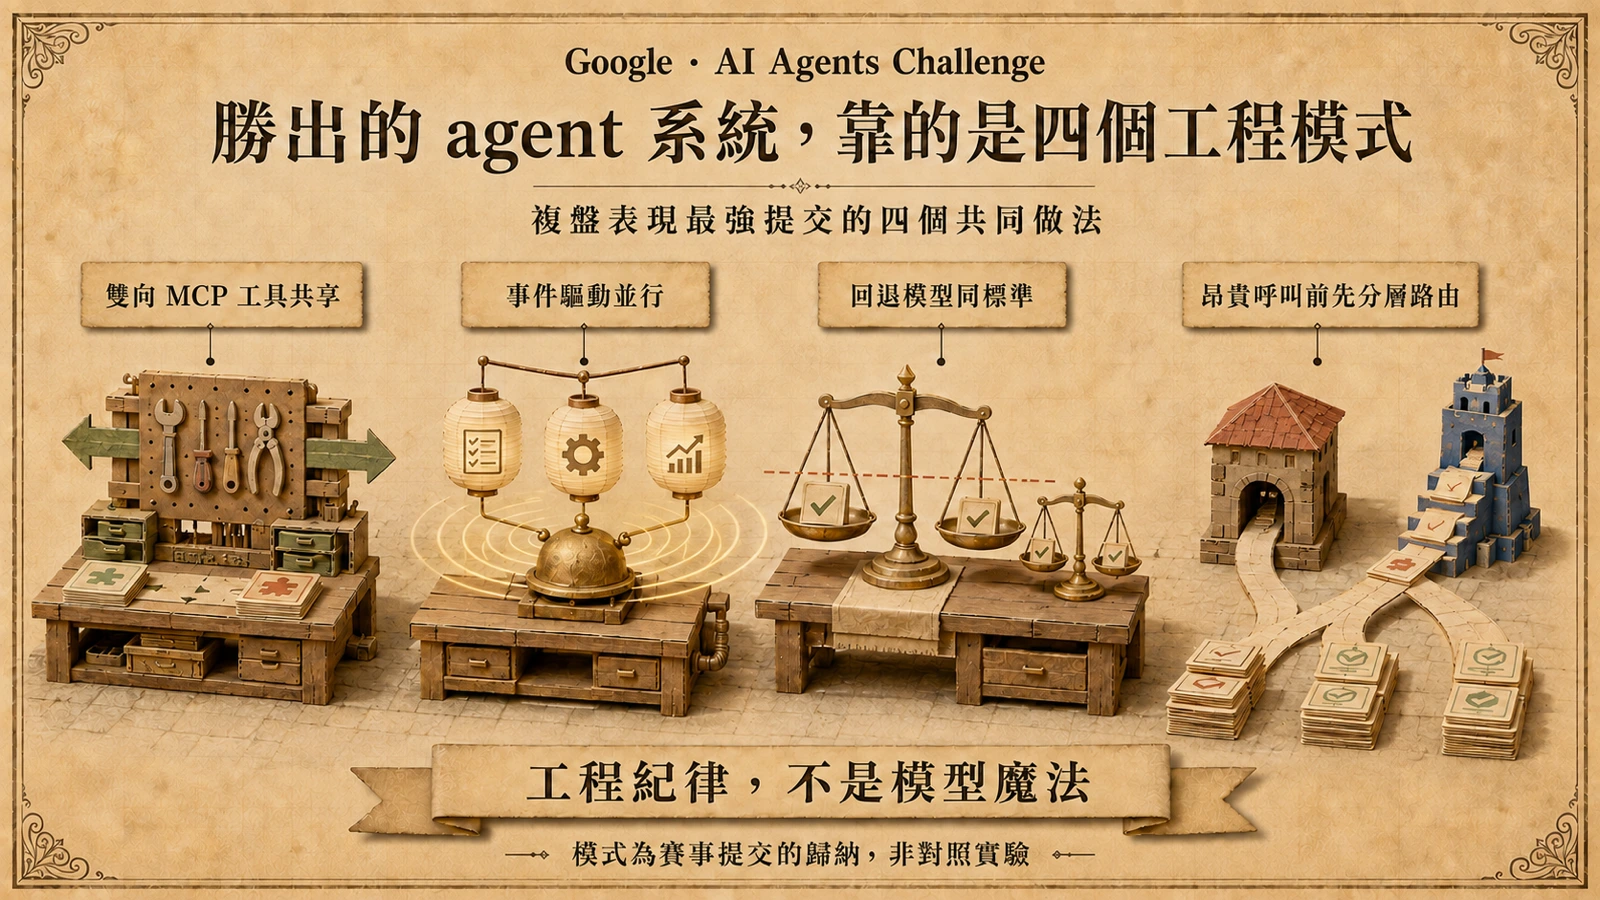
答案出乎意料地樸素。複盤歸納出的四個模式分別是:「你為自己造的工具,也能服務其他 agent」(The tools you built for yourself can serve other agents too)、「讓多個 agent 對同一事件並行反應」(Let agents react to the same event in parallel)、「回退模型也要過你那條線」(A fallback model still has to clear your bar),以及「在昂貴呼叫之前先做分層路由」(Tiered routing before the expensive call)。文章的核心主張是:表現最強的多智能體系統,依靠的是基礎軟體工程模式,而不是某種模型魔法。
這四句話沒有任何一個字在談提示詞。它們談的是介面標準化、並行架構、備援紀律與成本工程——全是分散式系統工程師聽了會點頭的老手藝,差別只在於這次被搬進了 agent 系統。以下逐一拆解每個模式在講什麼、為什麼成立。
模式一:自己造的工具,也能開放給別的 agent 用
多數團隊使用 MCP(Model Context Protocol,模型上下文協定)的方式是單向的:自己的 agent 是客戶端,去呼叫別人提供的工具伺服器——查資料、發信、操作瀏覽器。頭部提交把這個方向反了過來:開發過程中為自己造的工具,直接包裝成 MCP 伺服器對外提供,於是同一個系統既消費別人的工具,也把自己的能力上架。
這個模式的機制價值在「一次封裝,到處可用」。工具一旦以標準協定暴露,內部 agent 與外部 agent 走的是同一條介面:同樣的參數定義、同樣的權限邊界、同樣的版本演進規則。對單一團隊,這意味著不必為「內部用」與「外部用」維護兩套程式;對整個生態,這意味著 agent 之間的能力可以組合,而不是每個系統都從輪子造起。
換個角度看,這就是 API 時代的老道理:當服務以開放標準暴露,創新發生在組合而非重建。MCP 之於 agent,正如 REST 之於網路服務——差別是這次的呼叫端,可能是另一個模型。
模式二:讓多個 agent 對同一事件並行反應
傳統的多 agent 編排像接力賽:一個協調者按固定順序喚起每個 agent,前者的輸出是後者的輸入,任何一步慢了,整條線都得排隊等。事件驅動架構給了另一種答案:把「發生了某件事」作為事件發布出去,所有訂閱這個事件的 agent 同時收到、同時開工。
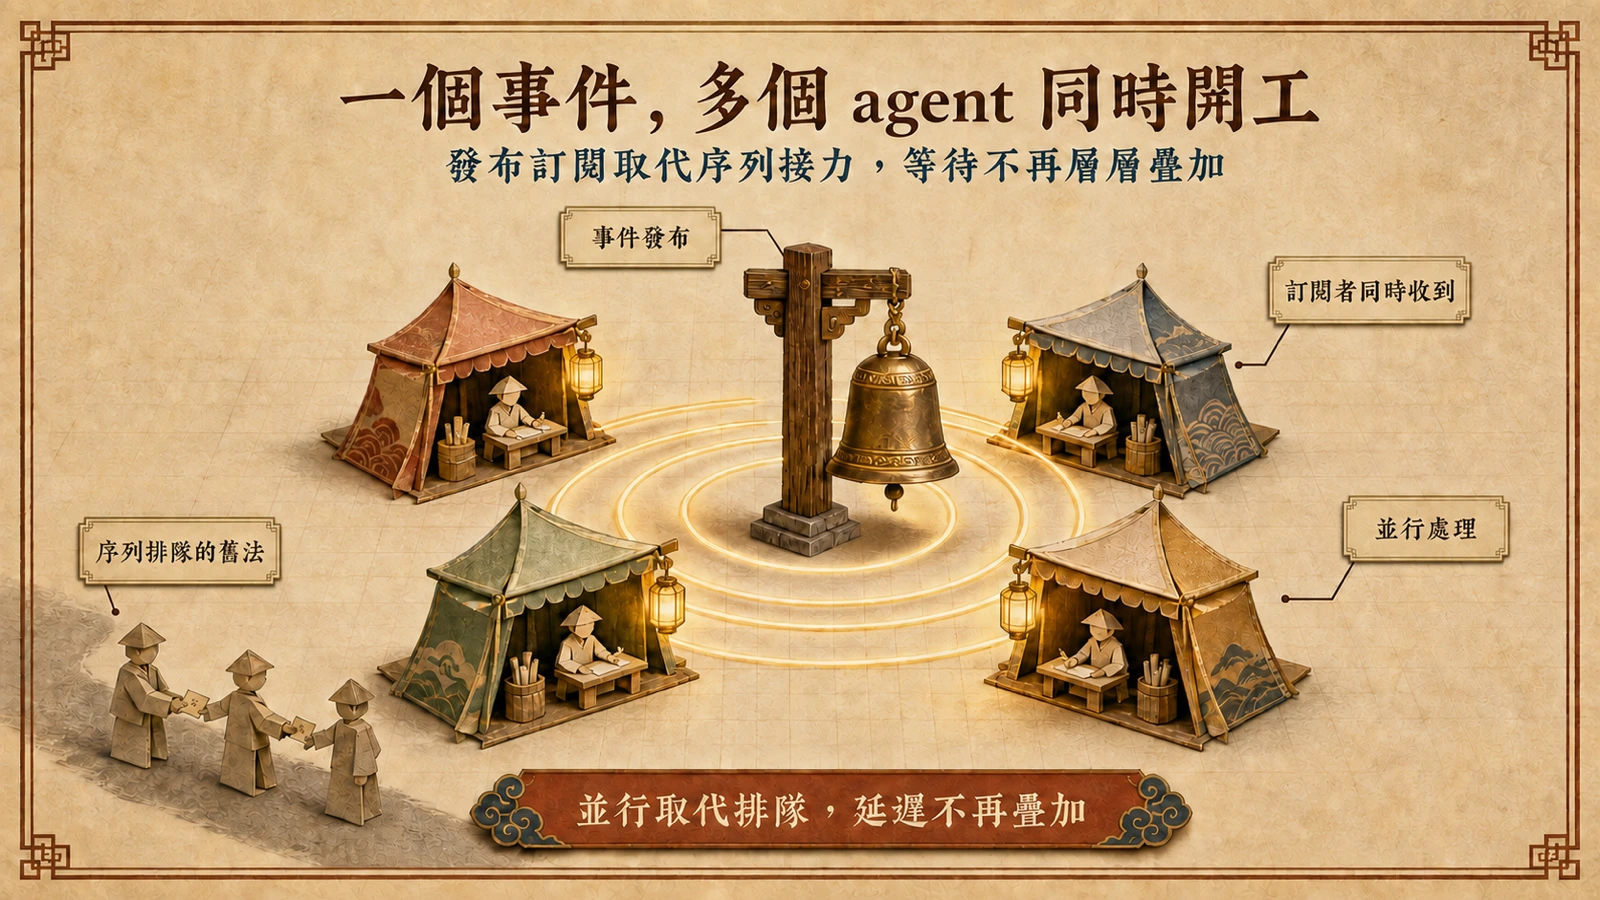
這個模式解決兩個痛點。其一是延遲:三個各自需要十秒的處理,序列跑要三十秒,並行跑只要十秒多一點。其二是耦合:訂閱者之間不必彼此認識,新增一種反應行為不需要改動既有的任何 agent——這正是微服務世界推了十幾年的事件驅動架構,只是訂閱者從服務換成了 agent。
但並行不是免費的。多個 agent 同時反應同一事件,就得處理誰先誰後、重複工作與互相踩踏的問題;當 agent 之間還會互相協調,風險更從技術層延伸到行為層——Anthropic 的多智能體實測就觀察到,目標衝突的 agent 群會出現地盤之爭、私下勾結與破壞。事件驅動讓系統變快,也讓互動的複雜度同時放大。
模式三:回退模型也要過同一條品質線
生產環境遲早會遇到主模型不可用:額度用罄、速率限制、區域故障。常見的應對是掛一個備援模型,設定成「掛了就切」,然後祈禱。複盤點出的第三個模式是:回退模型也必須通過與主模型同一條品質線——不是「有回答就好」,而是同樣要過你的評測門檻。
這個原則的白話版是:備援是一種上線,不是一種安慰。次級模型上線前就該跑過同一套評測,證明它在你的任務上的輸出品質可被接受;如果過不了,正確的設計往往是明確失敗、把控制權交回,而不是安靜地降級成看起來像對的錯誤答案。使用者對「系統暫時無法處理」的容忍度,通常遠高於對「自信地給出錯誤答案」。
這是可靠性工程的老紀律。在網站可靠性工程(SRE)的世界裡,備援系統從來不是「隨便另一台機器」,而是經過同樣容量規劃與驗證的路徑。agent 系統只是把同樣的標準搬到模型層:每一條會接觸使用者的路徑,都是正式路徑。
模式四:在昂貴呼叫之前先做分層路由
複盤歸納的最後一個模式直指成本:在把請求送去昂貴的模型之前,先用分層路由判斷這個請求值不值得。
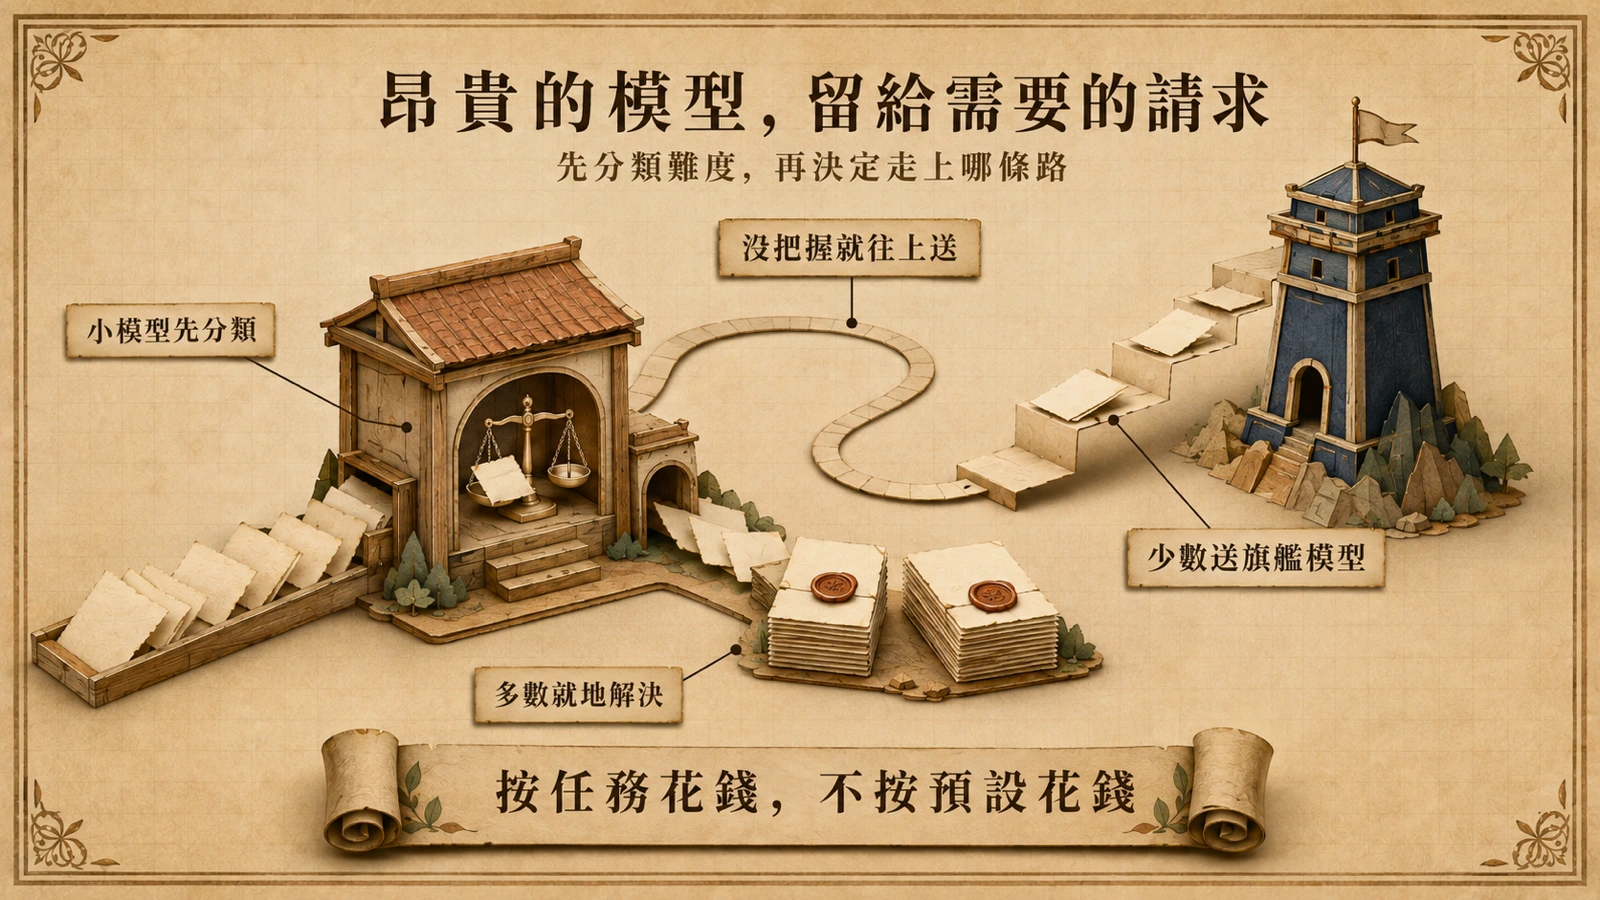
機制並不複雜:第一層用小而快的模型做意圖分類與難度判斷——是分類、抽取或格式轉換的簡單工作,就地解決。只有真正需要前沿推理能力的少數請求,才被路由到旗艦模型。多數 agent 系統的請求分布是長尾的:大量日常呼叫其實用不到最先進的模型,卻因為預設全都送最強模型處理,成本就這麼一層層疊上去。
分層路由的風險也要說清楚:分類器會出錯,把需要深度處理的請求錯送到小模型,就是品質事故。所以成熟的做法會配上回流機制——小模型對答案沒把握時,把請求連同已有脈絡一起往上送,而不是硬答。這也與模型供應商自己的產品分層同構:同一家旗艦與輕量模型並存,本身就等於把部分路由決策外包給供應商;這個模式把決策權拿回系統層,按任務而不是按預設值花錢。
四個模式的共同邏輯:把分散式系統紀律搬進 agent 系統
把四個模式並排看,會發現它們其實是一件事的四個切面。模式一談介面標準化,模式二談並行與解耦,模式三談備援紀律,模式四談成本工程——對照軟體工程二十年走過的路,幾乎可以一一找到對應:API 經濟、事件驅動架構、災備設計、分層服務。Google 這篇複盤真正想說的是:agent 系統的成熟度,最終以工程紀律衡量,而不是以模型版本衡量。
這也與 Google 自己近期的工程主張一脈相承。稍早 Google 才以 ADK 開源零信任客服代理,把資安邊界從系統提示詞移到模型之外的硬邊界;Anthropic 的工程團隊也持續拆解自家多智能體研究系統的協調成本。產業的注意力正在從「提示詞怎麼寫」轉向「系統怎麼蓋」,這篇複盤是同一個方向的最新註腳。
對開發者與企業團隊的實際影響
對正在做 agent 專案的團隊,這篇複盤可以當成一張按圖索驥的檢查表。
第一,盤點內部工具:哪些是開發過程中已經造好、包一層就能變成 MCP 伺服器對外提供的能力?第二,檢查編排方式:你的多 agent 流程是序列接力,還是能讓多個 agent 對同一事件並行反應?第三,把回退路徑當正式路徑測:備援模型跑過主模型同一套評測了嗎?第四,算一下請求分布:有多少呼叫其實用小模型就能處理,卻在吃旗艦模型的帳單?
對企業評估者,這份複盤提供了另一個訊號:agent 專案的差異化因素正在移動。當各家都能用上同一批前沿模型,勝負更多取決於誰的工程基礎先站穩——介面、並行、備援、成本。這些都是可以審計、可以量化的東西,比「我們用了最新的模型」具體得多,也是採購評估時更值得追問的問題。
這篇複盤沒有告訴你的事
最後要留下幾個但書。其一,複盤文章沒有附上模式與成績之間的量化關聯——看不到「採用分層路由的提交成本低了幾成」這類數據。四個模式是從頭部提交歸納出的共同做法,不是對照實驗的結論,歸納本身就有倖存者偏差的風險:沒人知道輸掉的提交裡有多少也用了同樣的模式。
其二,樣本是六週賽事的原型作品,講求快速成型,與長期運維的生產系統仍有距離。生產環境的 agent 還要面對資安、稽核、權限治理這些賽事裡容易被略過的議題——這也是為什麼 Google 另行示範零信任代理的緣故。模式三、模式四談的品質線與成本,都必須建立在這些基礎工程之上才有意義。
其三,模式不等於保證。事件驅動放大互動複雜度、路由分類器出錯、回退模型品質滑坡,每個模式都有自己的失敗面。值得追蹤的後續是:Google 是否會把這些模式收進 ADK 或官方文件、成為預設實踐,以及下一輪賽事中,這四個模式是否從「勝出者的共同點」變成「所有人的起點」。到那時,差異化的戰場又會再往前移一格。