OpenAI 把金融業專版 ChatGPT 做成產品
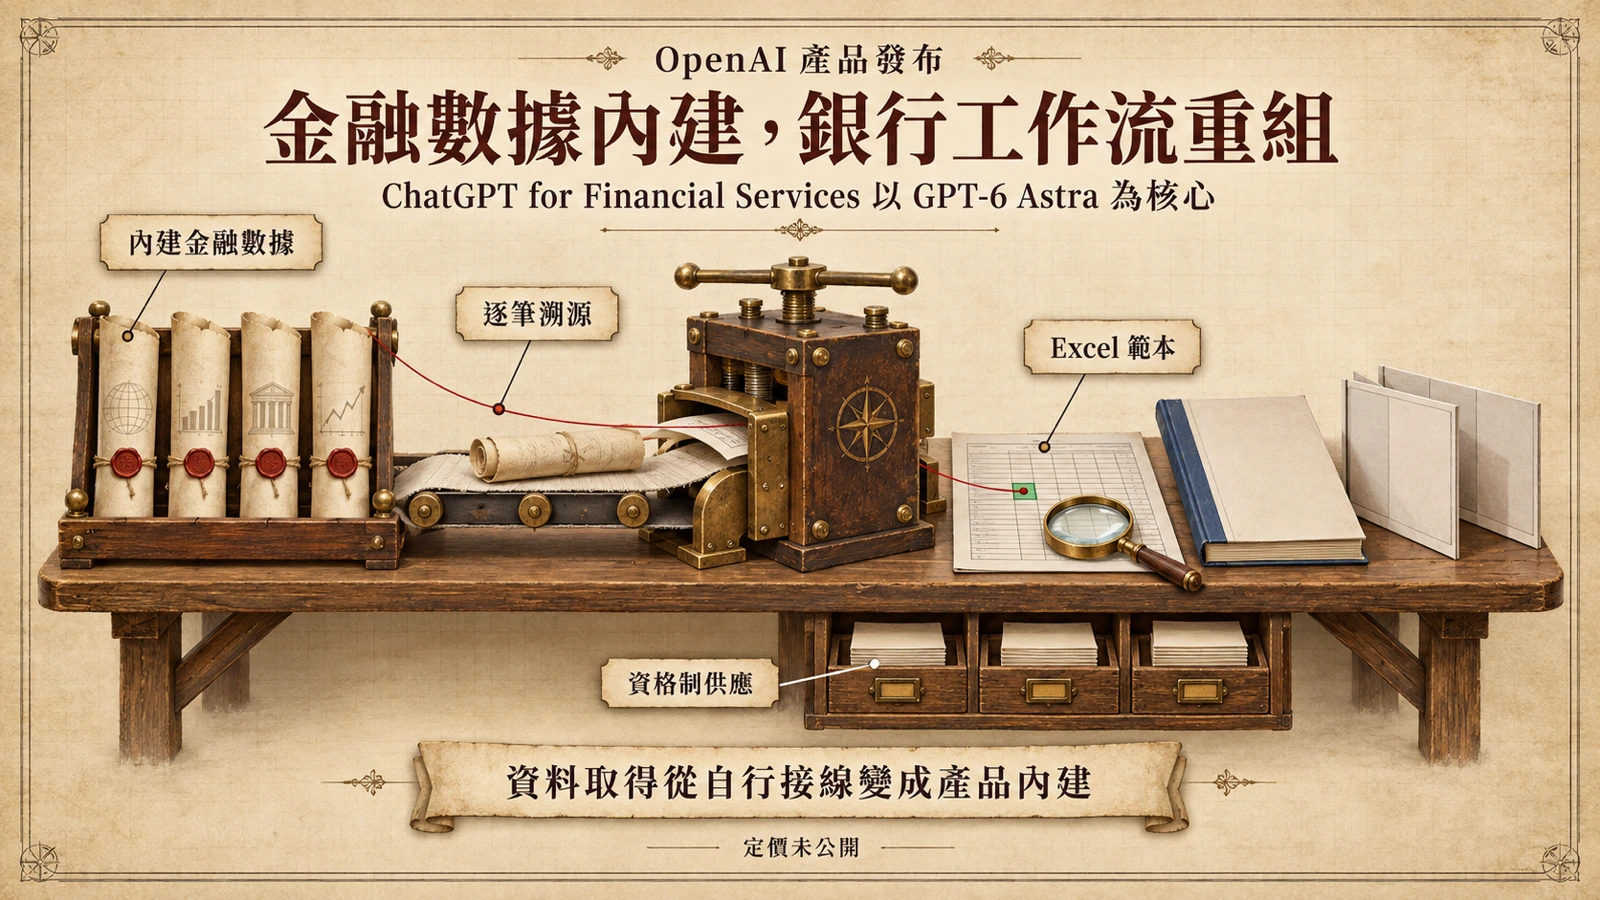
OpenAI 在 2026 年 9 月 10 日發表 ChatGPT for Financial Services。依官方公告的定義,它是一個以 ChatGPT Work 為基底的客製化體驗,把內建金融數據與 GPT-6 Astra 的推理結合,讓團隊產製研究報告、財務模型與客製化的客戶材料。這項產品由 OpenAI 與 Morgan Stanley、Evercore 的設計夥伴關係塑造而成——兩家機構協助 OpenAI 找出金融機構面對的最大挑戰,並引導能走進銀行員日常工作的解法。
這次發布真正值得注意的訊號,是競爭軸線的移動。當前沿模型的通用能力差距逐漸縮小,金融業採購的決定因素轉向資料授權、稽核軌跡與交付格式——這些過去由客戶自行拼裝的部分,OpenAI 選擇親自做成產品。換句話說,這一步賣的不只是模型,而是一條從資料到交付物的工作流。
機制拆解:資料索引託管與逐筆溯源
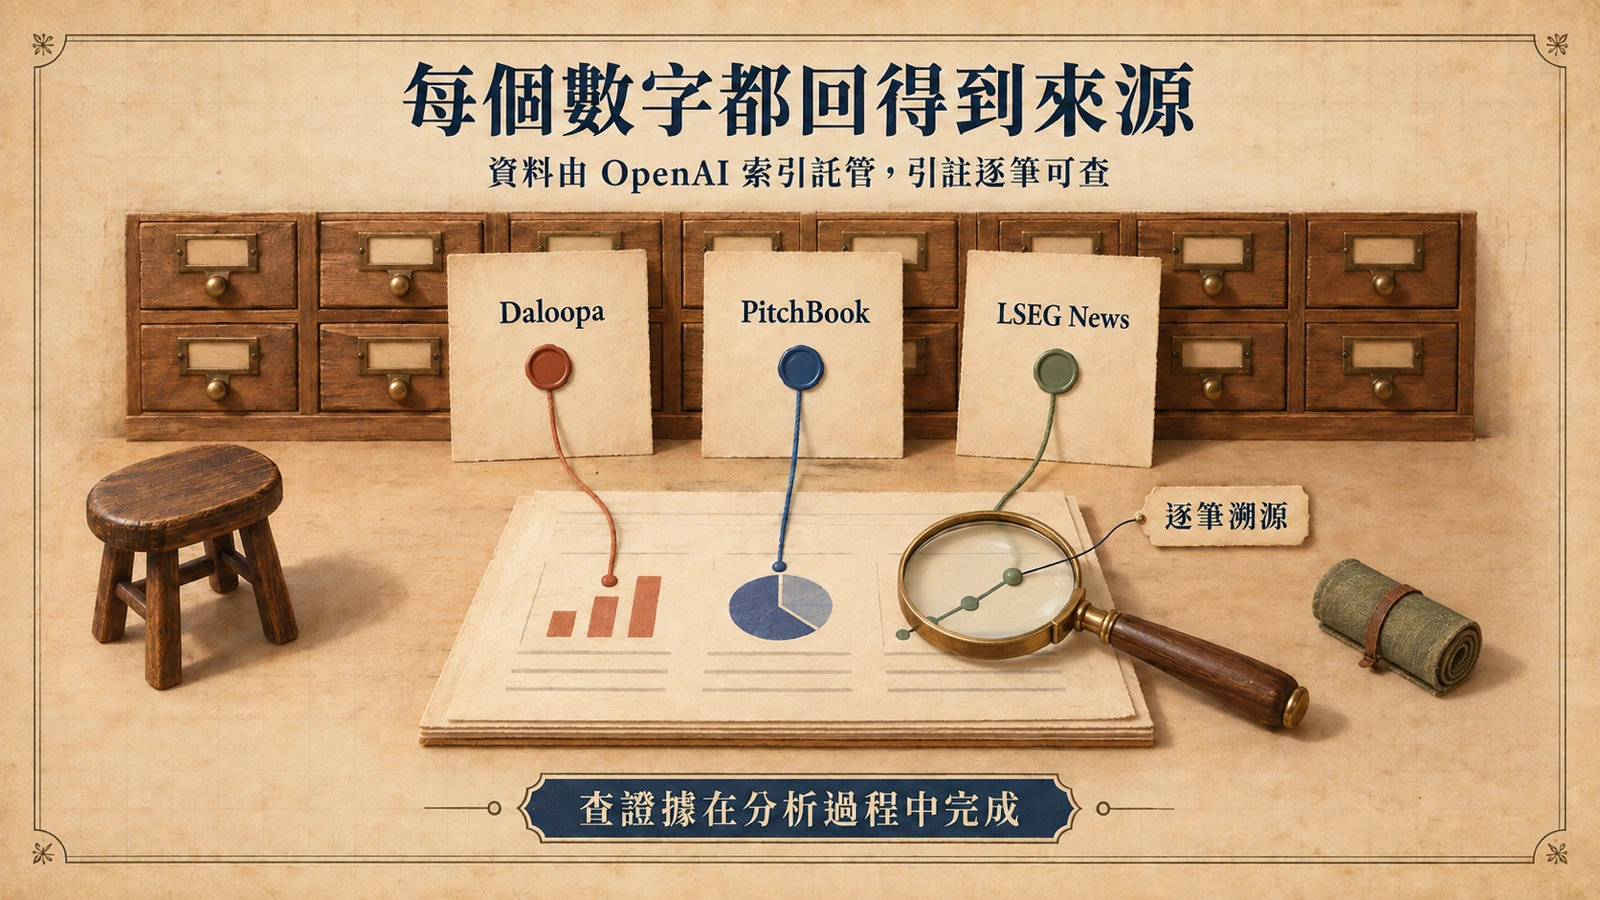
產品的核心機制在於資料的處理方式。官方公告指出,內建的付費級數據來自 Daloopa、PitchBook、LSEG News 與 Crunchbase 等供應商,而且這些資料由 OpenAI 索引與託管,目的是提高準確度,並支撐公告稱為 granular citations 的能力:銀行員可以把數字與主張回追溯到來源,在分析推進的過程中直接查證據。引用粒度從「整份文件」縮到「單一數字」,對一個小數點可能影響估值的行業來說,是流程意義上的改變。
公告同時說明,內建資料是為了移除 MCP 連接器與資料存取的挑戰。這句話有明確的前史:MCP 連接器曾是資料供應商接入 ChatGPT 的主要路徑,LSEG 在 2025 年的新聞稿便宣布為 ChatGPT 用戶與企業客戶提供 MCP(Model Context Protocol)連接器。兩相對照,產品設計的取捨很清楚:與其讓每家金融機構自己接線、自己除錯,OpenAI 把常用資料源預先索引進產品裡。公告也以「透過公司既有訂閱取用」作為小節標題,說明資料授權走的不是重新採購——已經訂閱這些數據商的機構,直接沿用既有授權。
用白話講,連接器模式像是「模型自己去對方家裡查資料」:資料留在供應商端,模型每次提問都透過連接器往返,彈性高,但引用通常只能落到「來自某資料源」的層級,成敗也取決於兩端的設定功夫。索引託管則是把資料先收進 OpenAI 端的索引,模型查的是整理過的副本——逐筆溯源之所以能落到單一數字,前提正是這層索引存在。代價則是資料新鮮度取決於索引更新的頻率與範圍,這點公告並未交代,值得在採購評估時直接向供應商提問。
官方列出的首批應用場景,則勾勒出目標用戶的日常:價值分析、LBO 模型建立、買方篩選、財報分析與 pitchbook 製作——全是投行與股票研究團隊每週都在做的事。
從分析到交付:GPT-6 Astra 與 Office 範本
模型層的設計是原生內建。公告寫明產品提供最先進的前沿智能,包括 GPT-6 Astra,且新模型釋出時將持續開箱即用——對採購方而言,這等於把模型升級包進產品承諾,而不是每次換模型都重新評估一輪整合。若要控制推理開銷,GPT-6 Astra 的推理等級與 token 消耗仍是團隊要自己掌握的變數。
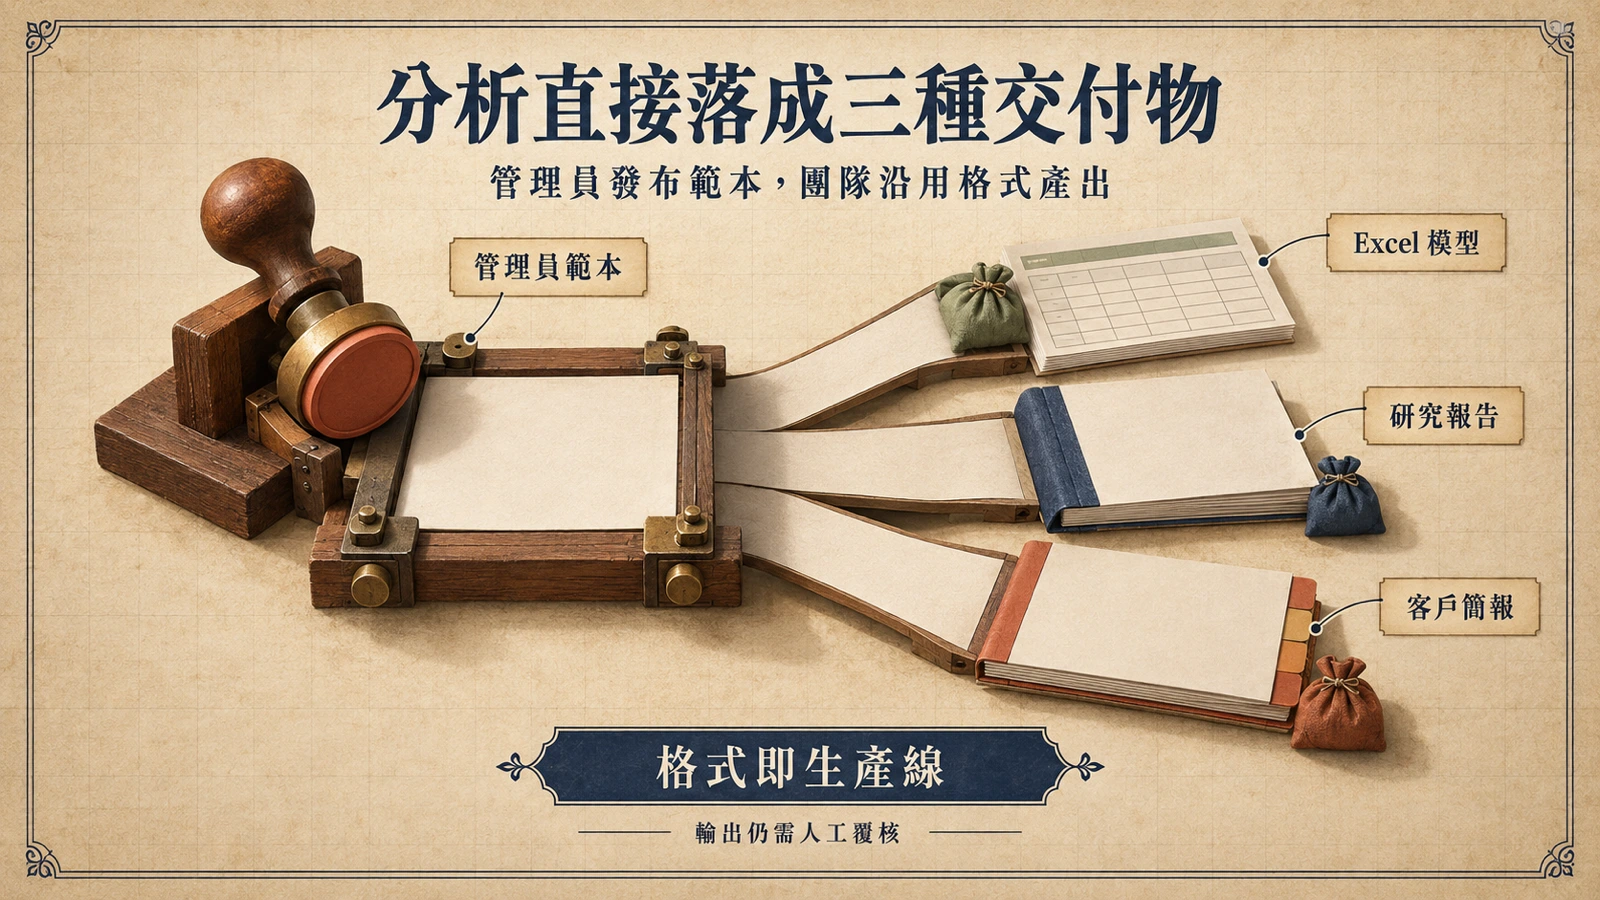
交付層則直接對準投行的產出規格:在 ChatGPT for Financial Services 中,管理員可以發布 Excel、Word 與 PowerPoint 範本,把分析結果變成團隊可用的工件。研究報告、財務模型與客戶簡報的版面本來就是金融機構的生產線規格;把範本交給管理員集中發布,等於讓格式控制權留在機構端,而不是讓每位分析師各自生成、再由主管事後整理。
對採購方還有兩個延伸意義。其一,模型「開箱即用」把升級變成產品路線而不是專案:團隊不必為每次換模型重做整合工程,但模型行為的變化也跟著產品節奏走,機構需要在治理流程裡預留驗收與回歸測試的位置。其二,範本集中發布讓品牌與法遵要求有單一落點:投行對研究報告的揭露格式、假設呈現方式往往有內規,範本機制讓這些內規直接長在工具裡,而不是靠事後檢查把關。
Morgan Stanley 與 Evercore:從 GPT-4 助手到投行工作流
Morgan Stanley 與 OpenAI 的合作並非從這次開始。早在 GPT-4 時代,大摩新聞稿就寫明財富管理部門以 GPT-4 生成僅來自公司內部內容的回應,讓理財顧問更快存取公司知識庫並回應客戶。這次的差別在場景與深度:從財富管理推進到投資銀行與股票研究,從單一助手擴成一整條從資料到交付的工作流。
公告對起點的交代也直白:早期合作讓 OpenAI 把切入點放在投資銀行與股票研究,而這兩個團隊最大的痛點,被明確點出是可靠的資料取得與高品質工件的產出。回頭看產品設計——內建資料對應前者,範本交付對應後者——等於把設計夥伴診斷出的兩個問題,逐一對應到功能。「痛點對得上功能」這種對應關係,也是判斷一個行業專版是認真做事還是換皮貼牌的快速檢驗法。
治理與可用性:資格制與既有訂閱
治理面,公告寫明公司可以集中管理存取權與資料連線,並依託 ChatGPT 的企業級安全與治理控制。對受監管的金融機構來說,這是必要條件而非加分題:誰能碰哪些資料、資料留多久、可否稽核,決定產品能不能走完合規審查。
可用性則採資格制。OpenAI 說明中心以專文說明這項產品包含什麼、如何取得存取,以及可以使用哪些金融數據源;公告的講法是「可供符合資格的金融機構使用」,有興趣的機構須聯絡銷售或既有帳戶團隊。定價未公開,資格標準的細節也未在公告中展開——這對想做成本試算的採購團隊,是目前最實際的障礙。
從說明中心列出的三個問題,也可以反推出導入評估的三張清單:功能與場景清單給前台團隊,確認五個首批場景是否貼合自家工作;資安與治理清單給資訊單位,確認集中管理與稽核設定能否對上內部政策;資料授權清單給採購與法務,盤點既有訂閱與內建數據的重疊。三張清單都過,產品才走得進合規流程。
對產業的影響:垂直化競賽開打
對金融機構,這類產品把「導入 AI」的評估從模型能力擴大到資料治理:內建數據的授權範圍、跨境傳輸、與既有訂閱的重疊程度,都該進入採購清單。對數據供應商,角色從賣終端轉為被內建的供應鏈——進入內建名單等於獲得通路,進不去的則面臨被繞過的風險。對 OpenAI 的競爭者,這一步把戰場從模型評分拉到行業工作流,而試算表與辦公文件正是明確的爭奪點:微軟把 MAI 模型帶進 Excel 與 Copilot 的動作,顯示同一條生產線上早有別的選項。
從產品線布局看,這也是 OpenAI 持續拆分 ChatGPT 的最新一步:八月中有青少年專屬體驗,如今是金融業專版。共同模式都是「把某個群體最需要的安全設定或資料來源做成預設值」,但兩者的兌現方式不同:青少年的防護由系統自動套用,金融業的資料則要用既有訂閱換取——一個以使用者的安全為中心,一個以機構的資料資產為中心。
回到分析師的日常,五個首批場景共同的工時黑洞其實不是分析本身,而是環繞分析的搬運工作:把數據從終端貼進試算表、把模型調成公司格式、把關鍵數字逐一標上出處。這項產品把三段搬運分別交給內建資料、集中範本與逐筆溯源——節省的是流程時間,不是判斷時間。估值假設怎麼定、可比公司怎麼挑、結論怎麼對客戶負責,仍然是人的工作;這也是「輸出仍需人工覆核」在金融業是常識而非免責套話的原因。
限制與觀察指標
限制同樣清楚。第一,定價與資格標準未公開,機構難以事先估算成本。第二,「提高準確度」目前是 OpenAI 的自述,尚無第三方驗證;逐筆溯源降低查證成本,但不等於保證數字無誤——模型仍可能選錯來源或誤讀報表。第三,內建資料的範圍、更新頻率與對亞太市場的覆蓋深度,公告均未展開,這正是非美系機構評估時最該先問的問題。第四,治理控制是工具而不是免責條款:輸出的研究與模型最終仍由金融機構自己負責,人工覆核流程不該因為溯源方便而撤掉。
值得追蹤的後續指標有四個:定價與資格細節何時公布、內建數據商名單是否擴充、首批客戶除了兩家設計夥伴還有誰,以及新模型開箱即用的承諾,在下一次模型迭代時是否如期兌現。