從一支 Python 函式庫,到 10 億人的儲存平台
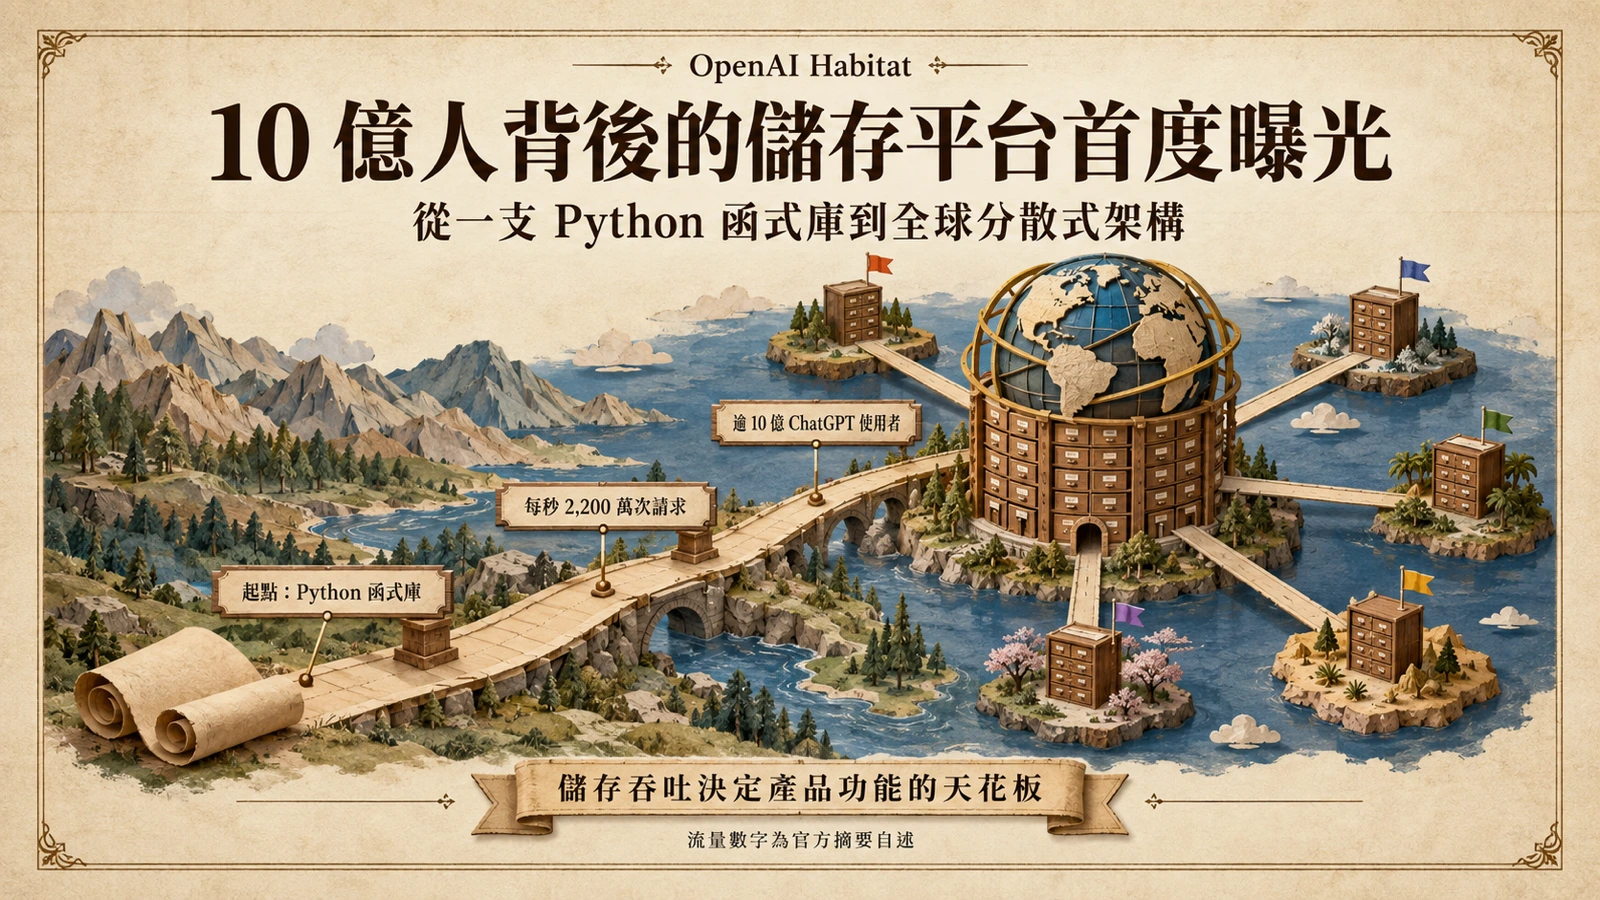
9 月 11 日,OpenAI 的工程文章《Rapidly scaling online storage to serve over 1 billion ChatGPT users》首度有系統地公開 ChatGPT 背後的線上儲存平台 Habitat。官方摘要用一句話交代它的身世與規模:Habitat 從一支 Python 函式庫,演進成服務超過 10 億 ChatGPT 使用者、每秒 2,200 萬次請求的全球分散式儲存平台。
對照 OpenAI 過往的溝通習慣,這次公開有三個不尋常之處。其一,儲存層向來是「使用者看不見、對手最想看」的基礎設施,如今主動攤在檯面上。其二,文章標題明確標示 part one,代表這是系列首部,細節將分批揭露。其三,摘要直接點名起點是 Python——等於向外界交代,這套全球系統最早的形態,只是一支方便工程師存取資料的函式庫。
「線上儲存」在聊天產品裡扮演什麼角色
談 AI 服務的規模時,焦點幾乎都在 GPU 與模型推論,但每一次對話能夠延續、上傳的檔案能被反覆讀取、帳號能在任何裝置登入,靠的是另一層:線上儲存。它負責低延遲、高頻次的讀寫——對話狀態、使用者設定、檔案中繼資料這類「下一個請求馬上要用」的資料,而不是模型權重那種一次載入、長期不變的大檔。對使用者的實際意義是:對話可以多長、檔案可以多大、跨裝置同步多即時,天花板往往不在模型,而在這一層的吞吐與延遲。
「從函式庫長成平台」這句話本身值得拆解。函式庫是一段跑在應用程式行程裡的程式碼:呼叫方便,但效能、記憶體與故障範圍都跟應用程式綁在一起。平台則是獨立的服務層,有自己的容量規劃、部署節奏與延遲預算,應用程式經由網路呼叫它。一支函式庫要升級成平台,從來不是重寫程式碼那麼簡單,而是責任邊界的重劃——儲存從「應用的一部分」變成「要對全公司服務水準負責的產品」。Habitat 走的正是這條路,而它的規模是 10 億人。
為什麼 Python 函式庫會遇到天花板
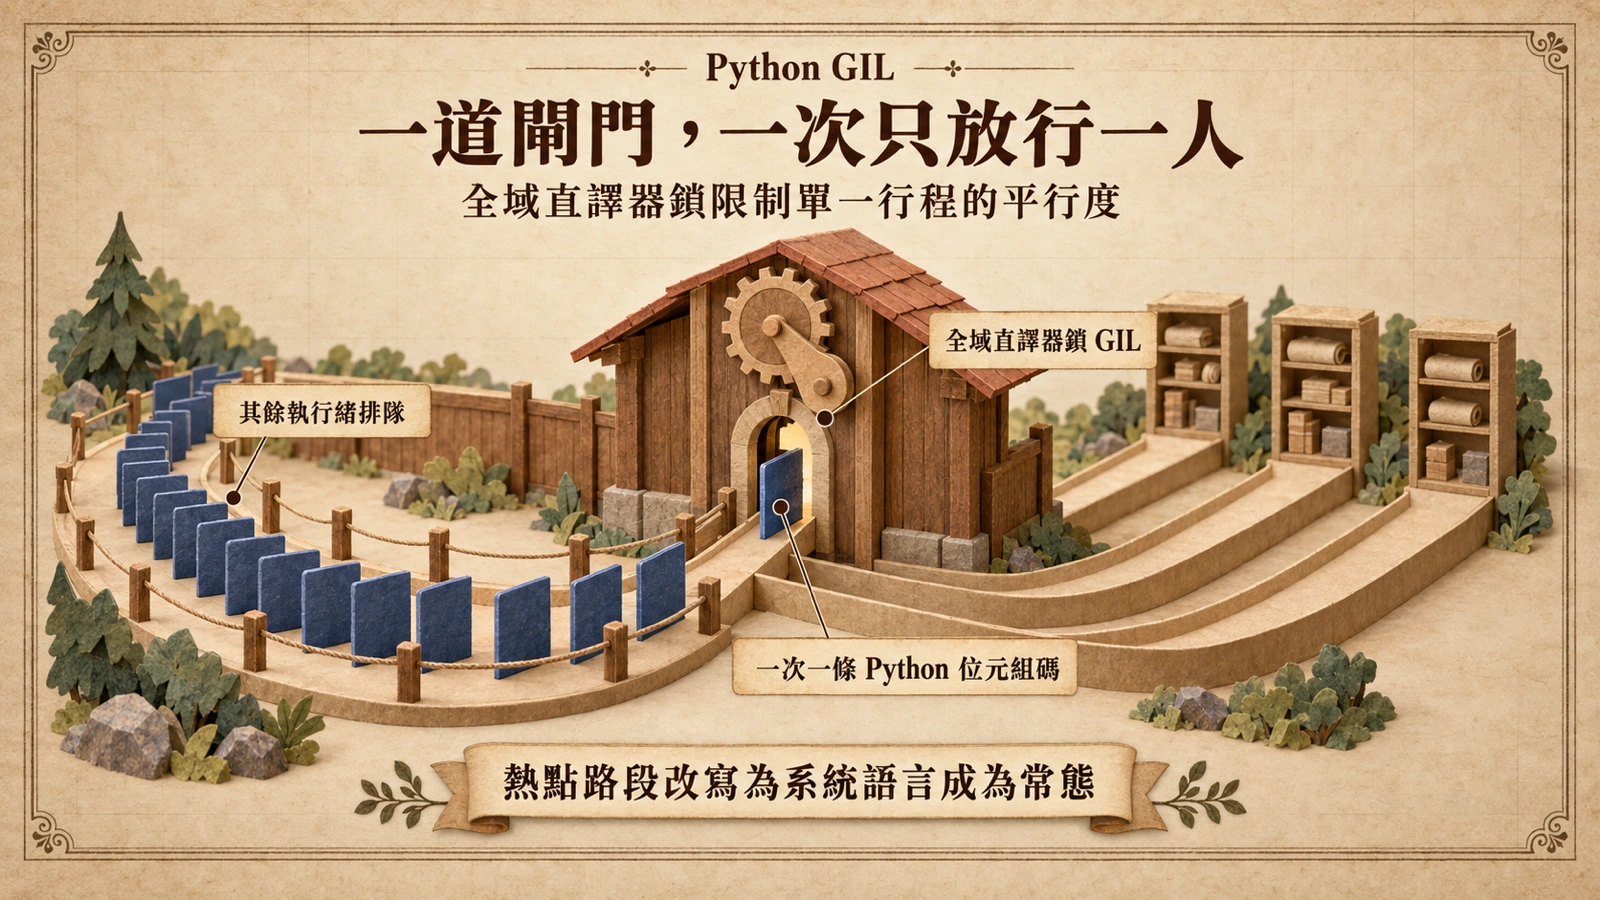
官方摘要沒有解釋 Python 函式庫為什麼走不下去,但 Python 官方文件對這門語言的執行模型有權威界定:Python 官方詞彙表對全域直譯器鎖(GIL)的定義,是「讓 CPython 直譯器確保同一時間只有一個執行緒執行 Python 位元組碼」的機制。
這對講求快速開發的應用程式不是問題,對要吃下每秒上千萬次請求的儲存層卻是硬限制:CPU 密集的序列化、壓縮與請求路由若跑在這個執行緒模型裡,多核機器的平行度吃不到;工程師能做的繞道——多行程、把熱點搬進 C 擴充——每一條都在增加系統複雜度。
這不是 Python 的缺陷,而是工作負載形態變了。當儲存從「應用裡的一個模組」變成「全球服務的資料平面」,直譯帶來的每一點開銷都會被乘以請求量級,把熱點路徑改用貼近機器的語言重寫,就成了工程上的自然選擇。官方摘要沒有說明終點語言,但媒體對內文的轉述給出了答案的輪廓——見下一節。
官方摘要沒寫的:媒體轉述的 Rust 重構與 500 PB
官方摘要的邊界值得注意:它只說「演進成全球分散式儲存平台」,沒提實作語言、資料總量與區域數。這些細節目前主要來自媒體對文章內文的轉述。DoNews 的報導指出,Habitat 從 Python 到 Rust 的重構已在 2026 年第二季完成,平台現在每秒處理超過 7,000 萬次請求、服務逾 10 億使用者、管理超過 500 PB 資料。
換句話說,OpenAI 親口證實的是「Python 起源、全球分散式、10 億使用者」;Rust、500 PB 與 7,000 萬 RPS 則屬二手轉述,正式引用前應以系列後續篇章或官方文件回查確認。若 Rust 之說屬實,這也是大型 AI 服務把資料平面往系統語言搬遷的又一例——趨勢本身比單一新聞更值得記住。
兩組流量數字對不上,該相信哪一個
讀到這裡會發現前文有兩個請求量:官方摘要的每秒 2,200 萬次,與媒體轉述的每秒逾 7,000 萬次。兩者差距超過三倍,不可能同時描述同一個當下。可能的解釋有三:摘要寫的是里程碑時點(例如突破 10 億使用者當下),內文給的是現況;兩組數字統計口徑不同(是否含快取命中、是否只計特定服務);或其中一方轉述有誤。官方摘要沒有提供足以裁定的細節。
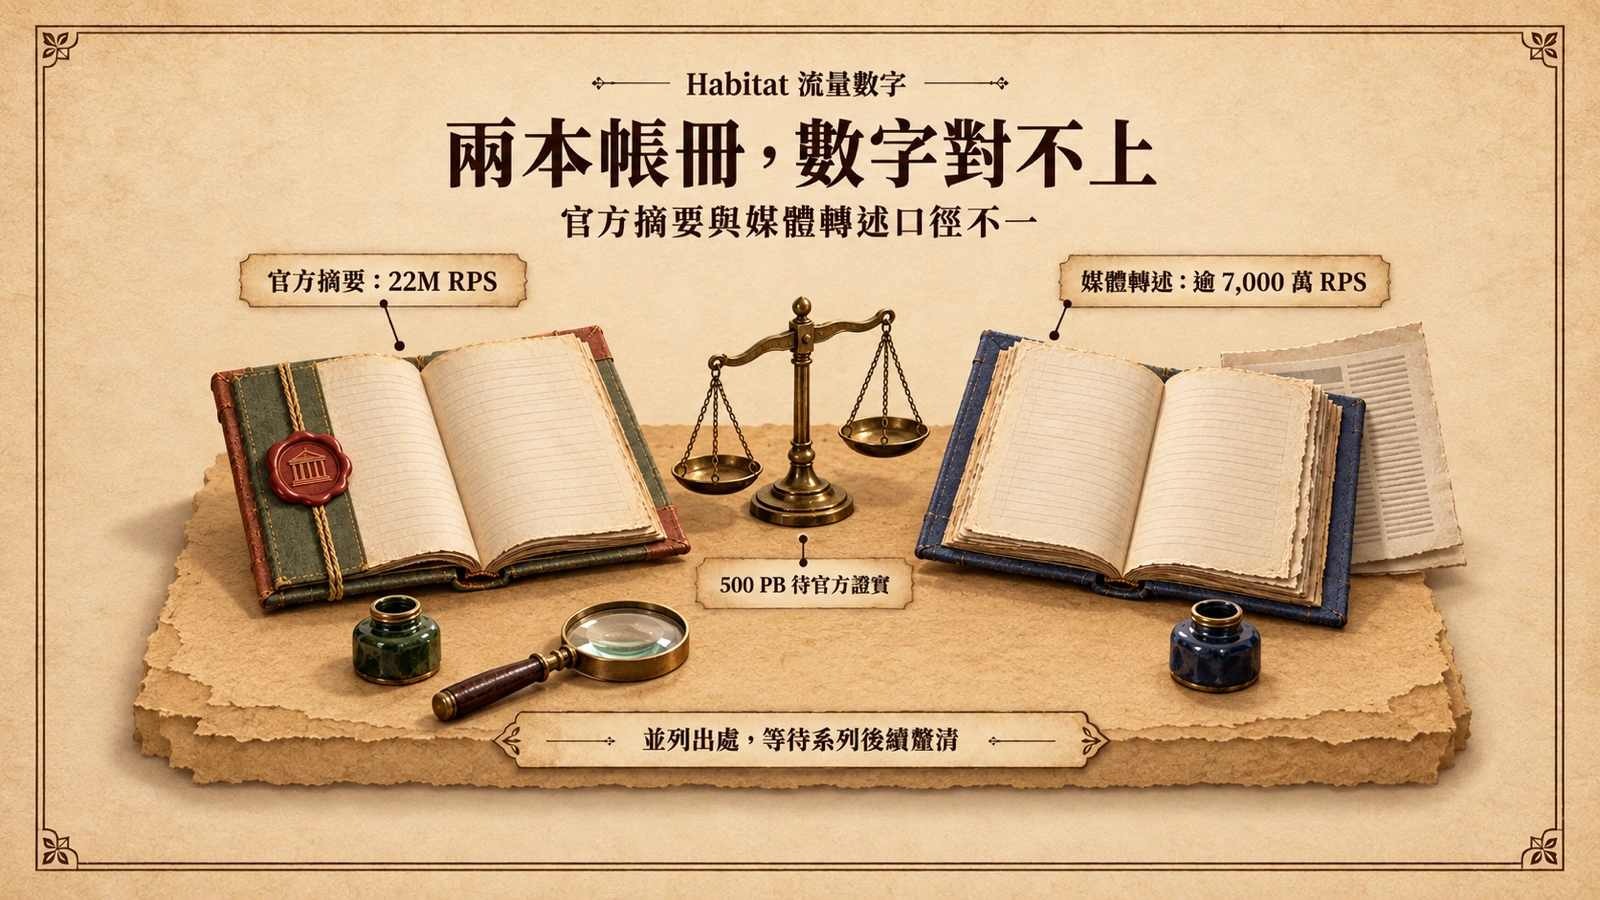
與其挑數字聳動的版本,不如並列出處與限制:2,200 萬 RPS 可逐字回查官方摘要;7,000 萬 RPS 與 500 PB 目前只有媒體轉述支撐。值得追蹤的後續,是 part two 是否釐清口徑,以及 OpenAI 是否以架構文件或技術演講補充細節。
儲存規模的另一半故事:資料保留與治理
規模數字之外,另一個同樣影響使用者的問題是:這些資料留多久、誰看得到。OpenAI 八月中向企業客戶提出的零資料保留承諾寫得明白:合資格的 API 客戶得到明確承諾,OpenAI 在處理請求後不保留提示詞或模型回應;除非企業客戶明確選擇加入,資料不用於訓練模型。同一份公告並說明,Private Safety Processing 計畫於 9 月開始推出,讓安全系統能跨多次互動識別風險,而 OpenAI 人員無法存取底層內容。
把兩件事放在一起看才完整:Habitat 說明 OpenAI 有能力把 10 億人的資料放上全球低延遲的儲存層;零資料保留與 Private Safety Processing 則說明這家公司如何在「把資料存起來」與「不讓內容被看見」之間劃界。對評估 AI 供應商的企業而言,後者往往比吞吐數字更關鍵——採購文件裡真正難談的條款,從來不是效能,而是資料治理。
對工程團隊的啟示與未定案的部分
對工程圈最有價值的部分不是數字,而是它再次驗證了一條決策路徑:先求快,用最順手的語言把功能做出來;等規模證明產品成立,再把瓶頸路段換成貼近機器的實作。這條路徑近年反覆出現——Shopify 把行動 App 從 React Native 遷回 Swift 與 Kotlin,官方理由之一正是 coding agent 已壓低「把 App 寫兩次」的成本;語言生態也在回應同樣的壓力,Mojo 走到 1.0,用 Python 語法包住系統語言骨幹,讓「寫起來像 Python、跑起來像系統語言」成為現實選項。
對正在長大的團隊,可操作的判斷是:別在第一天為想像中的規模過度工程,但要留下觀測點——知道哪個模組會先變成瓶頸,比一開始就選對語言更實際。Habitat 的故事也提醒,瓶頸往往不在模型,而在模型周邊那圈不起眼的資料層。
未定案的部分同樣該記下:其一,官方摘要與媒體轉述的流量數字落差待解;其二,重構的遷移策略、如何驗證新舊系統行為一致,官方摘要均未提及,通常會是系列後續的內容;其三,「服務 10 億使用者」的統計時點與方式仍待釐清。在 OpenAI 補上這些之前,引用相關數字時適合先回到官方連結核對。