授權條款出爐:紅線畫在巨型託管商
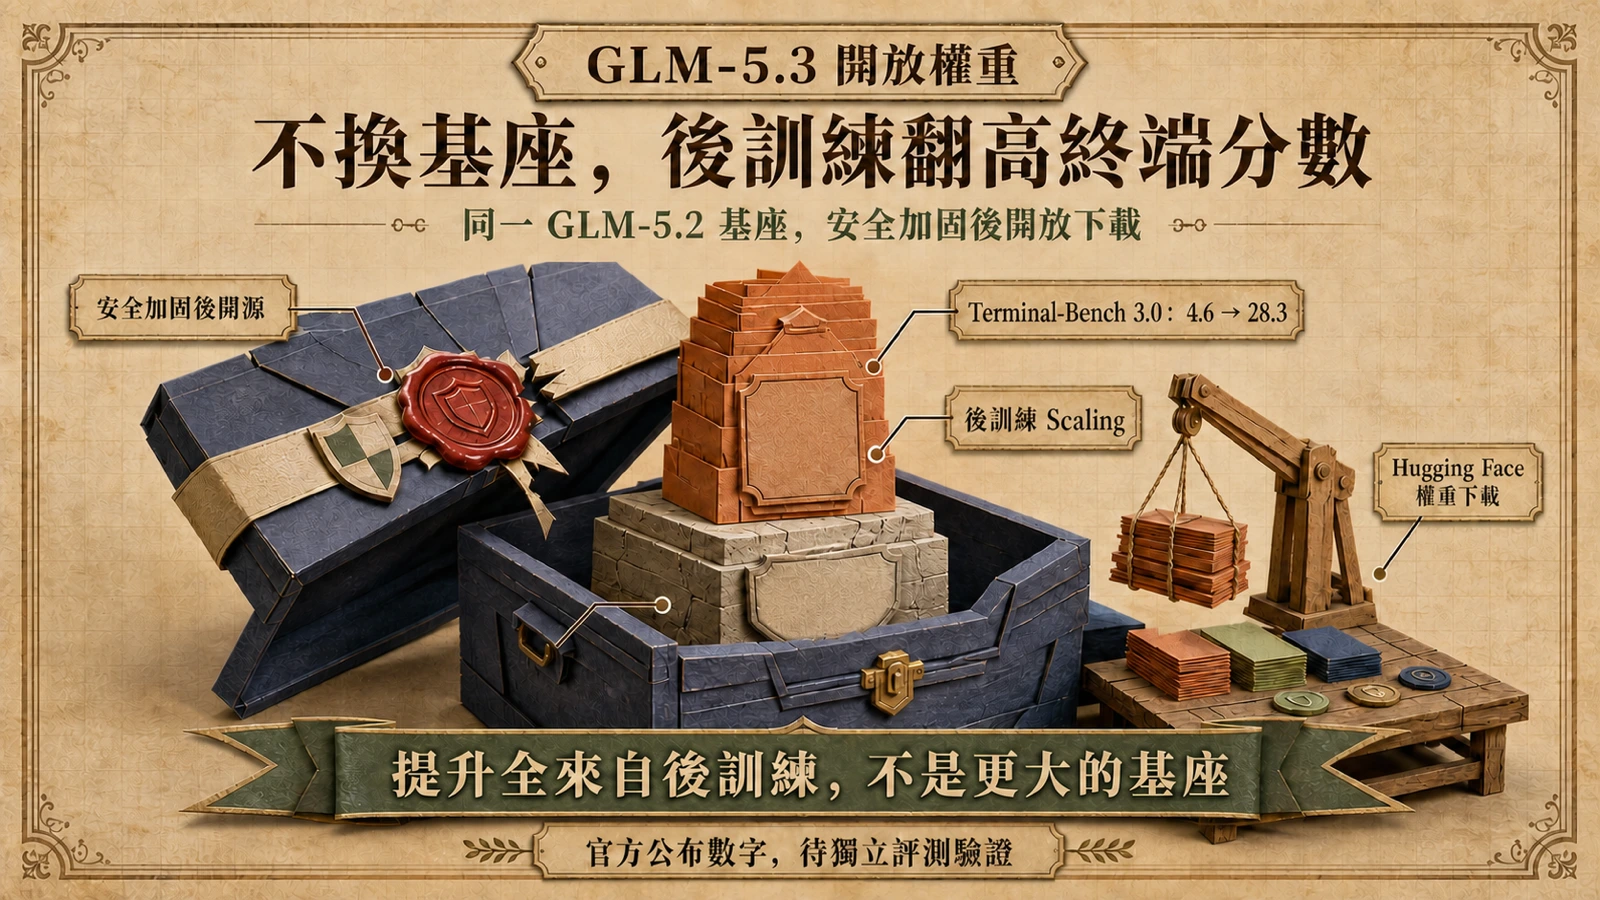
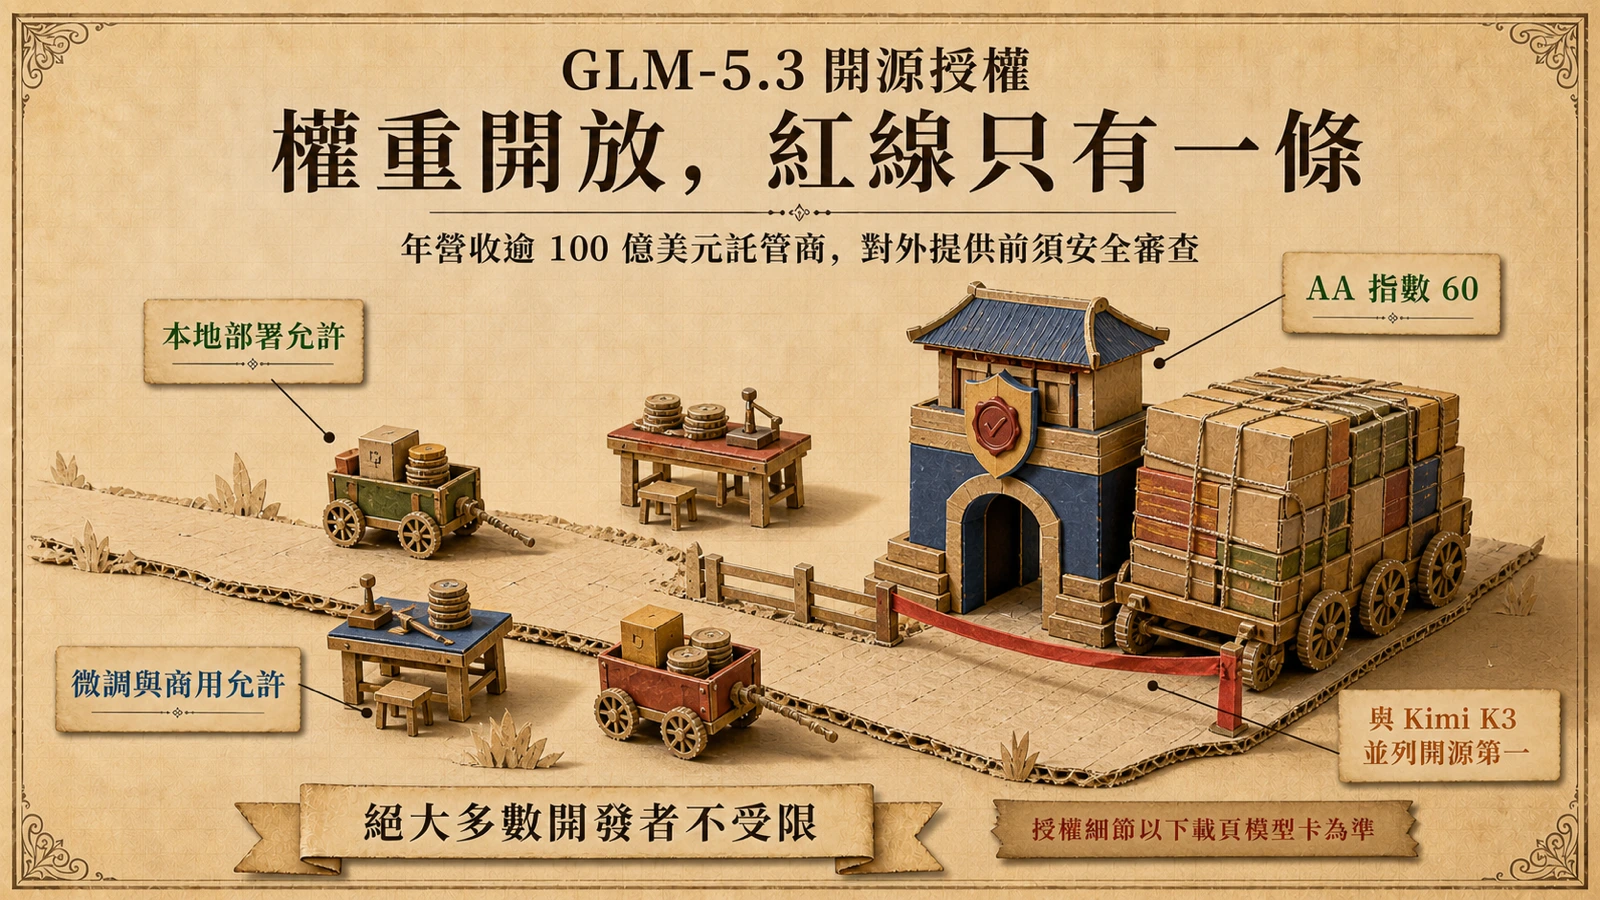
智譜在 8 月 28 日晚間宣布開源 GLM-5.3 模型權重、正式開放下載,官方定位它的強項是複雜編碼、防禦性網路安全與長程任務,支援本地運行與個人化定製——權重開放與模型能力本身,見〈GLM-5.3 開放權重〉。當時懸而未決的問題只剩一個:授權條款到底是什麼?答案在一天內揭曉。依 IT之家報導引述智譜 Z.ai 負責人李子玄的說明,GLM-5.3 的使用須遵循 GLM-5.3 許可協議,支援本地部署、模型微調與商業化使用;僅當年營業額超過 100 億美元(現匯率約合 674.21 億人民幣)的機構,擬將 GLM-5.3 作為外部模型服務對外提供時,才必須先進行安全審查。
把這段話拆開看,對絕大多數開發者與企業而言,這是一份接近「隨你用」的授權:從 Hugging Face 的 zai-org/GLM-5.3 儲存庫下載權重、自架、微調、把模型裝進自己的商業產品,都沒有額外門檻。整份條款真正畫出來的紅線只有一條,而且畫得相當精準——它指向的不是「用模型的人」,而是「把模型當成服務規模化轉售的超大機構」。
為什麼掛安全審查:模型本身會找漏洞
要理解這條紅線為什麼存在,得先看 GLM-5.3 的能力結構。GLM-5.3 發布公告的完整報導載明,它與 GLM-5.2 使用相同的基礎模型、所有提升均來自後訓練,內部 Z.ai Code Bench 較前代提升 50%;發布時官方點名的新強項,正是防禦性網路安全。
數字可以說明這個強項的分量。依智譜發布時公布、經鈦媒體與新浪財經報導的評測數據:在從白盒原始碼出發、以觸發程式故障來識別並驗證漏洞的 CyberGym,GLM-5.3 得分 83.5%,高於 GLM-5.2 的 77.2%,與 Anthropic Mythos 5 的 83.8%、GPT-5.6 Sol 的 83.6% 基本相當;但在更考驗深度推理、要求理解真實漏洞成因並完成利用的 ExploitBench,GLM-5.3 的 54.4% 仍明顯落後 Mythos 5 的 78.0%。計時完成漏洞利用的 ExploitGym 也呈現同一趨勢:GLM-5.3 兩小時完成 105 項、六小時 130 項,Mythos 5 則是 181 與 247 項。官方的詮釋是「安全能力的出現並不偶然,安全工作本質上是約束嚴格的編碼能力」,並發布了與國內安全團隊合作發現 2,404 個漏洞、其中 1,088 個為中高危的實戰成果。
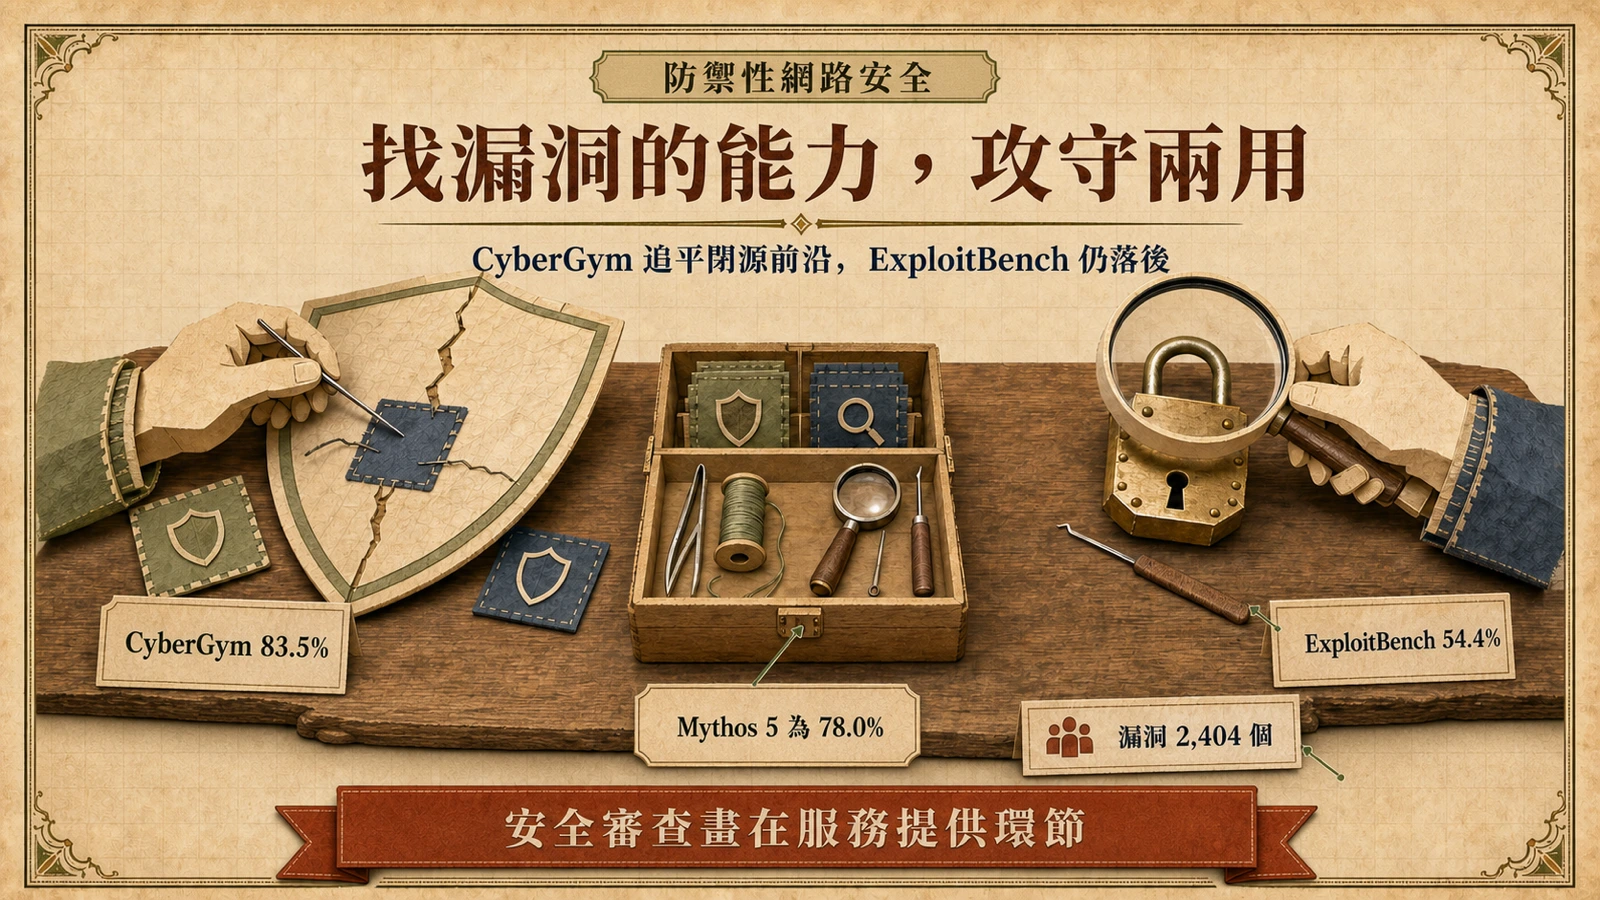
這種能力天生一體兩面:同一雙能看穿程式碼缺陷的眼睛,防守方拿來審自己的系統,攻擊方拿來審別人的。權重一旦開放下載,兩種用法都無法召回。智譜的授權設計因此不在「用」上設限,而是把管制點收斂到風險被放大的那一環——當一個年營收超過 100 億美元的機構把 GLM-5.3 包成對外服務,單一模型的能力就變成平台級的曝險,安全審查正是畫在這個節點上。
AA 指數 60 分:開源第一梯隊的位置
授權之外,這次開源也把 GLM-5.3 的市場定位講得更清楚。依智譜先前公布、經 IT之家引述的數據,GLM-5.3 在 Artificial Analysis Intelligence Index(AA 綜合智能指數)取得 60 分,進入全球前沿模型能力區間,與 Claude Fable 5、GPT-5.6 Sol 等閉源旗艦處於同一水平,並與 Kimi K3 並列開源模型第一;智譜同時強調,它以更小的參數規模與更低的調用成本,顯著降低了前沿模型能力的使用門檻。
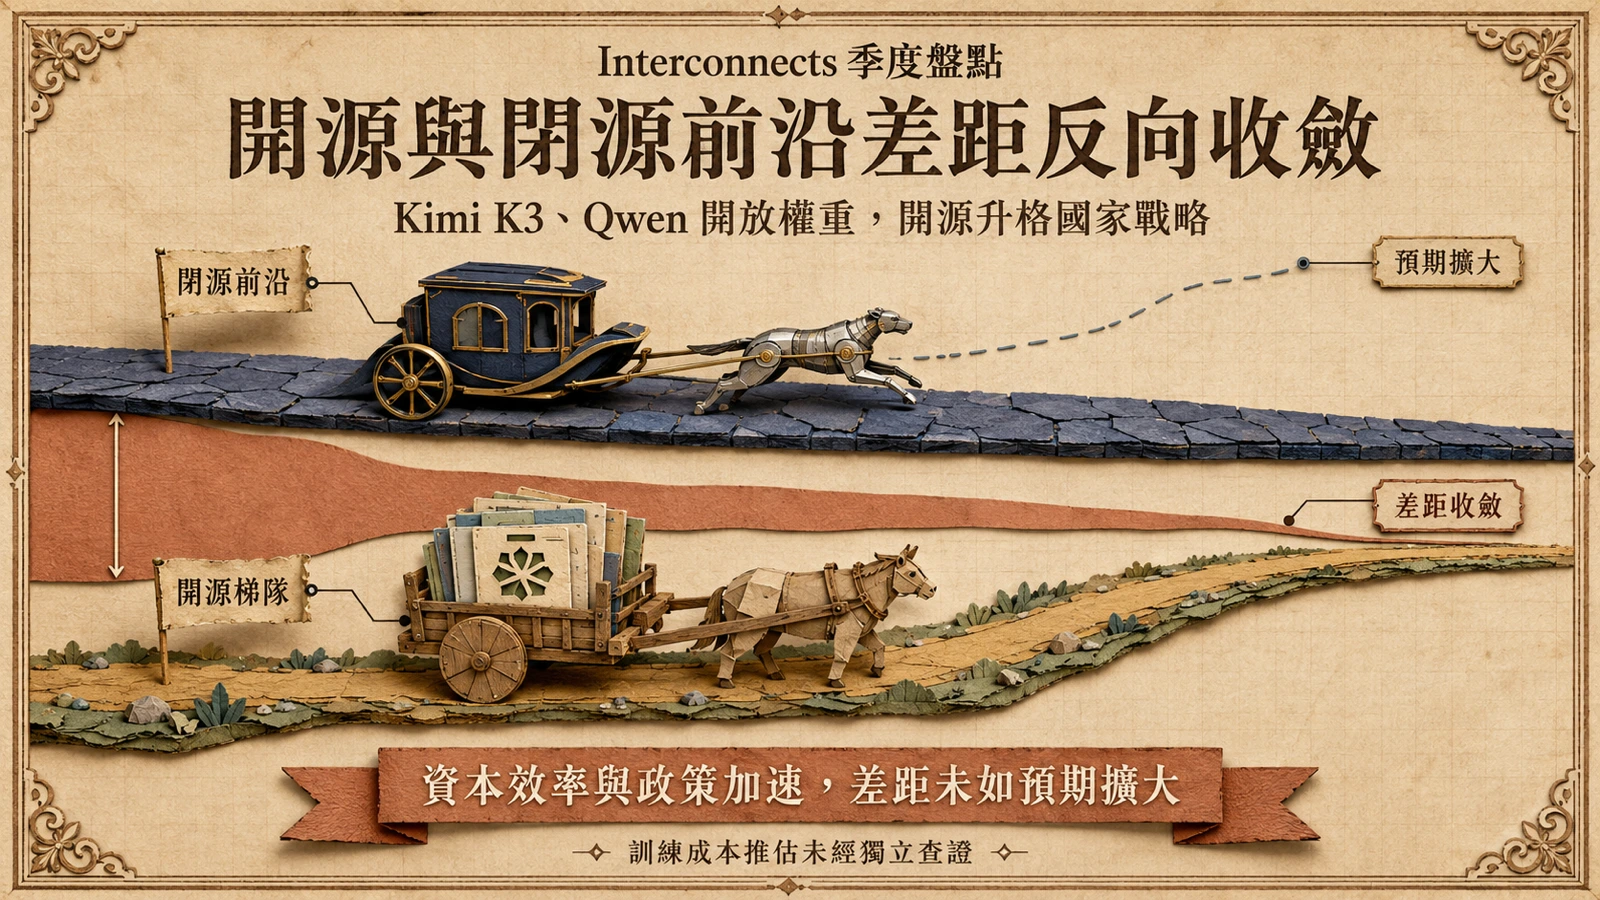
這個位置並不意外。自 Kimi K3 發布以來,開源模型與閉源前沿的差距就被認為正在反向收斂,GLM-5.3 與 Kimi K3 在 AA 指數上並列,等於把「開源第一梯隊」從單一模型變成雙頭格局,也讓「該自建還是該訂閱閉源旗艦」的評估多了開源選項。對採購端的意義在於參考點變了:過去評估開源模型,比較對象多半是上一代開源旗艦;現在開源第一梯隊直接以閉源旗艦為對照組,自建方案的說服力隨之提高,「開源、更便宜、智能同檔」三件事綁在一起,正是這波開源攻勢的敘事主軸。不過有兩個但書:其一,60 分是廠商自行引述的第三方指標,最終以 Artificial Analysis 官方榜單的更新為準;其二,「並列開源第一」的評測版本與比較口徑並未完整揭露,獨立重測出現之前,宜當作定位訊號而非定論。
條件式開源:從 MIT 走向「開放但不放任」
把時間軸拉長,這份授權條款標誌著智譜開源策略的分水嶺。前代 GLM-5.2 採 MIT 授權,幾乎不設條件;GLM-5.3 則首次加入營收門檻與安全審查條款。兩種授權的實際差異落在下游義務上:MIT 之下任何人可任意使用、修改、再散布,連原始碼都不必開放;GLM-5.3 的條款則把「對外提供模型服務」這一種用途單獨拉出來設條件,其餘用途維持開放。對習慣 MIT 的開源社群來說,這是從「完全自由」走向「有條件自由」;但對企業法務來說,單一、明確、可檢查的條件反而容易內部通行。這不是智譜一家的選擇,而是高能力開放權重模型的共同走向——模型能力越接近前沿、特別是具備資安攻防潛力時,發布方越傾向「開放權重、保留最後一關」。
政策面的拉扯方向相同。白宮與 AI 業者敲定的自願安全框架,把開放權重模型排除在測試之外,監管真空讓廠商自律的責任更重;而產業界要求開放權重的連署已從 25 家增至 133 家,關閉權重的路同樣走不回去。GLM-5.3 的做法提供了中間路線:就目前公布的條款而言,唯一附帶條件的場景是超大機構對外提供服務,一般使用與商用的大門保持敞開。
誰該現在導入:三種情境與兩套計價
對照授權條款,導入決策可以分成三種情境。情境一是自架或微調:適用於絕大多數企業,下載權重後在自有 GPU 部署,依公布條款沒有額外門檻;真正要評估的是硬體成本與主流推理框架的支援成熟度——權重檔案規模、vLLM 與 SGLang 等框架的支援進度、可用的微調配方,都還需要社群實測補齊,急於上線的團隊最好預留驗證時間。情境二是訂閱與 API:Z.ai 國際站訂閱頁已將 GLM-5.3 與 GLM-5.3-Flash 列入方案,可在 Claude Code、Codex、Cline 等 20 餘種編碼工具中使用;官方代理環境 ZCode 亦以 GLM-5.3 為官方 Harness。情境三是雲端轉售:年營收 100 億美元以上的機構,把 GLM-5.3 作為對外模型服務之前,先走安全審查。
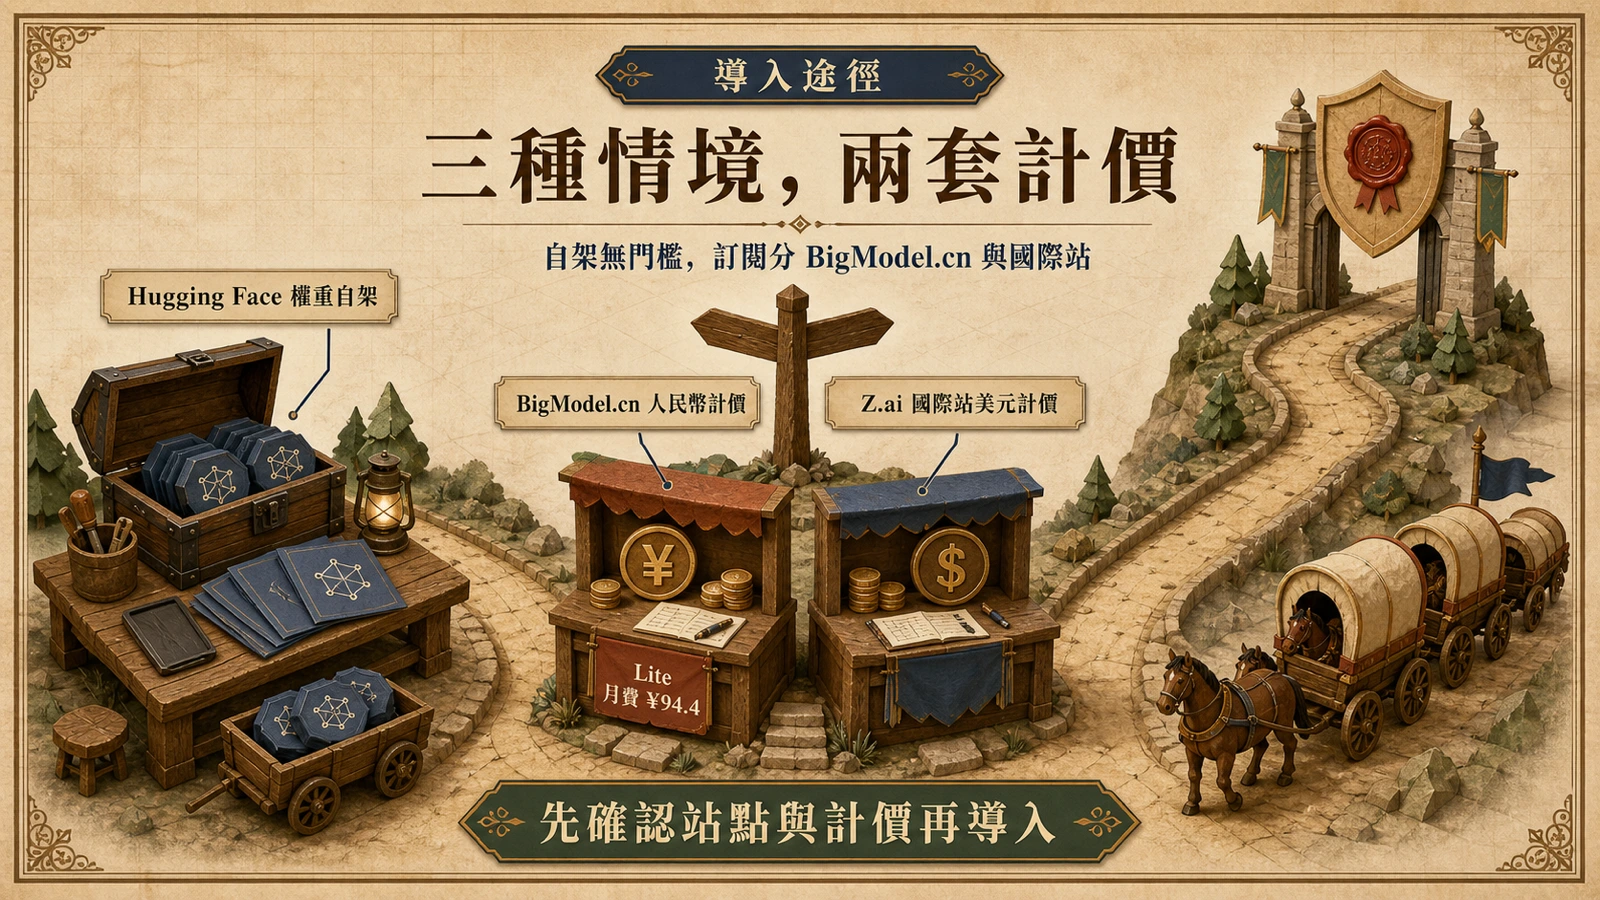
計價要特別留意雙軌。ZCode 頁面列出的中國站 BigModel.cn 方案,GLM Coding Lite 為每月人民幣 94.4 元、Pro 為 430.4 元、Max 為 862.4 元;國際站則以美元計價、方案每月 18 起。兩站不僅幣別不同,服務條款與資料規範也不同,企業採購前應先確認自己適用哪一個站點,再估算長期成本。
限制與後續觀察
這份授權還有幾個待補的細節。第一,目前條款內容出自負責人經媒體轉述的說明,「年營業額」採集團合併營收還是單一法人、安全審查由誰執行、標準與時程為何,都尚未公開;最終授權文本應以下載頁模型卡為準,正式導入前務必逐條核對。第二,AA 指數 60 分與「並列開源第一」均為廠商引述,待 Artificial Analysis 榜單與獨立評測驗證。第三,安全審查的實際強度未知——它是流程性的備案,還是實質的技術稽核,將決定這條紅線的真正重量。
後續值得追蹤的指標有三:Hugging Face 模型卡上最終授權文本與轉述版本的一致性;獨立榜單對 GLM-5.3 的重測結果;以及其他實驗室是否跟進「營收門檻+安全審查」的條款設計。如果這種單點管制成為高能力開源模型的標準配備,開源與閉源的界線將越來越不在「能不能下載」,而在「誰能把能力規模化地賣出去」。