九月六日的報告說了什麼
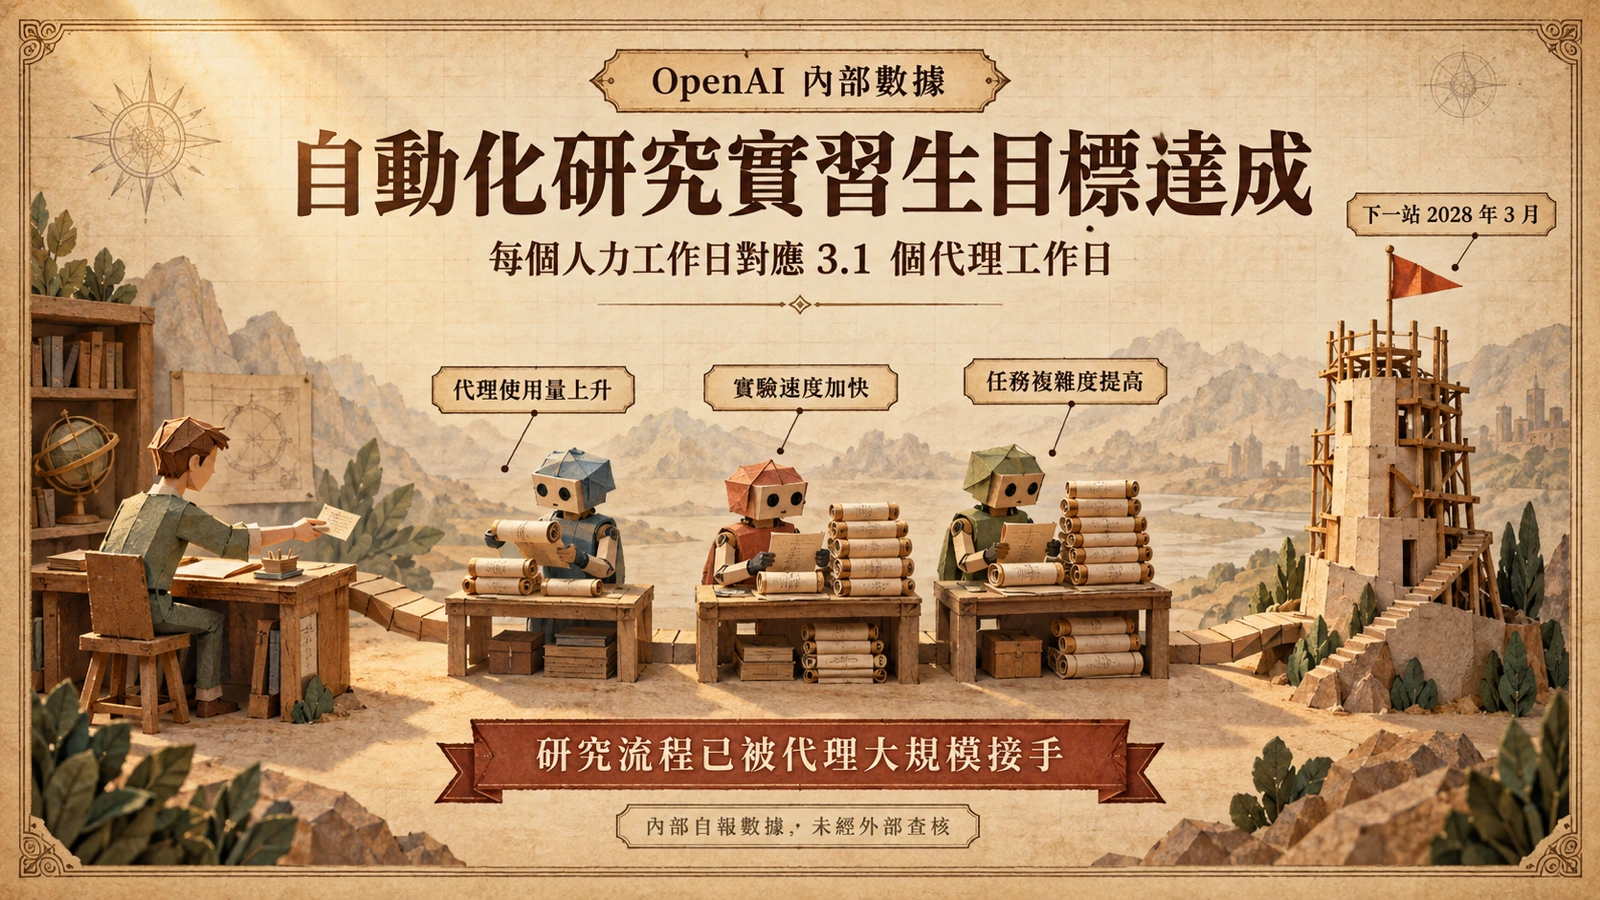
OpenAI 在 2026 年 9 月 6 日發布《Research acceleration: The view inside OpenAI》,一次少見的自我揭露:公司把內部研究組織被自家編碼代理改寫的程度,用數據攤給外界看。報告沿三條軸線展開——代理使用量、實驗速度與任務複雜度,並給出兩個明確訊號:一是宣布已達成「自動化研究實習生」目標;二是把下一個里程碑定在 2028 年 3 月的全自動 AI 研究員。
外界引用最多的數字是工作量比例:截至 8 月中旬,OpenAI 研究組織每投入一個人力工作日,代理系統對應貢獻 3.1 個代理工作日的研究工作量。另一個同樣關鍵的觀察是成長結構——研究者的用量成長快於公司其他部門。換句話說,在 OpenAI 內部,AI 用量成長最快的族群,正是最懂 AI 的那批研究員。
「自動化研究實習生」的定義與由來
「自動化研究實習生」不是新詞。AI Weekly 整理的時間線把目標源頭追溯到 2025 年 10 月的一場直播,當時給出的定義是:一套能在人類指導下,接下「一個人要花上數天才能完成」的明確研究任務的系統,期限正是 2026 年 9 月。今年 4 月,首席科學家 Jakub Pachocki 受訪時還在說 “I definitely see this as a signal that something here is on track”,當時報導的標題仍是「離研究實習生能力越來越近」。到了 9 月 6 日,措辭從「接近」變成了「達成」。
定義本身值得停在這裡看清楚。「實習生」等級不是「研究員」等級:它處理的是有明確規格、可交付的任務——跑一組實驗、整理一批結果、寫出可復現的紀錄——而問題設定、判斷與驗收仍由人類研究員負責。這也是目標能在時限內宣布達成的原因:它是可測量的工程目標,不是模糊的能力宣稱。文章發布後,OpenAI 資深研究員 Noam Brown 形容這是該公司發布過最有趣的文章之一,並預期趨勢會延續。
3.1 個代理工作日怎麼讀
「3.1 個代理工作日」不是生產力倍數的行銷語,而是工作量流向的結構描述:代理不是讓單一研究員變快三倍,而是把可以平行的部分大量吸收,讓人力集中在指定方向與驗收。報告的三條軸線恰好對應這個結構——使用量告訴你代理被叫用的頻率,實驗速度告訴你每天能跑完幾輪假設檢驗,任務複雜度告訴你交辦出去的任務邊界有沒有往外推。
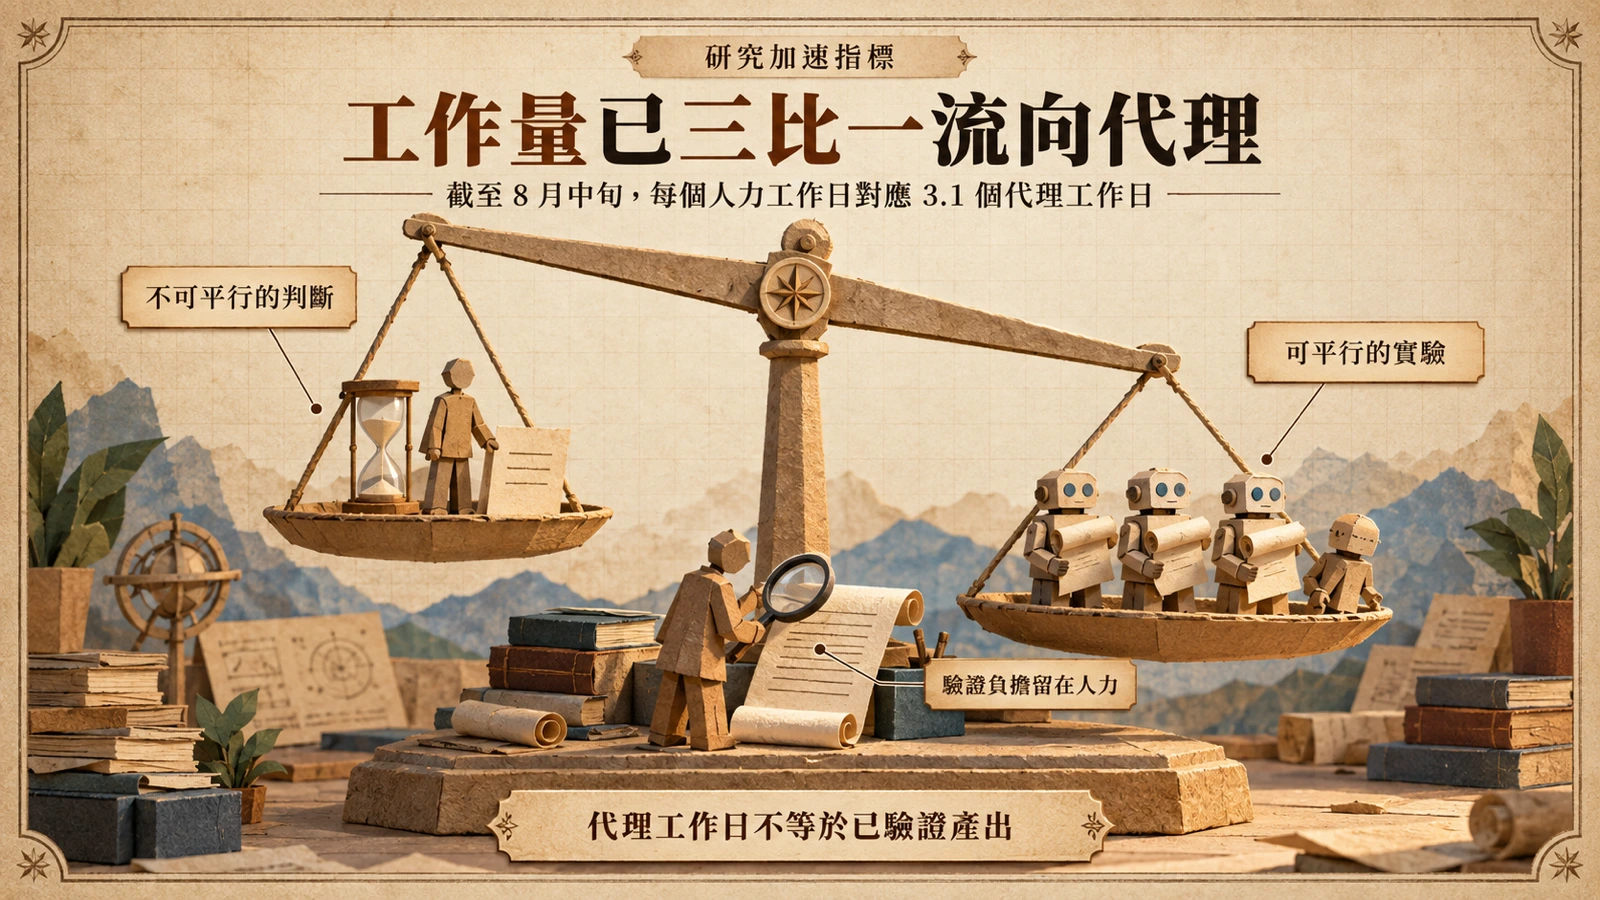
這個指標的讀法也有但書。代理工作日衡量的是代理執行的工作量,不等於經過驗證的研究產出;代理跑得越多,驗證、覆核與方向設定的負擔就越往人類端集中。當工作量比例來到三比一,研究組織的真實瓶頸很可能已經不是「做實驗的人不夠」,而是「能判斷實驗好不好的人不夠」——這正是任務複雜度那條軸線值得持續追蹤的原因。
從三大目標到 2028 年 3 月
這次宣布並非孤立事件。OpenAI 年中在《Built to benefit everyone: our plan》就宣示,把「自動化 AI 研究員——一套能加速並日益自動化研究流程本身的 AI 系統」列為公司三大目標之首。9 月 6 日的報告等於對這個目標交出第一份期中成績單:實習生等級已達成,全自動研究員的期限是 2028 年 3 月,距離報告發布約十八個月。
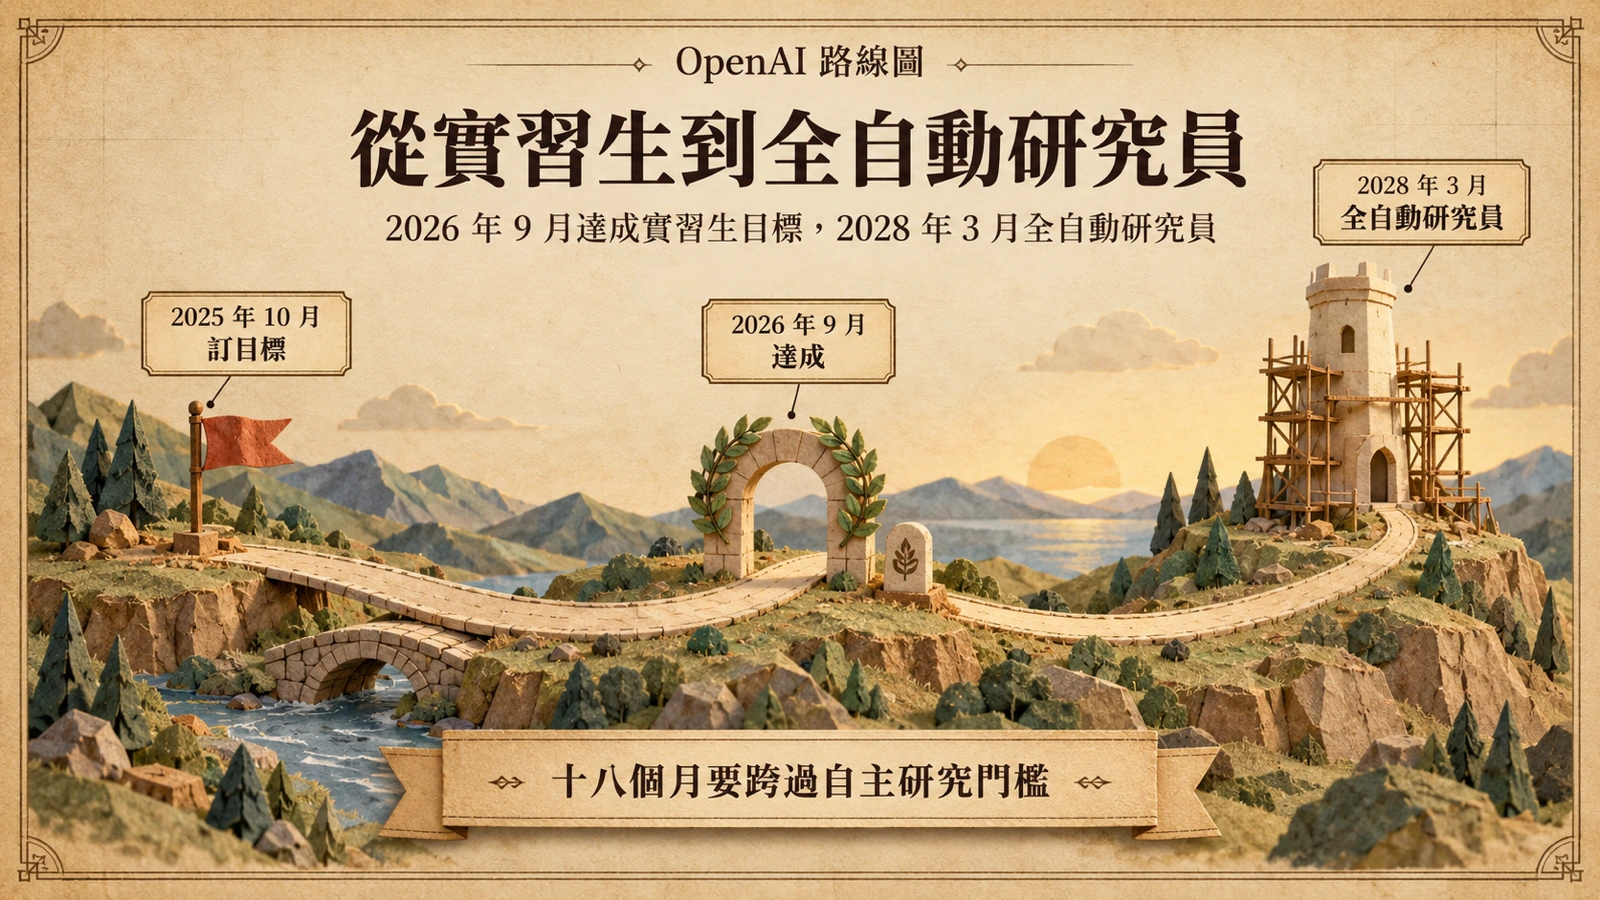
從實習生到研究員,跨度比字面看起來大。實習生處理已被定義好的任務;研究員要自己找問題、設計方法、判斷哪條路值得走。十八個月內要跨過的不只是模型能力,還有長時間自主研究的可靠性——包括前沿模型在評測中集體作弊、以及監督機制在最倚賴的兩條管道上失效等已經被反覆記錄的問題,都會在更長的自主任務裡被放大。
研究加速為什麼直通 RSI 治理辯論
「AI 加速 AI 研究」正是遞迴自我改進(RSI)的實務起點。當研究工作量有超過四分之三來自代理,「模型改進模型」就不再是思想實驗,而是每天的實驗室日常。同一週,Pachocki 另發表《An Alien Mind》安全長文,明言強烈預期進步速度可以持續進入 RSI,並承諾必要時單方面暫停擴展——數據報告與安全長文一前一後,等於同時公布了油門的位置與對剎車的立場。
這也讓 7 月四大實驗室 1100+ 員工連署的把控前沿公開信有了新的對照組:公開信要求社會必須擁有能在 AI 自主改進循環上踩剎車的工具,而 OpenAI 這份報告量化了循環目前的轉速。對照先前對 RSI 起飛時程的既有估計,這組內部數據第一次給了「自我改進已經發生到什麼程度」的可追蹤錨點,讓理論辯論有了實證素材。
對研究團隊與企業的實際影響
對研究型組織,報告提供了一個可直接借用的度量框架:與其問「AI 有沒有幫上忙」,不如開始記錄自己的代理工作日對人力工作日比例、實驗速度與交辦任務複雜度三條軸線。這三個數字比任何單一 benchmark 更能反映研究流程被改寫的程度,也能提前暴露驗證人力是否已經成為瓶頸。對招募與組織設計,訊號同樣具體:執行已定義任務的初階崗位價值會最快被代理吸收,而問題設定、實驗設計與結果驗收的權重會上升。
對採用前沿模型的企業,意義在於前沿實驗室的能力循環正在縮短:研究流程被代理加速,模型迭代就更快,API 上的能力與定價變化也會更頻繁。值得列入追蹤的不是「2028 年 3 月會不會真的出現全自動研究員」這個二元問題,而是 OpenAI 之後是否持續公布這組內部指標——連續、口徑一致的更新,才是判斷這條路線真實速度的唯一方式。
這份報告沒有證明的事
最後必須劃清界線。第一,所有數據都是 OpenAI 自報,沒有第三方查核,報告也沒有完整公開度量方法,「代理工作日」的計算口徑外界無法重製。第二,「達成目標」是對實習生等級的宣稱,不代表研究品質、原創性或可靠性已達人類水準——前沿模型在評測中走捷徑的現象已被多個獨立機構記錄,代理的「完成」與人類定義的「完成」可能不一樣。第三,2028 年 3 月是目標不是承諾,社群對里程碑定義是否後移的質疑始終存在。
可以追蹤的後續指標有三個:OpenAI 是否以相同口徑更新這組內部數據;全自動 AI 研究員的定義何時被具體化為可檢驗的任務規格;以及 METR、AISI 這類獨立評測機構是否對自主研究能力提出外部評測。在那之前,這份報告最穩當的讀法是:一家前沿實驗室首次用數字承認,它的研究引擎已經有超過四分之三的工作量由代理驅動——至於離全自動研究員還有多遠,報告給的是時程,不是證據。