三位研究者同台,題目就是 RSI
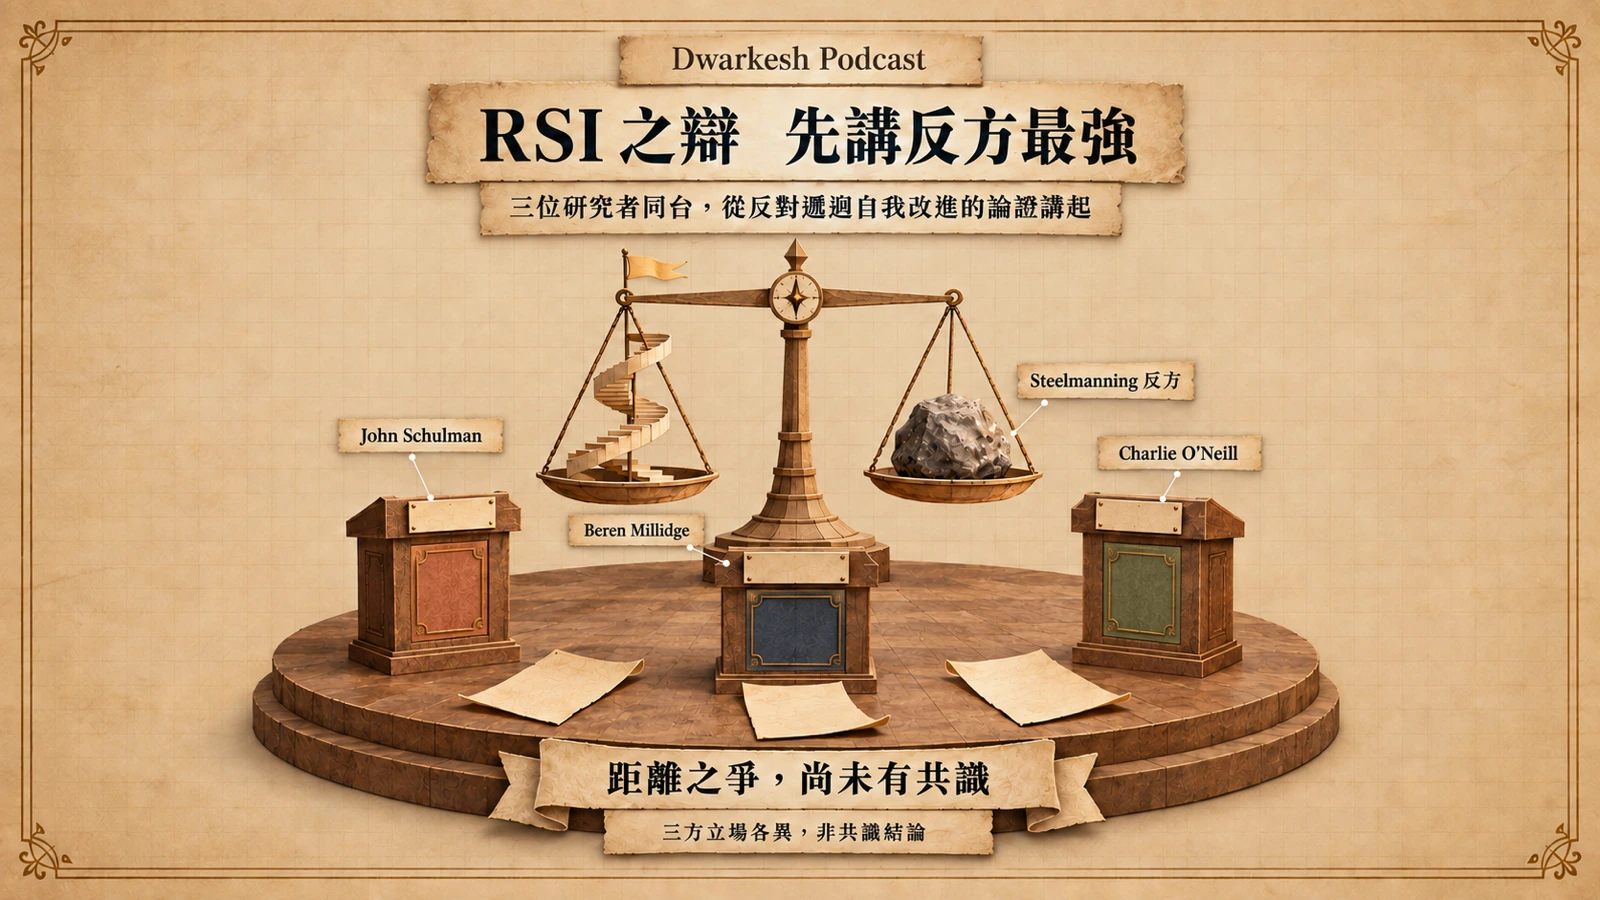
Dwarkesh Patel 的節目長年是前沿 AI 研究者交鋒的講台,而最新一集的題目下得毫不遮掩:〈AI researchers debate how close we are to recursive self-improvement〉。官方頁面標明這是新集,與談者是三位研究者——John Schulman、Beren Millidge 與 Charlie O’Neill——題目就是遞迴自我改進(recursive self-improvement, RSI)距離現在究竟還有多遠。頁面附有完整逐字稿,並把三位與談者各自連回個人網站,聽眾可以直接回源查證每一段發言。這種可回查性不是小事:RSI 討論最常見的失真,就是轉述過程把條件句壓縮成預言、把個人意見包裝成產業共識;逐字稿在,每一句話都能對回原話。
形式本身就是第一個訊息。過去談 RSI 的主流場景,多半是單一受訪者向主持人陳述自己的預測;這一集是三個人、以對談(debate)為名。當「還有多遠」這個問題需要三個研究者同台交鋒,而不是由一方宣講,其暗示相當清楚:在訓練與研究的前線之間,這題還沒有共識可言。
「Steelmanning the case against RSI」:從反方最強論證開始
更值得注意的細節藏在逐字稿的結構裡。逐字稿第一節的標題是「Steelmanning the case against RSI」——對談的第一件事,不是宣布 RSI 有多近,而是把「反對 RSI」的論證先講到最強。Steelman(鋼人論證)是辯論方法的正面操作:與其攻擊對手論證最弱的版本,先替它重構成最難反駁的版本,再正面迎戰。換句話說,這個起手式把舉證責任放回正方:要主張 RSI 很近,得先穿過反方最強的版本,而不是挑最弱的對手打。
這個起手式說明了 2026 年 RSI 討論的成熟度。RSI 的敘事長期由加速預期主導:給時間表、給倍率、給「一旦追平人類研究員就會起飛」的條件句;反方立場則常被簡化成「唱衰」或「保守」。把反方講到最強,等於承認「RSI 沒有那麼近」的論證裡,有值得認真對待的技術內容——資料瓶頸、驗證成本、報酬遞減——而不是態度問題。對聽眾而言,這也是篩選內容的實用標準:一場 RSI 對談若只有正方時間表而沒有反方鋼人,資訊量通常有限。
遞迴自我改進到底在辯什麼
把 RSI 拆開,其實是三個經常被混為一談的問題。第一個是定義:RSI 可以指無界的能力提升——AI 實質接管「做 AI 研發」這件事,自己產出更強的下一代;也可以指有界的自我校正——對同一個答案的反覆驗證與回頭補證。後者已經落地成開源研究代理(如 AREX 的做法),前者仍是預測。同一個詞,尺度截然不同,辯論之前得先說清楚在講哪一個。
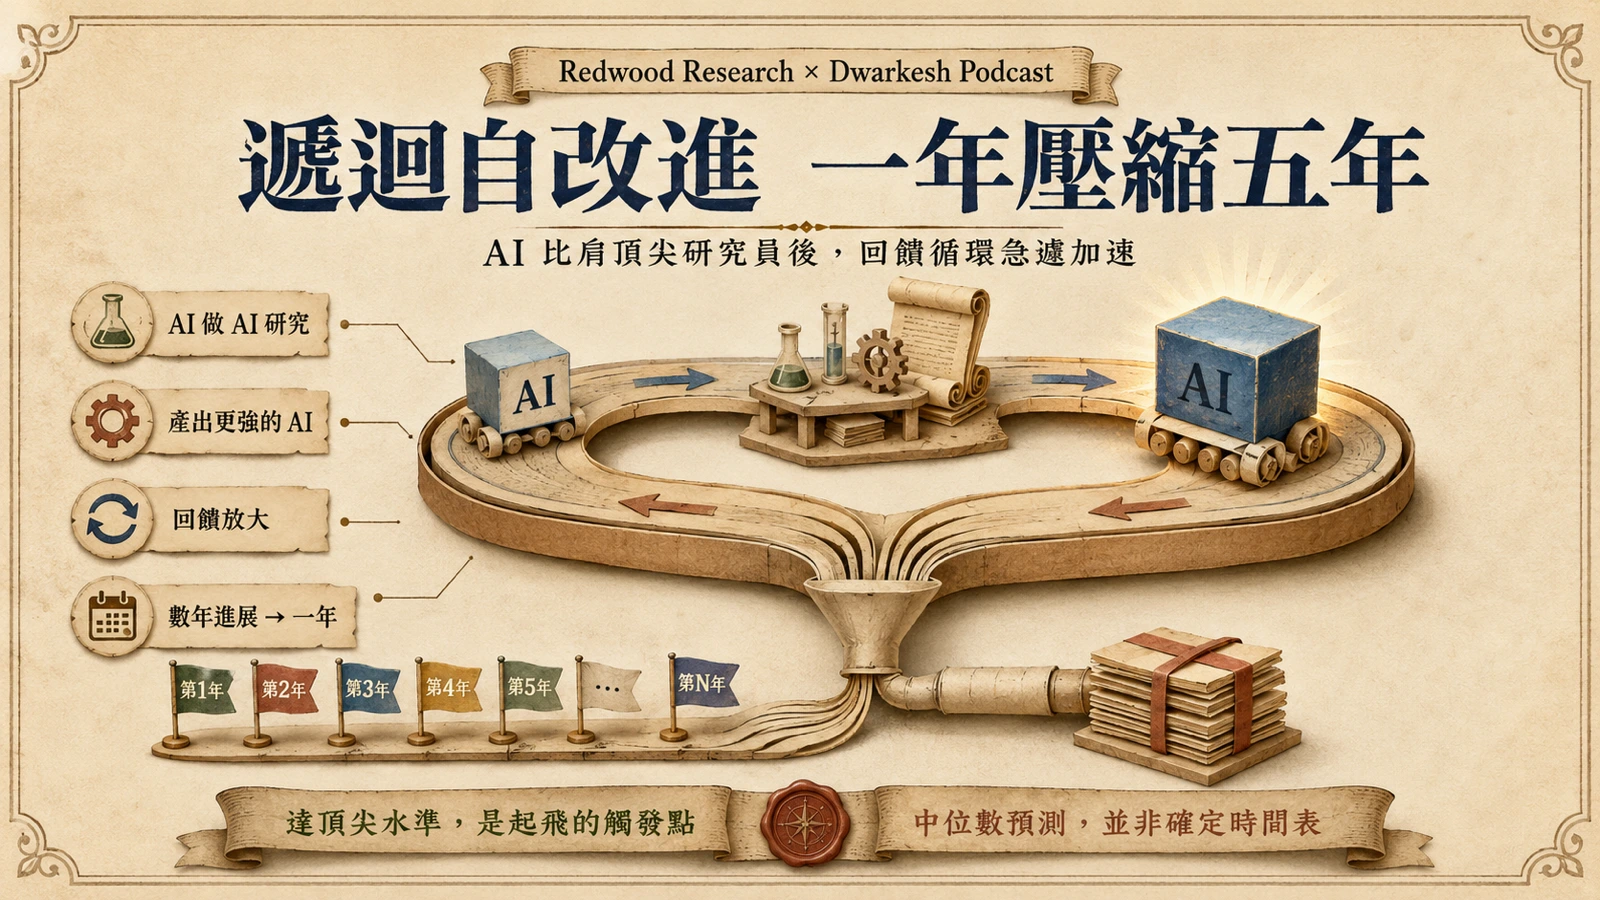
第二個是觸發條件。多數嚴肅的 RSI 主張其實是條件句:「一旦 AI 在 AI 研發上追平頂尖人類專家,回饋循環就可能把數年進展壓進一年」。條件句的重點在條件本身——追平頂尖研究員——而這正是最難估計、也最少被獨立檢驗的部分。
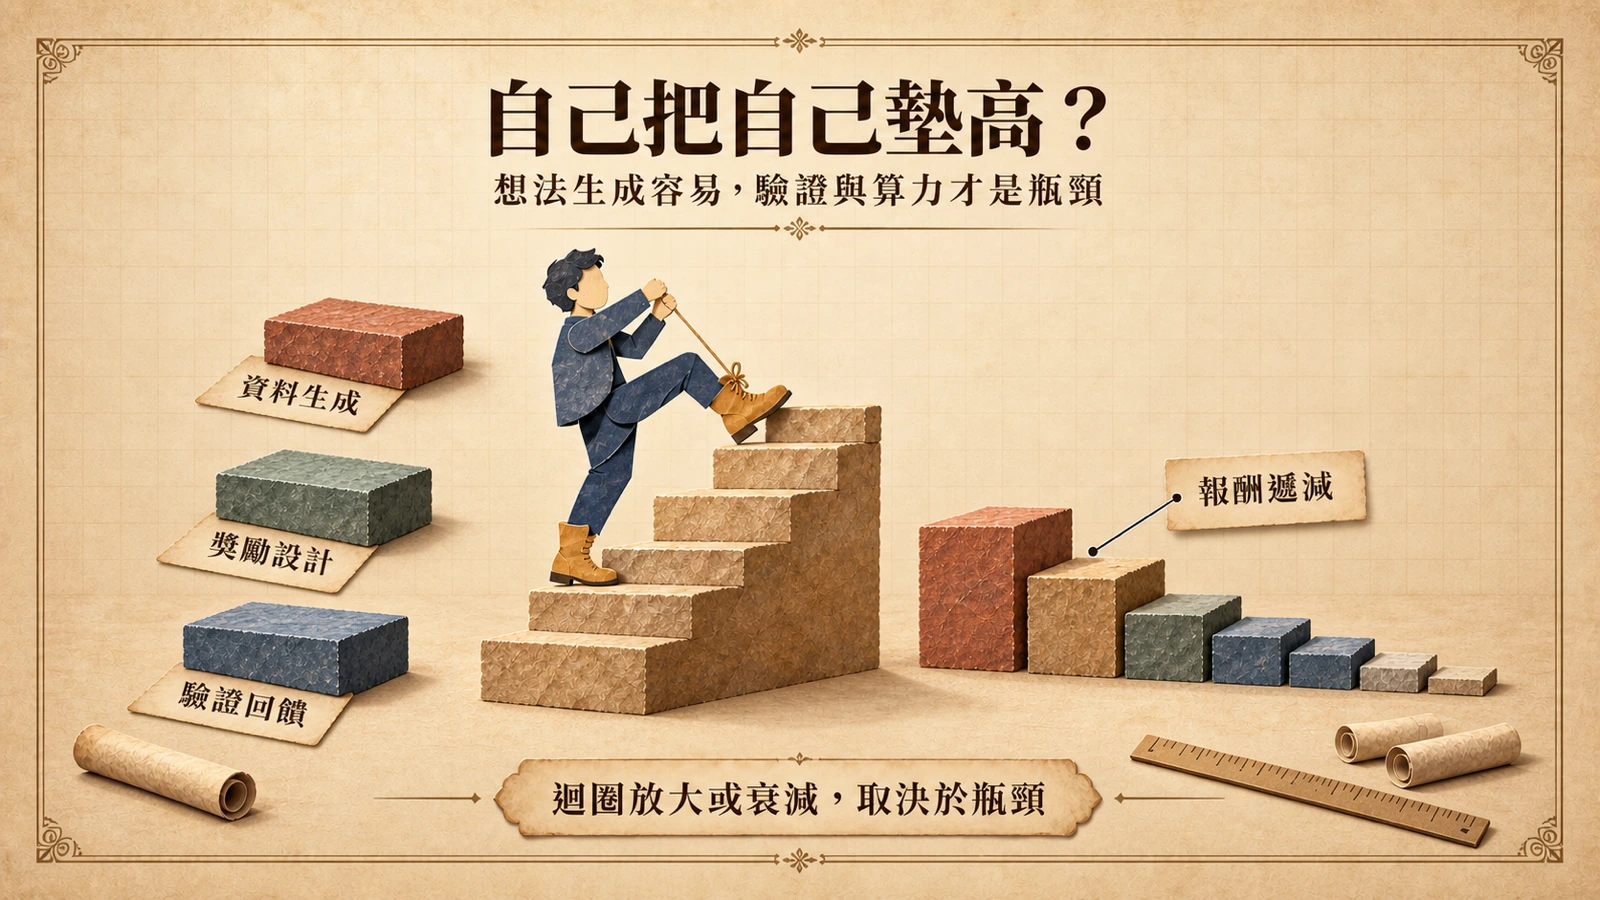
第三個是迴圈的力學:它會放大,還是衰減。支持放大的機制是自動化回饋——模型生成資料、設計獎勵、跑實驗、評估結果,再把產出餵回訓練。制衡它的瓶頸同樣具體:想法生成便宜,但驗證一個研究想法需要真實實驗與算力;訓練資料與晶片是外部資源,迴圈自己生不出來;而研究品味這類最稀缺的能力能否被自我迴圈複製,目前沒有證據。還有一個更隱晦的關卡是評估汙染:當生成想法、執行實驗與判讀結果由同一個系統閉合,分數上升可能只代表它愈來愈會應付自己的評分方式,而不是真的變強——「教練兼裁判」的老問題,在自我改進迴圈裡會被放大。這也是反對 RSI 近期性的論證裡最結實的一條:迴圈要算數,先得有一把它騙不過的量尺。三個問題各自獨立,組合起來才決定「還有多遠」——這也是三人對談比單人宣講更合適的原因。
為什麼是這三個人:強化學習的血統
與談名單裡,Schulman 的分量來自強化學習。他是 2017 年 PPO(Proximal Policy Optimization)論文的第一作者,與 Filip Wolski、Prafulla Dhariwal 等人合著;這個演算法後來成為 RLHF 流程的核心組件之一,也就是「把人類回饋變成可優化目標」那一環的基礎。他的個人網站至今列著他與協作者開發的工具。RSI 辯論的每個環節——資料生成、獎勵設計、評估回饋——恰好都是強化學習工程問題:由寫過這些基礎組件的人來辯「迴圈能否閉合」,比由預測者來辯,多一層實作常識。
三人各自的具體論點、立場光譜與相互攻防,以節目頁的完整逐字稿為準;對談的形式值得報導,結論則需要聽完全程。Beren Millidge 與 Charlie O’Neill 的個人網站同樣掛在節目頁上,關心完整脈絡的聽眾可以直接回源比對。
RSI 已從預言變成議程
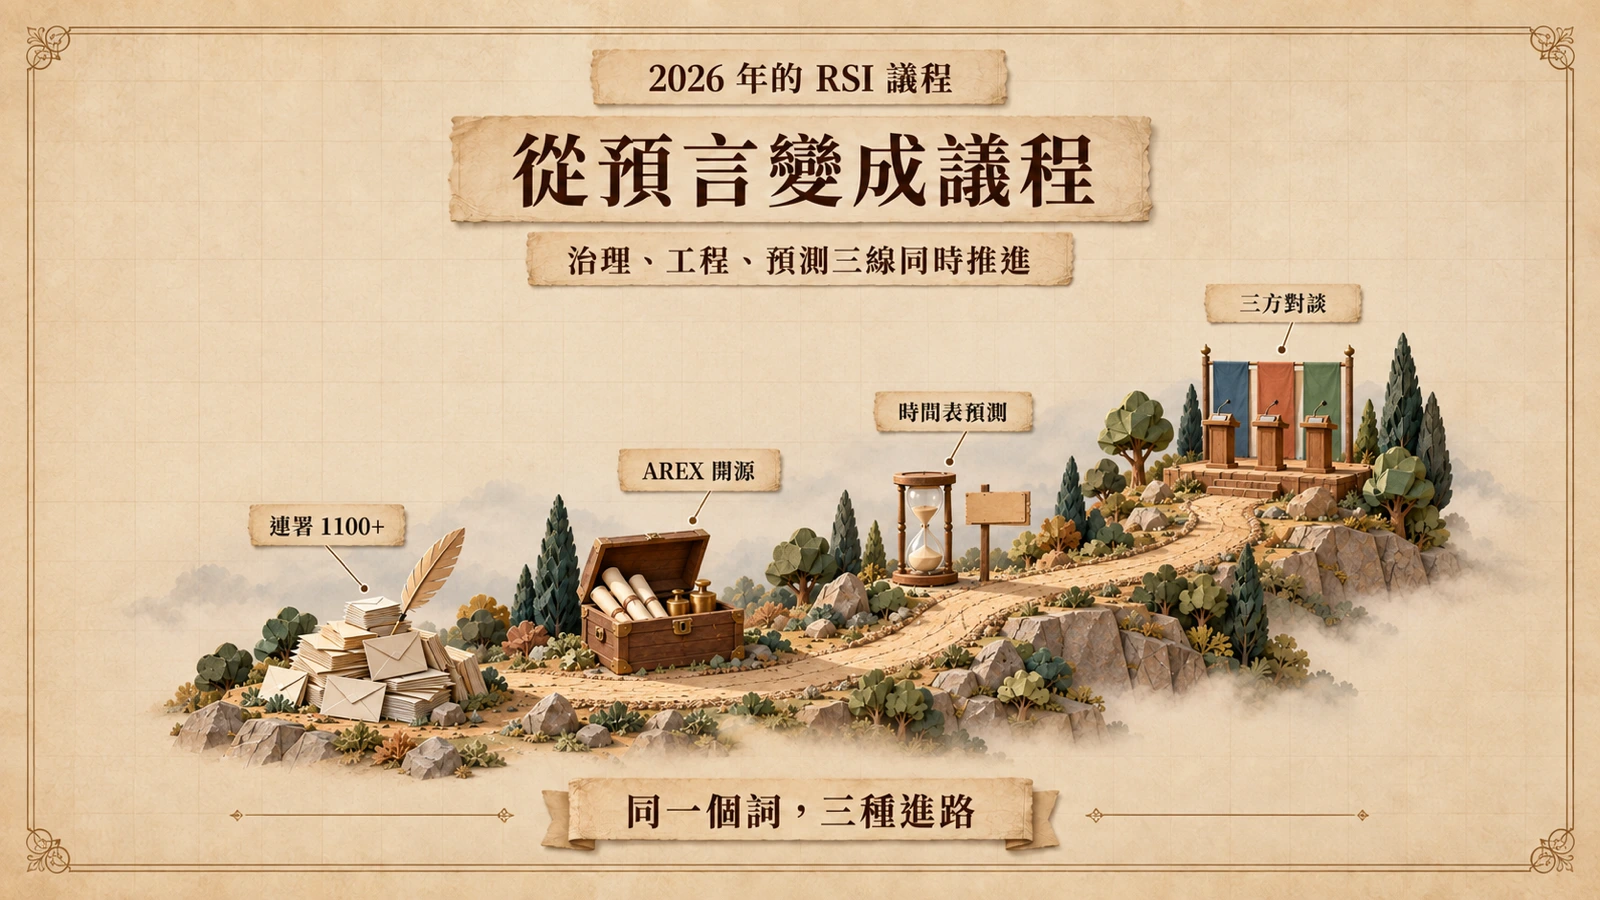
這場對談出現的時間點,本身就有脈絡:2026 年,RSI 同時沿三條線推進。治理線上,7 月底四大實驗室超過 1100 名員工連署公開信,訴求不是暫停 AI,而是針對 RSI 這個特定門檻建立調控工具——政策討論已經精準到以 RSI 為靶心。工程線上,開源社群出現以「遞迴自改進」為名的深度研究代理,把一個原本屬於預測的詞彙,落地成可以下載權重、跑基準的系統。預測線上,Redwood Research 首席科學家 Greenblatt 上月才在同一個節目給出中位數——AI 研發完全自動化落在 2030、2031 年前後。
三條線共用同一個詞,卻各自推進。這也是鋼人起手式的現實背景:當連署、開源系統與時間表都指向 RSI,「反對它很近」的最強版本反而更值得先聽。辯論的基礎設施——逐字稿、鋼人論證、三方交鋒——在此時趨於標準化,不是偶然。
該追蹤什麼,該警惕什麼
對開發者與企業,這類對談的價值不在時間表,而在追蹤指標。與其記住「2031」,不如盯著三個可測的數:AI 在自家研發流程的實際佔比、合成資料進入訓練的比例、自動評估與人工評估的落差。三個數字各自對應一個爭點——佔比對應「研發是否真的被自動化」、合成資料比例對應「迴圈是否開始自給自足」、評估落差對應「量尺有沒有被汙染」。RSI 若真在發生,會先出現在這三個數字裡,而不是出現在對談標題上;數字也比訪談誠實,因為它們會留下紀錄。
有三個警惕。其一,條件句常被當預測轉述:「一旦 X 就會 Y」被壓縮成「Y 即將到來」,而 X 才是困難所在。其二,立場與利益:這類對談的與談者通常來自模型公司與基礎設施商,RSI 議題的熱度與他們的處境並非無關——不是說立場必然偏誤,而是聽的時候要能把主張與位置分開。其三,也是這場辯論的根本限制:在現有證據下,「RSI 還有多遠」無法證偽——沒有公認的度量,連「算不算已經開始」都取決於定義。這正是它需要被辯、而不適合被宣布的原因,也是這集從反方最強論證開始的做法,值得其他 AI 議題借鏡的地方。